

Качество данных: стандартизация и нормализация
Качество данных является основой любого надежного аналитического проекта, особенно в контексте расчета величины CLTV (Customer Lifetime Value). Классический анализ клиентоориентированных метрик строится на данных из множества источников: CRM-систем, систем продаж и поддержки, веб-аналитики, платежных сервисов, маркетинговых платформ и т. д. Если данные в этих системах не согласованы по формам, единицам измерения, временным меткам и характеристикам клиентов, результаты расчета CLTV будут искажены, а решения руководства — нереалистичны. Поэтому глава посвящена двум взаимосвязанным задачам: стандартизации данных (когда мы приводим данные к единой семантике и единым правилам сигнатур сущностей) и нормализации данных (когда мы приводим данные к концептуально однородному формату, удаляем дубликаты, приводим значения к единому масштабу). В рамках курса мы рассмотрим теоретические основы, методологии и практические примеры, опишем инструменты и подходы как из открытого источника, так и российских решений, обсудим риски и ограничения внедрения, а также дадим практические рекомендации по интеграции этих процессов в ваш процесс расчета CLTV.
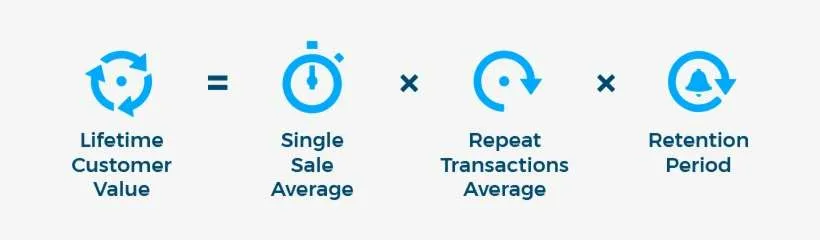
Что такое качество данных и почему оно критично для CLTV
Качество данных — совокупность характеристик данных, которые определяют их пригодность для конкретной цели. Для расчета CLTV это особенно важно, потому что CLTV чувствителен к точности и полноте входных данных: объем покупок, дата каждой транзакции, валюта, валидность полей клиента, связь между клиентом и транзакцией, временные паттерны поведения и пр. Низкое качество данных приводит к искажению иллюзий поведения клиентов, например, к неверной среднеквартальной частоте покупок, неправильной марже или завышенному/заниженному сроку жизни клиента.
Основные измерения качества данных
- Точность (accuracy): насколько значения соответствуют реальности. Например, правильный email-адрес, корректный номер телефона, верный идентификатор клиента.
- Полнота (completeness): наличие необходимых полей, отсутствие пропусков в критических атрибутах клиентов и сделок.
- Согласованность (consistency): согласованность между данными из разных источников, например, одинаковые коды регионов или единицы измерения в различных системах.
- Валидность (validity): соответствие данных бизнес-правилам и формату, например, корректные даты, валидные коды валют.
- Своевременность/актуальность (timeliness): насколько данные отражают актуальное состояние; задержки загрузки, устаревшие события.
- Уникальность (uniqueness): отсутствие дубликатов сущностей, например одного клиента с двумя различными идентификаторами.
- Доступность/объем данных (availability/volume): устойчивость к росту объема и доступность данных для анализа.
Стандартизация против нормализации
- Стандартизация данных — приведение семантики к единому стандарту: единицы измерения, форматы дат, правила именования, нормализация имен полей, единый словарь атрибутов и кодов. Это обеспечивает однозначную интерпретацию данных в рамках всего портфеля источников.
- Нормализация данных — структурирование данных так, чтобы устранить избыточность и привести их к каноническим формам внутри хранилища: унификация кодов объектов, приведение к нормализованной схеме хранения (например, создание отдельных таблиц измерений и фактов, внедрение суррогатных ключей, приведение бизнес-правил к единым формулам конверсий).
Каноническая модель данных и управление семантикой
Каноническая модель данных (canonical data model) — это согласованный набор сущностей, атрибутов и связей, который представляет стандартную форму наиболее часто встречающихся бизнес-объектов. Для CLTV в канонической модели особое внимание уделяется следующим объектам: клиенты (customer), события/сделки (transaction), товары/услуги (product), временная размерность (time), валюта и стоимость (amount, currency, margin). Наличие канонической модели позволяет делать конвергенцию данных из разных систем в единую семантику, что существенно снижает риск ошибок при расчете CLTV и облегчает сопоставления между периодами и сегментами.
Методы и методологии реализации качества данных
- Data profiling (профилирование данных): начальная оценка качества по набору характеристик, идентификация пропусков, несоответствий и аномалий.
- Data cleansing (очистка данных): удаление или исправление ошибок, нормализация форматов, приведение значений к нормативной шкале.
- Data standardization (стандартизация): приведение сущностей к общему словарю и единицам измерения.
- Data normalization / canonicalization (нормализация): приведение данных к канонической форме, устранение дублирующих записей и согласование моделей.
- Data quality rules and governance (правила качества и управление): формирование набора правил, метрик, процедур аудита, ролей ответственных за качество.
- Data lineage and metadata management (линейность данных и управление метаданными): отслеживание происхождения данных, чтобы понять, как и откуда приходят значения, и как они трансформируются на каждом этапе пайплайна.
- Data quality frameworks (DAMА-DMBOK, ISO 8000): использование принятых стандартов и руководств для систематической организации процессов качества данных.
Роль контроля качества в процессе расчета CLTV
Качество входящих данных определяет точность моделей расчета CLTV и управляемость ключевых факторов: маржа, сумма заказов, частота покупок, клиентоорбатываемость. Улучшение качества данных позволяет сократить искажения, повысить доверие к аналитике и поддержать устойчивые управленческие решения в отношении клиентских стратегий, ценообразования и каналов взаимодействия.
Практические примеры
Сценарий интеграции данных из нескольких источников для CLTV
Представим, что у вас есть три основных источника данных: CRM-система, платформа онлайн-магазина и система поддержки клиентов. В CRM хранятся данные о клиентах и их ролях, в онлайн-магазине — данные о транзакциях и корзинах, в системе поддержки — взаимодействия и обращения клиентов. Каждый источник использует свои форматы идентификаторов клиентов, валюты и временные метки. В рамках проекта по расчета CLTV нам нужно привести данные к единой семантике и канонической форме:
- Стандартизируем идентификаторы клиентов: приводим к каноническому ключу customer_key и сохраняем сопоставления между различными source_id через таблицу соответствий.
- Стандартизируем валюти: выбираем базовую валюту (например, RUB или USD) и конвертируем все суммы по курсам на дату транзакции, используя конвертацию к дате сделки.
- Нормализуем даты и временные зоны: приводим все временные метки к UTC и выбираем единый уровень агрегации (например, месячные периоды).
- Приводим к единой системе категорий и справочников: объединяем коды регионов, сегменты клиентов и типы сделок через общие справочники.
- Очистка и дедупликация: выявляем дубликаты клиентов по нескольким source_id и объединяем их под одним customer_key, используя правила сопоставления на основе имён, адресов электронной почты и телефонов.
Применение данных качества в расчете CLTV
После того как данные приведены к единой канонической форме, расчеты CLTV можно выполнять на основе согласованных факторов. Например, расчет клиентоориентированной ценности можно строить так: CLTV = сумма (прибыль по каждому месяцу) для каждого клиента на протяжении заданного окна времени, умноженная на коэффицент удержания и корректируемая по рискам. Если у вас были пропуски в данных о количестве покупок за конкретный месяц или марже, то без должной обработки эти месяцы будут приводить к занижению или завышению CLTV. Поэтому на этапе подготовки данных важно внедрить правила заполнения пропусков, корректную обработку нулевых значений и проверки консистентности между полями.
Примеры инструментов и практических подходов
- Open-source: Great Expectations для декларативного описания правил качества и их выполнения в пайплайне; dbt для управления трансформациями и реализации консистентности на уровне SQL; Apache Spark или Apache Flink для больших наборов данных; Apache NiFi для потоковой интеграции и подготовки данных; Airflow/Prefect для оркестрации заданий и контроля исполнения пайплайнов.
- Российские решения: для интеграции и подготовки данных часто применяются 1C:Enterprise в связке с сервисами выгрузки данных из 1C и сторонних систем; Яндекс.Облако и СберОблако предлагают решения для аналитики и обработки данных в рамках российского сегмента, включая DataSphere/DataLens, инструменты для хранения и визуализации, а также сервисы для организации пайплайнов и контроля качества данных. Для управления метаданными и линейностью данных можно применять открытые решения с локализацией и настройкой под требования российского регулирования, интегрированные с локальными системами учета и финансового учета.
Пример технического сценария внедрения
- Этапы: планирование и моделирование канонической модели, сбор требований к качеству данных, проектирование словаря и правил конверсии, выбор инструментов, реализация пайплайна, внедрение метрик качества, мониторинг, аудит и управление изменениями.
- Роли: дата-ответственный за качество (Data Steward), владелец данных (Data Owner), инженер по данным (Data Engineer), аналитик CLTV.
- Метрики качества: доля пропусков, доля ошибок конверсии валют, доля повторяемых записей в ключевых измерениях, количество пропущенных значений в критических атрибутах клиентов, доля транзакций с некорректными датами.
- Контроль качества в пайплайне: на входе профилирование данных, на промежуточном этапе очистка и стандартизация, на финальном этапе хранение в канонической модели и подготовка к расчету CLTV. В рамках этого цикла применяются правила в Great Expectations или аналогичных системах, создаются тесты на уникальность ключей, валидацию форматов и корректность конверсий валют.
Примерный архитектурный шаблон
- Источники данных: CRM, онлайн-магазин, служба поддержки, платёжные сервисы, внешние маркетинговые платформы.
- Путь данных: источники — ETL/ELT слои — каноническая модель/модель данных DWH — слой аналитики CLTV.
- Каноническая модель: таблица фактов продаж (fact_sales) со связями к таблицам измерений: dim_customer, dim_time, dim_currency, dim_product; хранится в DWH или на дата-лейке в зависимости от объема данных.
- Инструменты: Python/SQL-скрипты для трансформаций; dbt для SQL-трансформаций; Great Expectations для тестирования качества; Airflow/Prefect для оркестрации; 1C и Яндекс/Сбер облака как источники и платформы для хранения.
- Контроль качества: регулярные проверки на полноту, точность, согласованность; линейность данных — отслеживание источников, изменений и зависимостей; дашборды для мониторинга качества и CLTV.
Архитектура данных и моделирование
- Архитектура должна опираться на разумную схему звезды или снежинки (star/snowflake) с каноническим слоем для клиентов (dim_customer) и временным измерением (dim_time). Фактовые таблицы (fact_sales, fact_interactions) содержат показатели финансовой и поведенческой активности, необходимые для расчета CLTV.
- В канонической модели клиенты связываются через surrogate keys (customer_key), что упрощает агрегацию и последующую очистку данных.
- Валидация единиц измерения и валют осуществляется в рамках слоя трансформаций: все суммы конвертируются в базовую валюту по курсам на дату транзакции или по курсам на конкретный период, чтобы периоды можно было сравнивать.
Стандартизация и нормализация в конвейере данных
- Идентификаторы клиентов: реализуется сопоставление source_id к canonical customer_id на основе правил сопоставления (совпадение имени, электронной почты, телефона и адреса). В случае неоднозначности используются дополнительные признаки и ручная верификация.
- Единицы измерения и валюты: приводим к одной валюте (например, RUB или USD) и единицам длины/масштаба, если они присутствуют в данных. Для CLTV важно, чтобы денежные показатели были сопоставимы между источниками.
- Форматы дат и временных зон: перевод всех временных меток в единый часовой пояс (обычно UTC) и применение фиксированного уровня детализации времени (например, месяц/квартал).
- Стандартизированные справочники: коды регионов, товары, категории и т. п. приводятся к общему набору значений по централизованному словарю.
- Уникальность и дедупликация: после кросс-системной интеграции создаются правила для устранения дубликатов клиентов, товаров, транзакций.
Правила качества и тестирование
Правила должны быть определены заранее и реализованы в рамках пайплайна. Например:
- customer_key не может быть null; source_id должен существовать в источнике.
- email должен соответствовать формату электронной почты.
- phone должен быть приведен к формату E.164.
- currency присутствует в списке допустимых валют; amount > 0.
- transaction_date должна быть валидной датой и не позже текущей даты.
- уникальность комбинации (customer_key, transaction_id) в фактах продаж.
Мониторинг и аудит: внедряем датасет-метрики (DQM) и дашборды, чтобы отслеживать пропуски, несоответствия и отклонения по времени.
Безопасность, соответствие требованиям и хранение данных
- Обязательно реализуйте защиту персональных данных: маскирование чувствительных полей, контроль доступа по ролям, аудит операций на данных, минимизацию копий и ограничение переноса PII между системами.
- Регулирования: соблюдайте требования российского законодательства о локализации данных, хранения персональных данных и передачи данных за пределы страны, если это необходимо. При этом учитывайте требования к кибербезопасности и аудита.
- Контроль версий схем и метаданных, чтобы изменения в канонической модели и справочниках не нарушали существующие пайплайны.
Инструменты и практические настройки
- Open-source: Great Expectations (правила качества и тесты), dbt (управление трансформациями и зависимостями), Apache Airflow/Prefect (оркестрация), Apache Spark (масштабная обработка), Apache NiFi (потоковая интеграция), OpenLineage/Amundsen (слежение за lineage и каталог данных).
- Российские и локальные решения: 1C:Enterprise для интеграции с российскими ERP-системами; Яндекс.Облако DataSphere/DataLens для хранения и визуализации данных с поддержкой локальных требований; СберОблако и другие локальные сервисы для аналитики и управления данными в рамках российской инфраструктуры.
- Примеры практик по настройке: создание тестовых данных для проверки правил конверсии валют, нормализации идентификаторов и порядка при последовательных загрузках; настройка репликации и инкрементальных загрузок для устойчивости к росту объема данных.
Риски и ограничения внедрения
- Риск несовпадения источников: данные из разных систем могут содержать противоречивые значения или неполные поля, что приводит к неопределенности при сопоставлении и формированию канонической модели.
- Риск долговременной поддержки канонической модели: слишком детальная каноническая модель может усложнить пайплайн и увеличить стоимость поддержки; наоборот, слишком упрощенная модель может не отражать потребности аналитики CLTV.
- Риск обработки больших объемов данных: стандартизация и нормализация могут потребовать значительных вычислительных ресурсов, особенно при конверсиях валют и профилировании больших наборов записей.
- Риск ошибок в конверсиях валют и курсовых данных: неверные курсы на дату транзакции приводят к искажению CLTV.
- Риск регуляторного и юридического характера: обработка персональных данных и соответствие требованиям законодательства, а также ограничения на передачу данных за пределы РФ.
- Управленческие риски: вовлеченность команд, сроки внедрения, согласование ролей и ответственности за качество данных.
Качество данных — это не одноразовый этап, а непрерывный процесс, который начинается с планирования канонической модели и правил конверсии, продолжается профилированием, очисткой, стандартизацией и нормализацией, и заканчивается постоянным мониторингом и управлением качеством данных в рамках процессов расчета CLTV. Эффективная реализация требует сочетания теоретических основ с практическими инструментами и подходами: каноническая модель обеспечивает единую семантику, а нормализация позволяет сравнивать данные между источниками и периодами. Внедрение должно учитывать риски, требования к безопасности и соответствию локальным законам, а также обеспечивать возможность масштабирования по мере роста объема данных и усложнения бизнес-логики. В результате вы получаете надежную основу для точного и устойчивого расчета CLTV, которая повышает доверие к аналитике, улучшает качество управленческих решений и поддерживает стратегические инициативы по работе с лояльными клиентами.
Вопрос–Ответ (FAQ)
1) Что такое стандартизация данных и зачем она нужна при расчете CLTV?
Ответ: Стандартизация данных — это приведение различных данных к общим правилам семантики и форматов: единицы измерения, форматы дат, наименования полей и справочников. Это необходимо для CLTV, потому что различные источники часто используют разные форматы и терминологию. Без стандартизации агрегированные показатели CLTV будут некорректно сравниваться между источниками и периодами, что приведет к неверным управленческим выводам.
2) Что такое нормализация данных и как она связана с канонической моделью?
Ответ: Нормализация — это приведение данных к канонической форме внутри хранилища: устранение дублирования, унификация кодов, приведение значений к единым форматам и реализация связей между сущностями. Каноническая модель служит единым языком для всех источников и позволяет правильно объединять данные для расчетов CLTV.
3) Какие метрики качества данных наиболее важны для CLTV?
Ответ: Точность, полнота, согласованность, валидность, своевременность и уникальность. Для CLTV особенно критичны полнота и точность торговых данных (заказы, суммы, валюта, даты), корректность идентификаторов клиентов и отсутствие дубликатов, а также согласование курсов валют и временных меток.
4) Какие инструменты можно использовать в открытом источнике для реализации процессов качества данных?
Ответ: Great Expectations для описания и проверки правил качества, dbt для управляемых трансформаций и конвейеров, Apache Spark для обработки больших объемов данных, Apache NiFi для потоковой интеграции, Airflow или Prefect для оркестрации задач, Amundsen или OpenLineage для управления линейностью и каталогами данных.
5) Какие российские решения подходят для внедрения в рамках локальных требований?
Ответ: 1C:Enterprise для интеграции с российскими системами учета; Яндекс.Облако (DataSphere, DataLens) для данных внутри российской инфраструктуры; СберОблако и другие локальные облачные сервисы для хранения, обработки и визуализации данных. Также можно использовать локальные версии открытых инструментов с соответствующим лицензированием и поддержкой.
6) Как избежать рисков при внедрении процессов качества данных?
Ответ: Начинать нужно с четко сформулированной канонической модели и набора правил качества, определить ответственных за данные, внедрить профилирование и тесты на входе пайплайна, настроить мониторинг качества, обеспечить аудируемость изменений и соответствие требованиям регуляторов. Важно также планировать поэтапное внедрение и минимизировать риск чрезмерной сложности канонической модели.
7) Какие сложности могут возникнуть при расчете CLTV после внедрения стандартизации и нормализации?
Ответ: Возможны сложности в сочетании данных из разных источников, задержки в загрузке данных, необходимость поддержания двух режимов: исторических и текущих данных, а также постоянная работа над поддержанием словарей и справочников в актуальном состоянии. Важна автоматизация обновления курсов валют и обновления правил обработки пропусков.
8) Какой подход выбрать — ELT или ETL для реализаций в рамках CLTV?
Ответ: В большинстве современных сценариев CLTV выгоднее ELT: данные сначала загружаются в хранилище и затем трансформируются внутри него с использованием мощности целевой платформы. Это позволяет гибко управлять трансформациями, темпом загрузок и качеством данных, а также упрощает масштабирование по мере роста объема данных.
9) Как проверить, что каноническая модель удовлетворяет потребностям бизнеса?
Ответ: Нужно провести аудит по нескольким направлениям: соответствие бизнес-правилам и словарю, полноту и точность данных в каноническом слое, корректность связей между сущностями, способность покрывать сценарии расчета CLTV на разных периодах, а также возможность расширения модели под новые источники без значительных переработок пайплайна.
10) Как интегрировать мониторинг качества данных в процесс расчета CLTV?
Ответ: Встроить проверки качества в каждую стадию пайплайна: на входе — профилирование и базовые проверки, в промежуточных этапах — очистка и нормализация, на выходе — подготовка канонической модели и подготовка данных для CLTV. Добавить дашборды, показывающие пропуски, ошибки конверсии, уникальность ключей, задержки загрузки и влияние на показатели CLTV. Регулярно обновлять тесты и правила на основе изменений в источниках и требованиях бизнеса.


