

Цели и рамки проекта CVM Maximization
Цели и рамки проекта CVM Maximization являются фундаментом для успешного внедрения подходов управления ценностью клиентов в рамках курса «Курс Использование BI и DWH при внедрении Customer Value Management Maximization CVM». Эта глава призвана помочь новому сотруднику понять, зачем нужен CVM, какие задачи ставятся, каковы границы проекта, какие методологии применяются и какие инструменты—как открытого исходного кода, так и российских решений—могут быть задействованы на практике. Мы обсудим концепции, термины, архитектуру данных, процессы анализа и принятия решений, а также риски и ограничения, с которыми вам предстоит столкнуться на этапе внедрения.
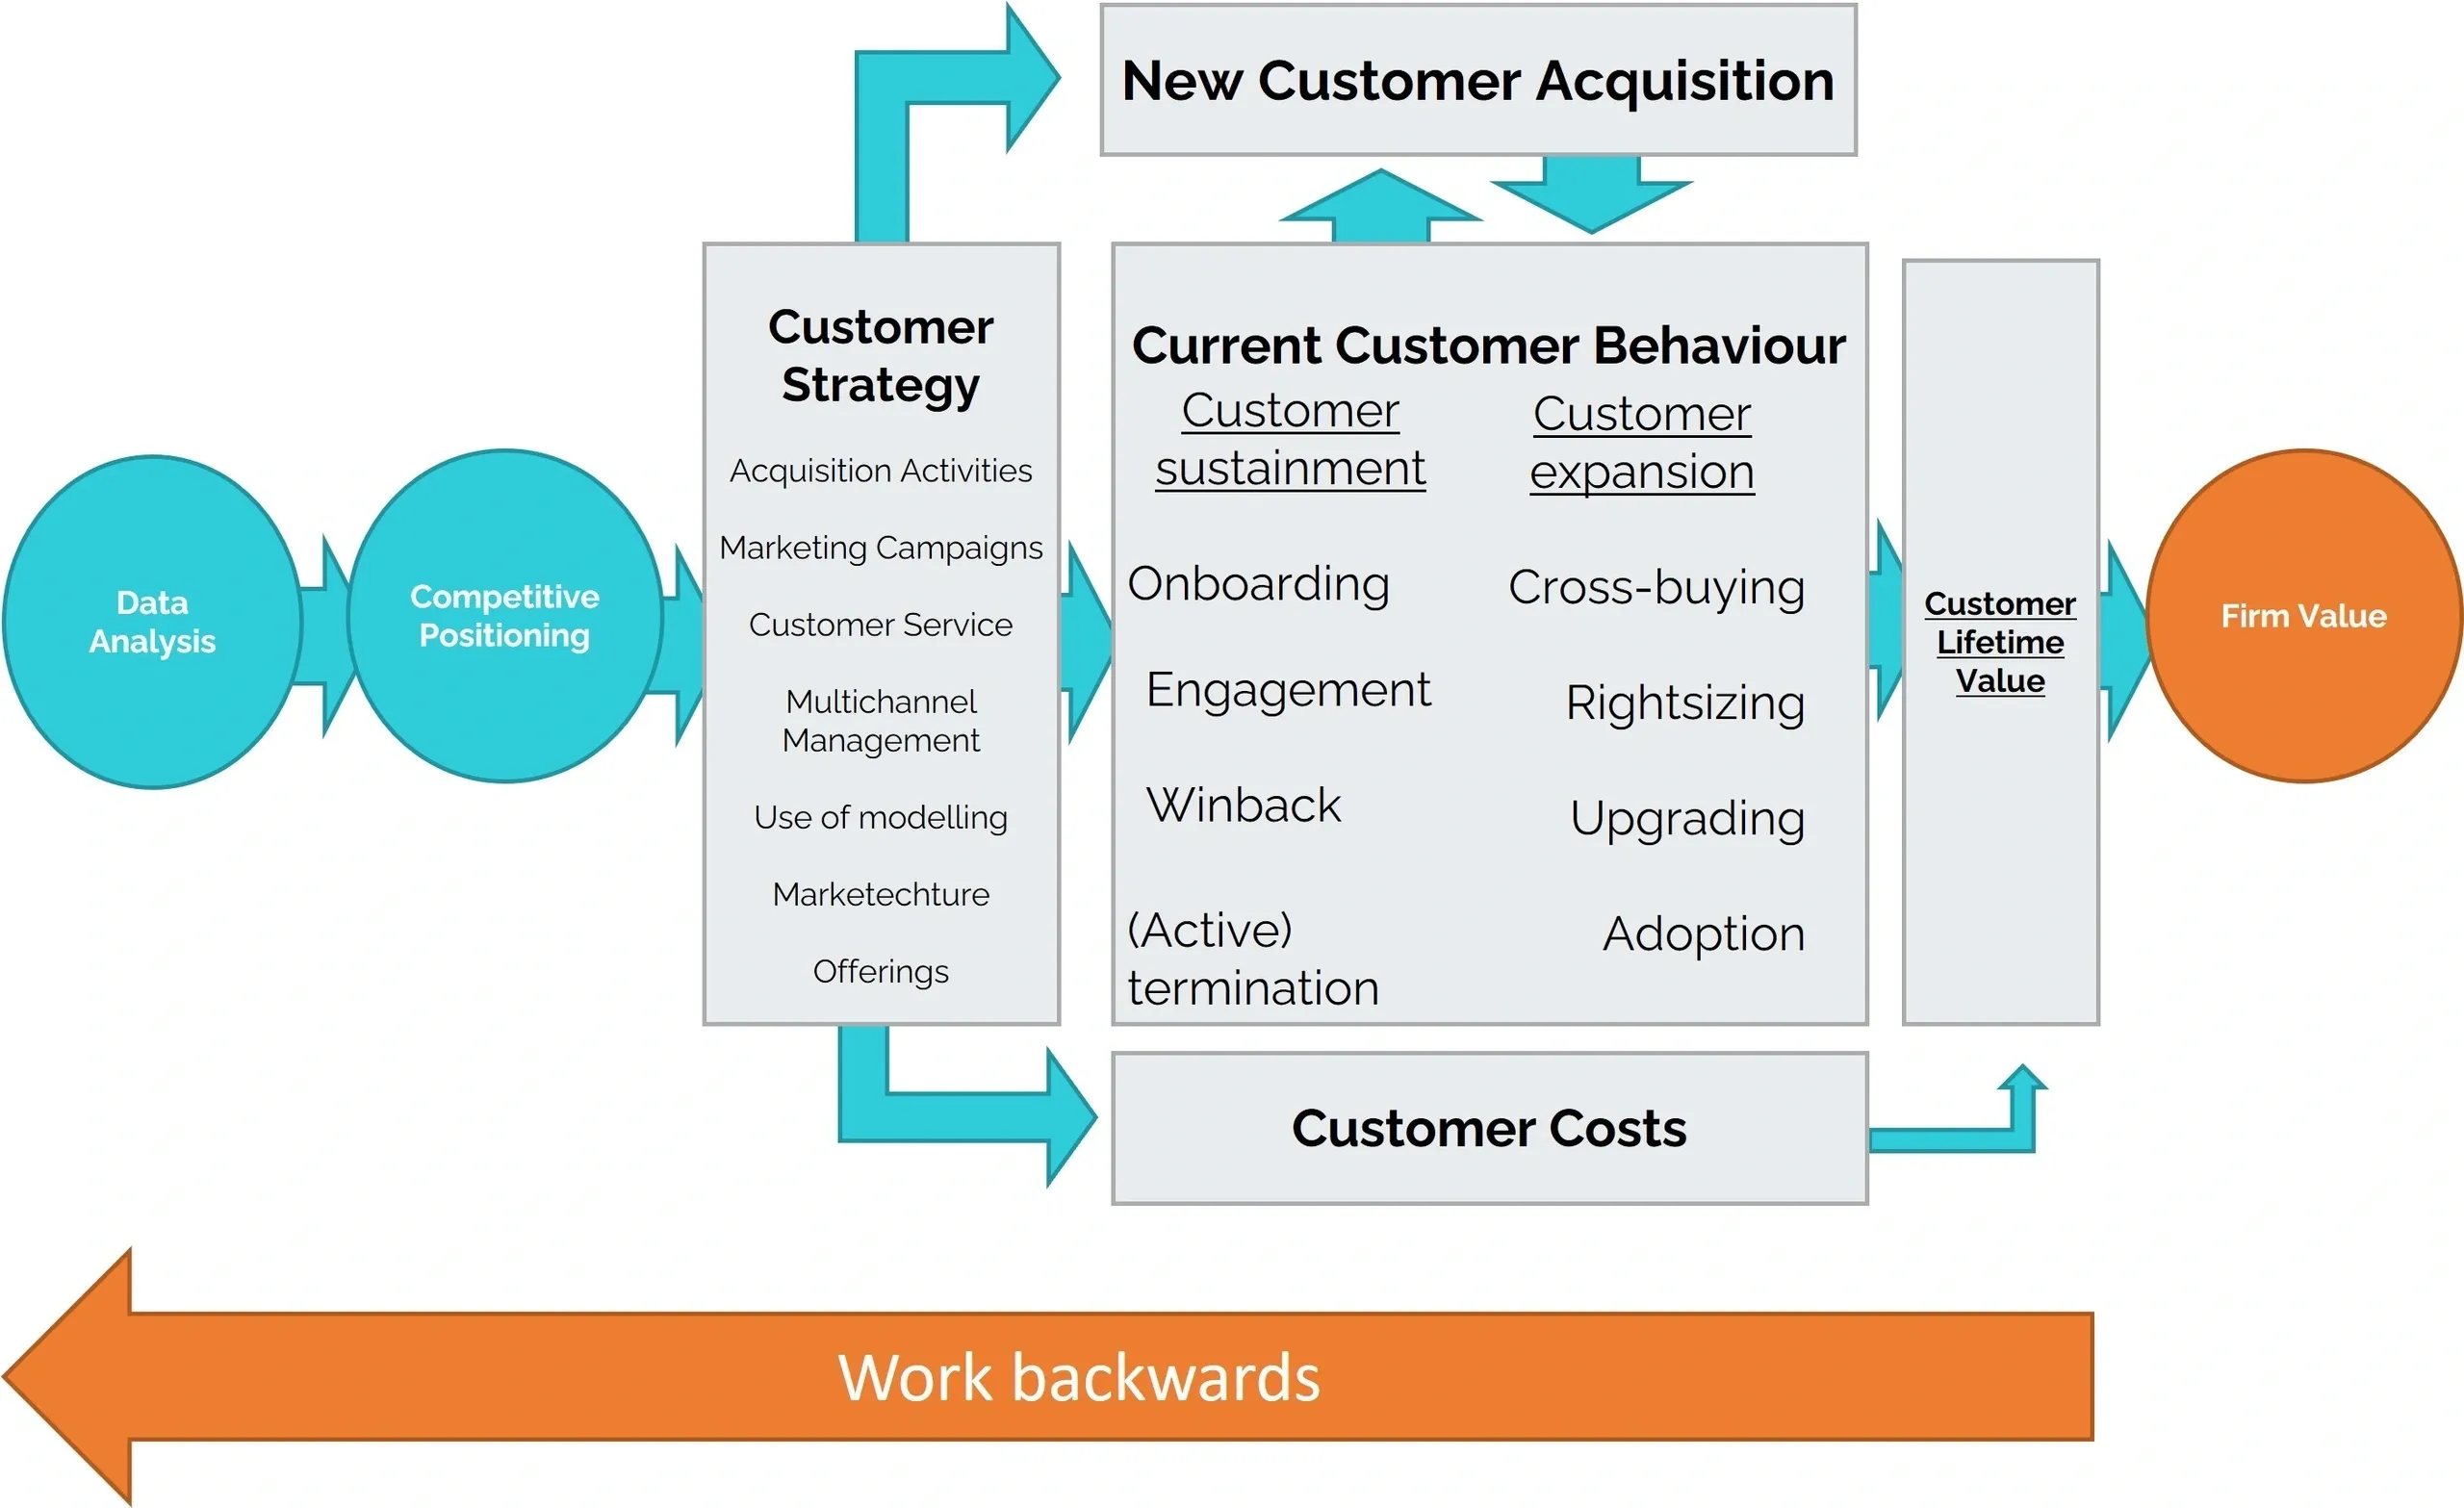
Что такое CVM Maximization и зачем он нужен
Customer Value Management Maximization (CVM) — это системный подход к управлению ценностью клиентов на протяжении всего цикла отношений: от привлечения до удержания и повторной продажи. Главная цель CVM Maximization состоит в том, чтобы через анализ данных, предиктивную модельность и персонализированные действия максимизировать совокупную ценность клиента для бизнеса. В практическом плане это означает:
- увеличение среднего жизненного цикла клиента (CLV, LTV);
- повышение эффективности маркетинговых затрат (ROI от кампаний);
- оптимизацию ассортимента и ценовой политики для разных сегментов;
- снижение оттока (churn) и увеличение частоты повторных покупок;
- внедрение «следующего лучшего действия» (Next Best Action, NBA) на каждом этапе взаимодействия.
Основные термины и понятия
- CLV / LTV (Customer Lifetime Value): ожидаемая суммарная ценность, которую принесет клиент за период его взаимодействия с компанией.
- CAC (Customer Acquisition Cost): затраты на привлечение клиента.
- ROI (Return on Investment): окупаемость маркетинговых мероприятий.
- RFM-моделирование: классификация клиентов по трём параметрам — давность покупки (Recency), частота (Frequency) и денежная ценность (Monetary). Это базовый инструмент сегментации и раннего анализа ценности.
- Чурн (Churn) и удержание: вероятность прекращения взаимодействия и доля клиентов, остающихся в базе.
- Next Best Action (NBA): предложение или действие, которое наиболее вероятно даст наибольшую ценность на конкретном этапе пути клиента.
- Предиктивная аналитика и uplift-моделирование: прогнозирование поведения клиентов и определение эффекта отдельных действий (например, акции), включая эксперименты A/B.
- Модели CLV: классические статистические и ML-модели, которые оценивают будущую ценность клиента; примеры — BG/NBD, Gamma-Gamma, регрессионные и градиентные методы.
- DWH (Data Warehouse) и BI (Business Intelligence): архитектура для хранения данных и инструментов анализа и визуализации.
- DWH-архитектура и модульность: концепция построения хранилища в виде фактов и измерений (star/snowflake схемы), которые облегчают анализ и прогнозы.
Методологический подход и рамки внедрения
- Цели и метрики: определить бизнес-цели CVM (например, увеличение CLV на X% за Y месяцев, снижение оттока на Z%), а также набор KPI для мониторинга.
- Цикл CRISP-DM / KMDF: процесс начинается с понимания бизнес-потребностей, становится данными, моделированием, развертыванием и мониторингом моделей в продакшене; цикл повторяется с учетом изменений в бизнесе и данных.
- Архитектура «единый источник истины»: основа — DWH, который агрегирует данные из разных источников (POS, онлайн-магазин, CRM, колл-центр, ваш маркетинговый стек). Важна целостность данных и четкая политика доступа к персональным данным.
- Управление данными и качество (Data Quality): обеспечение полноты, точности, консистентности и актуальности данных. Включает профилирование данных, правила очистки и мониторинг качества.
- Этические и правовые рамки: обработка персональных данных должна соответствовать нормам локального законодательства (например, в России — требования 152-ФЗ о персональных данных, хранение и обработка в рамках региональных и корпоративных политик).
Архитектура данных и методология моделирования
- Архитектурная концепция: сбор данных из разных источников, хранение в DWH/DS (data warehouse / data storage), подготовка и обогащение данных, построение моделей CLV и NBA, реализация кампаний, измерение эффективности и обратная связь в систему.
- Структура DWH: звездная схема с фактами взаимодействия (факт_взаимодействий, факт_покупок) и измерениями (измерение_клиента, время, канал, продукт, кампании). Важны SCD (Slowly Changing Dimensions) для сохранения изменений в профилях клиентов.
- ETL vs ELT: современные решения чаще применяют ELT-подход, когда данные сначала загружаются в хранилище, затем преобразуются внутри хранилища с использованием вычислительных мощностей DWH.
- Непрерывность и реальная скорость принятия решений: реальных-time или near-real-time данные требуют архитектуры с потоковой обработкой (пример: потоковая обработка через Kafka/гораздо менее задержанная обработка через ClickHouse + потоковые конвейеры).
Практические примеры
1. Пример типового проекта CVM Maximization
- Бизнес-задача: увеличить общую ценность клиентов через персонализированные кампании и снижение оттока в онлайн-ритейле.
- Источники данных: POS-данные, онлайн-покупки, история взаимодействий в CRM, данные колл-центра, данные лояльности, веб-аналитика и социальные каналы.
- Архитектура данных: данные собираются в Data Lake, затем консолидируются в DWH (Star Schema). В DWH создаются таблицы клиентов, взаимодействий, продуктов, кампаний и факторы влияния.
- Моделирование CLV: применяются классические подходы и ML-модели. Например, BG/NBD для прогнозирования вероятности покупки и Gamma-Gamma для монетарной ценности покупки. В современных реалиях часто применяют CatBoost или LightGBM для предиктивной оценки CLV, особенно когда имеется большое количество категориальных признаков.
- NBA и кампании: на каждый клиентский сегмент формируется набор потенциальных действий (персональные офферы, кросс-продажи, напоминания о повторной покупке). Используется A/B-тестирование для оценки эффекта кампании.
- Метрики успеха: увеличение CLV на сегмент, ROI по кампаниям, уменьшение CTR- отток, рост конверсии повторной покупки.
2. Практический сценарий с open-source инструментами
- Интеграция данных: Apache Airflow управляет ETL/ELT конвейерами, извлекая данные из PostgreSQL (CRM), ClickHouse (DWH), S3-хранилищ и веб-аналитики.
- Обработка и модели: Apache Spark используется для подготовки больших наборов данных и вычисления признаков; CatBoost применяется для предиктивной оценки CLV с учетом большого числа категориальных переменных; Lifetimes-подобные подходы (BG/NBD, Gamma-Gamma) применяются как базовая модель CLV.
- Визуализация: Apache Superset или Metabase создают дашборды по CLV, оттоку, эффективности кампаний, и позволяют бизнес-менеджеру быстро видеть текущее состояние дел.
- Модельный мониторинг и MLOps: MLflow применяется для версионирования моделей, отслеживания параметров и метрик; периодически запускаются регрессионные тесты и мониторинг дрейфа модели.
- Банковский и коммуникационный контур: данные обрабатываются с соблюдением регуляторных требований, особенно в части персональных данных, и фильтруются для маркетинговых целей.
3. Практические примеры на российских решениях
- ClickHouse: открытое DWH-решение с высокими скоростями чтения и записи, хорошо подходит для агрегаций по большим объемам данных, включая временные ряды и торговые данные. Используется как основа для хранилища фактов и для аналитических запросов.
- Yandex DataLens: российское BI-решение для визуализации и анализа, позволяет соединяться с ClickHouse и PostgreSQL, строить интерактивные дашборды и делать самообслуживание аналитикой бизнес-подразделений.
- Ya Metrica / Яндекс.Метрика: инструмент веб-аналитики, помогающий отслеживать поведение пользователей онлайн-площадки и конверсию, данные могут служить входом для сегментации и моделирования.
- 1C-Битрикс: интеграционные возможности CRM и бизнес-процессов, которые можно использовать для извлечения данных о клиентах и взаимодействиях и интегрировать их в DWH для CVM-аналитики.
- CatBoost (российская разработка, открытый код): мощная ML-библиотека, хорошо работает с категориальными признаками, часто применяется для задач предиктивной аналитики и CLV-моделирования в российских проектах.
- Принципы использования: через BI-слой и DWH строятся необходимые модели, а затем выпускаются кампании через CRM-системы (Bitrix24 и пр.), контролируются результаты и оптимизируются.
4. Примеры сценариев внедрения и рисков на практике
- Пример 1: внедрение CLV на розничном ритейле. Истоки данных — POS, онлайн-канал, CRM. Используется ClickHouse как DWH, DataLens для визуализации, CatBoost для прогнозирования CLV и NBA. Риск: задержки в доставке данных и сложности согласования между отделами маркетинга и продаж.
- Пример 2: онлайн-оператор услуг. Используется Apache Kafka для стриминга данных об онлайн-взаимодействиях, ELT-пайплайн на Spark, модель монетарной ценности клиентов. Риск: дрейф моделей и необходимость частой перенастройки таргетинга.
- Пример 3: интеграция в российские решения. Внедряются DataLens и ClickHouse на бэкэнде, данные безопасно обрабатываются в рамках ТЗ по защите персональных данных. Риск: соответствие требованиям хранения персональных данных и локализация серверов.
Архитектура данных и моделирования
- Источники данных: POS, онлайн-магазин, CRM, 콜-центр, LMS лояльности, веб-аналитика.
- Data Lake и Data Warehouse: данные сначала собираются в Data Lake (хранилище для «сырых» данных), затем структурируются и загружаются в DWH. DWH реализуется на PostgreSQL/ClickHouse, иногда в сочетании с доп. OLAP-слой.
- Модели данных: STAR- или SNOWFLAKE-архитектура. Факты: факт_покупок, факт_взаимодействий; Измерения: клиент, продукт, время, канал, кампания.
- Управление данными: данные проходят через профилирование, очистку и обогащение; внедряются правила качества и пайплайны в Data Quality.
- Безопасность и приватность: реализованы RBAC, шифрование данных в покое и в передаче, маскирование чувствительных данных, аудит доступа.
-
Инструменты и стек:
- Интеграция и оркестрация: Apache Airflow (или аналог), сценарии ETL/ELT.
- Обработка данных: Apache Spark (PySpark) для крупных наборов; SQL-обработки в ClickHouse и PostgreSQL.
- Моделирование: CatBoost, scikit-learn, lifetimes (для CLV-моделей BG/NBD, Gamma-Gamma), возможно использование Prophet для прогнозирования временных рядов.
- Модели и мониторинг: MLflow для отслеживания версий моделей, параметров и метрик; периодический мониторинг качества данных и поведения моделей.
- Визуализация: Apache Superset, Metabase, Yandex DataLens для бизнес-аналитики и дашбордов.
- Хранилище и работа с данными: ClickHouse и PostgreSQL как DWH/OLAP-слои; Data Lake на S3-совместимом хранилище или локальный аналог.
Технические детали моделирования CLV и NBA
Базовые модели CLV:
- BG/NBD: оценивает вероятность повторной покупки и время до следующей покупки.
- Gamma-Gamma: оценивает денежную ценность каждой покупки.
- Комбинации: CLV = вероятность повторной покупки × ожидаемая денежная ценность покупки × ожидаемая продолжительность взаимодействия.
Современные ML-модели:
- CatBoost/LGBM/LightGBM: работают с категориальными признаками, помогают предсказывать будущую ценность клиента и отклик на кампании.
- Регрессионные модели и ансамбли: линейные и нелинейные методы для предсказания CLV или вероятности конверсии.
NBA и тестирование:
- Предиктивная ли Campaign-эффективность — анализ uplift-эффектов (когда влияние кампании оценивается по разности между контрольной и экспериментальной группами).
- A/B/N-тестирование и многорукого бандита: выбор оптимального действия в реальном времени, баланс между исследованием и эксплуатацией.
Метрики и контроль качества:
- Метрики CLV, ROI кампаний, CTR, конверсия, ARPU, удержание, доля возвращений.
- Мониторинг дрейфа модели и данных (дрейф входных признаков, изменение распределений).
Пример настройки пайплайна:
- Шаг 1: сбор данных из источников и загрузка в Data Lake.
- Шаг 2: очистка, нормализация и обогащение признаков.
- Шаг 3: расчет базовых и продвинутых признаков для CLV.
- Шаг 4: обучение моделей CLV и NBA.
- Шаг 5: развертывание в продакшн, интеграция с CRM для автоматических кампаний.
- Шаг 6: измерение эффективности и итеративная настройка.
Примеры технической реализации
- Открытое решение стека: Airflow + Spark + CatBoost + Lifetimes + ClickHouse + DataLens/Superset.
- Российские решения в стеке: ClickHouse как ядро DWH; DataLens для BI-аналитики; CatBoost как ML-библиотека с поддержкой русского сообщества; Bitrix24 как CRM-слой для взаимодействий с клиентами, интегрируемый через API в кампейны; Яндекс.Метрика как источник веб-аналитики; Яндекс.Данные для визуализаций и аналитики.
- Пример рабочих конфига на уровне концепции: конвейер данных начинается с загрузки Raw Data в Data Lake, затем ETL преобразует данные к нужной схеме DWH, затем признаковая инженерия и обучение моделей, результаты записываются в модельный репозиторий MLflow, в BI-дешбордах отображаются показатели CLV и эффект кампаний.
Практические советы по внедрению
- Начинайте с малого: выберите один узкий сценарий (например, увеличение повторной покупки для высокой ценности клиентов) и реализуйте пилотный проект с четкими KPI.
- Работайте над качеством данных: сначала качество входных данных, затем качество входных характеристик для моделей.
- Внедряйте приватность и безопасность: учитывайте локальные требования к персональным данным, применяйте маскирование и ограничивайте доступ.
- Обеспечьте цикл обратной связи: бизнес-отдел должен регулярно получать обновления по эффективности кампаний и корректировать цели.
- Обеспечьте сквозную видимость: мониторинг моделей, пайплайнов и результатов кампаний должен быть доступен на уровне дашбордов визуализации.
Риски и ограничения
Риски внедрения CVM Maximization
- Данные и качество: несовместимость источников, пропуски и несоответствия в данных приводят к ошибочным моделям и неверным выводам.
- Дрейф моделей и данных: поведение клиентов меняется со временем, а модели требуют переобучения и перенастройки.
- Приватность и регуляторика: обработка персональных данных требует строгого соответствия законодательству, локализация для хранения данных и контроль доступа.
- Взаимодействие бизнес-подразделений: несогласованность между отделами маркетинга, продаж и IT может задержать внедрение и снизить эффект.
- Ожидания и ROI: нереалистичные ожидания по скорости окупаемости и эффектам кампаний могут привести к разочарованию руководства.
- Технологический риск: зависимость от нескольких инструментов может привести к проблемам в случае сбоев, обновлений или лицензирования.
Ограничения проекта
- Локальные регуляторные рамки: работа с персональными данными может ограничивать использование некоторых источников или передачу данных между системами и регионами.
- Ограничения по данным: частота обновления данных может быть ограничена инфраструктурой и требованиями к обработке.
- Ограничения в бюджетах и кадрах: внедрение CVM требует специалистов по данным, ML, BI, а также поддержки инфраструктуры.
- Время адаптации бизнеса: построение доверия к автоматизированным решениям и встраивание в бизнес-процессы может занять значительное время.
Как минимизировать риски
- Поддерживайте «мало‑форсированность» проекта: начинайте с пилотов и чётко измеряемых KPI; постепенно расширяйте охват.
- Обеспечьте качество данных и управление версиями: используйте инструменты валидации и мониторинга данных, регистрируйте изменения.
- Внедрите CI/CD для моделей: автоматизация повторной упаковки моделей, тестирования и выкладки в продакшн.
- Регулярно обновляйте требования по приватности и безопасности данных, обучайте сотрудников и соблюдайте регламенты.
- Обеспечьте прозрачность решений: делайте отчеты и поясняйте бизнесу, какие действия приняты и почему, какие эффекты ожидаются.
Цели и рамки проекта CVM Maximization — это стратегический набор практик, которые фокусируются на максимизации ценности клиентов с использованием современных средств BI и DWH. Важно, чтобы проект имел ясные цели и KPI, логичную архитектуру данных, прозрачные процессы обработки и построения моделей, а также план управления рисками и соответствием требованиям. Реализация предполагает сочетание теоретических основ: CLV, сегментация, NBA, моделирование и A/B-тесты, с практическими инструментами: Open Source-стек (Airflow, Spark, CatBoost, Lifetimes, ClickHouse, Superset) и российскими решениями (ClickHouse, DataLens, Ya Metrica, Bitrix24). Важнейшие элементы успеха — качество данных, тесное сотрудничество между бизнесом и IT, а также непрерывный цикл обучения и адаптации моделей и процессов к изменяющимся условиям рынка.
Вопрос–Ответ (FAQ)
Что такое CVM Maximization и зачем нужна эта концепция в BI и DWH?
CVM Maximization — это целостный подход к управлению ценностью клиентов на всем их пути: от привлечения до удержания и повторных покупок. В BI и DWH он позволяет собрать данные из разных источников, построить CLV-модели, определить наиболее перспективные сегменты и реализовать персонализированные кампании, измеряя их эффект и возвращаемость инвестиций. Это помогает бизнесу увеличить общую ценность клиентов и оптимизировать маркетинговые затраты.
Какие основные термины стоит запомнить?
CLV/LTV — предсказанная ценность клиента за его отношение к компании; CAC — затраты на привлечение клиента; ROI — окупаемость кампаний; RFM — метод сегментации по давности, частоте и денежной ценности; NBA — следующий наилучший шаг по взаимодействию; Churn — отток; BG/NBD и Gamma-Gamma — базовые ML/статистические модели CLV; DWH/BI — хранилище данных и инструменты анализа; ETL/ELT — процессы переноса и подготовки данных.
Какие инструменты особенно полезны в открытом источнике?
Open Source стеки включают Apache Airflow (оркестрация данных), Apache Spark (масштабная обработка данных), CatBoost и scikit-learn (ML/предиктивная аналитика), Lifetimes (модели CLV), ClickHouse (DWH), Apache Superset или Metabase (BI-визуализация), MLflow (MLOps). Эти инструменты позволяют построить полный цикл от сбора данных до моделей и визуализации результатов.
Какие российские решения стоит учитывать?
ClickHouse — мощное открытое DWH-решение, родом из России; DataLens — российское BI-решение для визуализации и анализа; Яндекс.Метрика — веб-аналитика, данные которой можно интегрировать в процесс анализа; CatBoost — российская ML-библиотека; 1C-Битрикс — CRM-слой, который может служить источником данных для анализа. Эти инструменты дополняют открытые решения и помогают соответствовать локальным требованиям и инфраструктуре.
Какие шаги включает типичный проект CVM-Maximization?
Начинать следует с определения целей и KPI, затем построить архитектуру данных (источники → Data Lake → DWH), запустить пилотный конвейер ETL/ELT, сформировать CLV-модели и NBA, внедрить кампании через CRM, измерять результаты и проводить цикл улучшения. Весь процесс сопровождается контролем качества данных, безопасностью и соответствием правилам приватности.
Какие риски ожидаются и как их минимизировать?
Риски — некачественные данные, дрейф моделей, законодательные ограничения, ограничение бюджета и ресурсов, недостаток координации между отделами. Минимизация достигается через пилоты с чётким KPI, обеспечение качества данных, мониторинг моделей, строгие правила приватности и прозрачную коммуникацию между бизнесом и IT, а также через устойчивую архитектуру с повторяемыми конвейерами и контролем версий.
Что важно для успешного внедрения с точки зрения архитектуры?
Ключевые факторы — единый источник истины, качественные данные, модульная и гибкая архитектура DWH, правильная выборка инструментов (Open Source и российские решения), устойчивые пайплайны ETL/ELT и надёжный BI-слой для бизнес-аналитики. Не менее важно обеспечить интеграцию с CRM и marketing automation и иметь план по мониторингу и адаптации моделей.
Как измерять эффект CVM после внедрения?
Измерение включает: изменение CLV по сегментам, ROI кампаний, рост конверсии и повторной покупки, удержание клиентов, снижение оттока и улучшение эффективности кросс- и апселла. Важно также учитывать латентность эффектов — иногда влияние кампаний проявляется спустя время, поэтому необходим периодический повторный анализ.
Какую роль играет приватность и безопасность данных?
Очень важна защита персональных данных и соблюдение законодательства. Нужно внедрить RBAC, шифрование, маскирование данных, аудит доступа и локализацию данных. Это уменьшает риски нарушения приватности и повышает доверие со стороны клиентов и регуляторов.
Какие шаги можно предпринять прямо сегодня, чтобы начать работу над CVM-Maximization?
- Определите 2–3 конкретных бизнес-цели и KPI для пилота.
- Оцените доступные источники данных и их качество.
- Зафиксируйте архитектуру данных (DWH, пайплайны), выберите базовые инструменты (например, ClickHouse + DataLens для российского контекста).
- Реализуйте простой пилот CLV-модели и A/B-тестирование на ограниченной аудитории.
- Настройте базовый дашборд для наблюдения за ключевыми метриками.
- Обеспечьте план по приватности данных и коммуникации с бизнес-стейкхолдерами.


