

Производительная аналитика в StarRocks: оптимизация запросов и хранения
Современные аналитические нагрузки требуют обработки больших объемов данных с минимальной задержкой и высокой эффективностью. В этом контексте системы класса MPP-аналитических СУБД, такие как StarRocks, позволяют реализовать высокопроизводительную аналитику за счёт колоночного хранения, параллельной обработки и оптимизированных механизмов выполнения запросов. Однако достижение максимальной производительности требует не только выбора технологии, но и правильного проектирования архитектуры данных, моделей хранения и запросов.
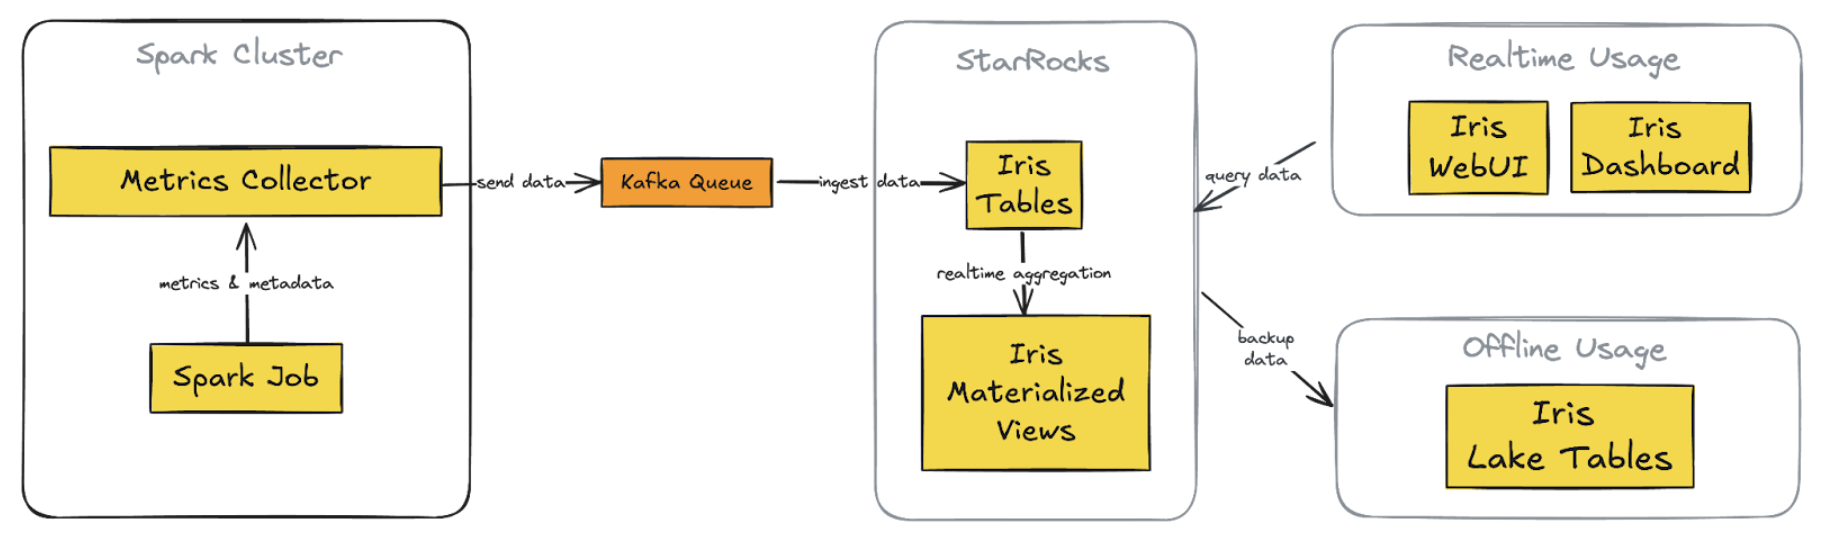
В этом разделе рассматриваются принципы построения производительной аналитики на базе StarRocks: оптимизация хранения данных, проектирование схем и партиционирования, настройка планировщика запросов и использование механизмов ускорения, таких как материализованные представления и кэширование. Особое внимание уделяется вопросам мониторинга, управления ресурсами, интеграции с BI и Data Science, а также практическим подходам к тестированию и эксплуатации системы.
- Введение в производительную аналитику на StarRocks
- Терминология и базовые концепции StarRocks
- Архитектура StarRocks: компоненты, слои и взаимодействие
- Стратегия хранения данных: колоночное представление, компрессия и кодирование
- Модели данных для аналитики: схемы, нормализация и денормализация
- Форматы данных и источники: Parquet, ORC, Data Lake
- Распределение данных: партиционирование, кластеризация и шардирование
- Репликация, консистентность и отказоустройнность
- Планировщик запросов и движок выполнения
- Оптимизация запросов: предикатное проталкивание, проекция и выбор соединений
- Индексация и статистика для оптимизатора
- Материализованные представления и кэширование результатов
- Инкрементальная загрузка и CDC в StarRocks: оптимизация запросов и хранения
- Интеграция Data Lake и потоковых источников
- Коннекторы и интеграции с источниками данных
- Интеграция с BI и аналитическими пайплайнами
- Транзакции, консистентность и изоляция
- Безопасность, управление доступом и аудит в StarRocks
- Мониторинг и observability: метрики, трассировка и алерты
- Эксплуатация: резервное копирование, обновления и релизы
- Управление ресурсами и планирование нагрузки
- QA, тестирование производительности и регрессионное тестирование
- Архитектурные паттерны интеграции с BI и Data Science
- Управление метаданными и каталогами данных
- Управление качеством данных и профилирование
- Риски и антипаттерны при внедрении StarRocks
- Дорожная карта развития платформы
- Практические лабораторные занятия и проекты
- Корпоративные кейсы внедрения StarRocks
- Миграции на StarRocks: стратегии и шаги
- Архитектура хранения горячего и холодного слоёв
- DevOps и автоматизация развёртывания StarRocks


