

Hadoop для аналитики: Hive, Impala, Spark SQL
Hadoop долгое время оставался основой аналитических платформ для работы с большими данными, а развитие инструментов SQL-on-Hadoop сделало его доступным не только для инженеров, но и для аналитиков. Такие технологии, как Hive, Impala и Spark SQL, позволяют выполнять сложные аналитические запросы поверх распределённых хранилищ, объединяя масштабируемость Data Lake с привычным SQL-интерфейсом.
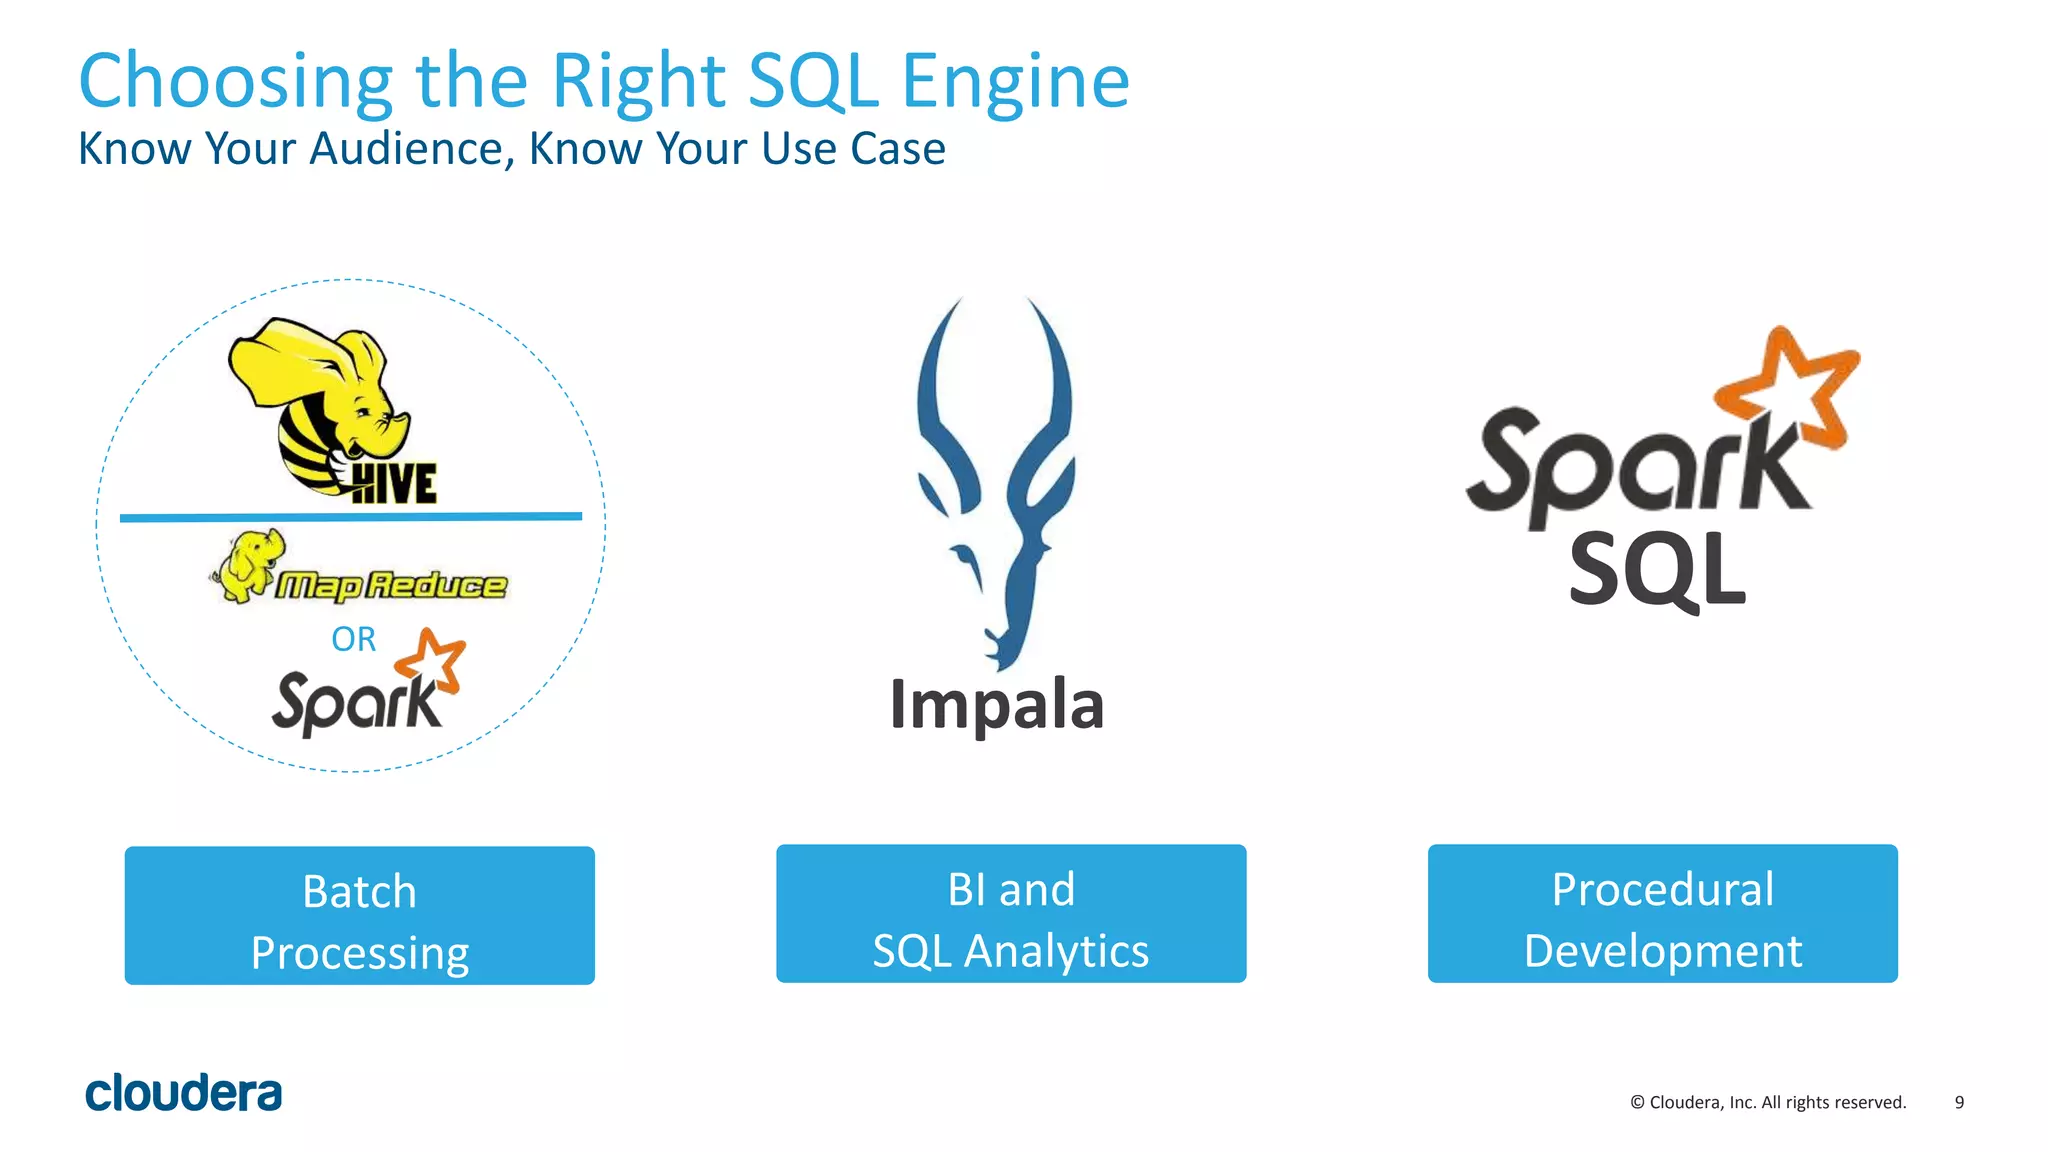
В этом разделе рассматриваются архитектурные и функциональные особенности ключевых аналитических инструментов Hadoop-экосистемы: принципы работы Hive, производительность Impala и оптимизатор Spark SQL. Особое внимание уделяется моделированию данных, форматам хранения, управлению метаданными и интеграции с источниками данных.
Дополнительно анализируются подходы к оптимизации производительности, оркестрации пайплайнов, обеспечению надежности и эксплуатации решений. Такой подход позволяет понять, как строить эффективную аналитику на Hadoop и какие инструменты выбирать под разные сценарии использования.
- Введение: роль Hadoop в аналитике и современные контексты
- Стратегия данных и целевые архитектуры: как Hadoop вписывается в корпоративную модель
- Обзор экосистемы: Hive, Impala, Spark SQL и сопутствующие проекты
- Архитектура Hadoop: слои хранения, вычисления и управления ресурсами
- Хранилище данных: HDFS, устойчивость и доступ к данным
- Объектные хранилища и гибридные сценарии: S3, ABFSS, ADLS и интеграция с Hadoop
- Форматы данных и схемы: Parquet, ORC, Avro, текстовые форматы, компрессия
- Метаданные и управление данными: Hive Metastore, HCatalog, Glue Data Catalog
- Безопасность и соответствие: Kerberos, Ranger, Sentry, политики доступа
- Управление качеством данных: профилирование, качество, линейность данных
- Введение в Hive: архитектура, язык HiveQL и типы операций
- Hive оптимизация: LLAP, векторизация, операторы и статистика
- Impala: архитектура, движок выполнения и оптимизация запросов
- Spark SQL: Catalyst и Tungsten, принципы оптимизации и исполнения
- SQL-on-Hadoop: сравнение функциональности и ограничений Hive, Impala, Spark SQL
- Архитектурные паттерны аналитики на Hadoop: Data Lakehouse, Lambda/Kappa и федеративный доступ
- Архитектура моделирования данных: схемы, партиционирование, bucketing, SCD
- Поточная обработка и потоковая аналитика: окна, обработка событий и согласованность
- Интеграция источников данных: Kafka, Flume, NiFi, Sqoop
- Оркестрация и пайплайны: Oozie, Airflow, управление зависимостями
- Миграции и внедрение: подходы к переводу существующих рабочих процессов в Hadoop
- Реализация инфраструктуры: выбор развёртывания, кластеры on-prem, облако, гибрид
- DevOps и разработка: инфраструктура как код, конфигурации, тестирование
- Эксплуатация и операционная модель: мониторинг, логирование, SLA, инцидент-менеджмент
- Производительность и тюнинг: настройка Yarn, Tez/LLAP, ресурсы и параллелизм
- Надёжность, отказоустойчивость и резервы: бэкапы, точки восстановления, DR
- Риски, ограничения и типичные ошибки в проектах Hadoop
- Развитие и зрелость архитектуры: дорожные карты, масштабирование, TCO/ROI
- Практические кейсы: розничная аналитика и клиентское поведение
- Практические кейсы: финансы, телеком и отраслевые сценарии


