

ETL-процессы в Hadoop: ingestion, partitioning и оптимизация хранения
ETL-процессы являются основой построения аналитических платформ на базе Hadoop, обеспечивая загрузку, преобразование и подготовку данных для последующего анализа. В условиях больших данных требования к таким процессам существенно возрастают: необходимо учитывать масштабируемость, задержки, разнообразие источников и форматов данных, а также требования к качеству и управляемости данных.
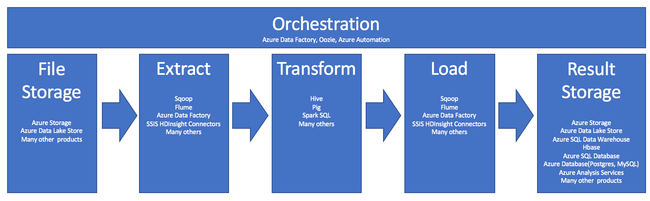
В этом разделе рассматриваются архитектурные подходы к построению ETL в Hadoop: ingestion-слой, выбор между batch и streaming обработкой, а также интеграция с инструментами, такими как Kafka, NiFi и Spark. Особое внимание уделяется стратегиям хранения данных — partitioning, bucketing, выбор форматов (Parquet, ORC) и компрессии, что напрямую влияет на производительность и стоимость обработки.
Дополнительно раскрываются вопросы управления схемами и метаданными, обеспечения качества данных, планирования нагрузок и эксплуатации ETL-пайплайнов. Такой подход позволяет выстроить эффективные и масштабируемые процессы обработки данных, поддерживающие современные аналитические и AI-сценарии.
- Введение: цели курса и роль ETL в Hadoop для цифровой трансформации
- Основы и терминология Hadoop и ETL
- Контекст применения ETL в больших данных: бизнес-цели и требования
- ETL vs ELT и выбор подхода: batch, streaming и их сочетания
- Теоретические основы архитектуры ETL: слои, границы ответственности и интерфейсы
- Архитектурные паттерны Hadoop для ETL: конвейеры, DAG, микроблоки
- Инфраструктура Hadoop: HDFS, YARN, MapReduce, Spark и их роли в ETL
- Ингестия данных: источники, частота обновления и требования к задержке
- Инструменты ingestion в экосистеме Hadoop: Kafka, Apache NiFi, Flume, Sqoop
- Архитектура ingestion-слоя: потоковые каналы, буферы и персистентность
- Протоколы обмена данными и форматы: Kafka, Avro, Parquet, ORC, JSON, Protobuf
- Хранилище и метаданные: HDFS, Hive Metastore, HBase, Kudu
- Форматы хранения и компрессия: Parquet, ORC, Snappy/Zstd, настройки
- Стратегии partitioning, bucketing и clustering для больших данных
- Управление схемой и совместимостью: эволюция схем, Schema Registry и договоры по данным
- Метаданные и каталогизация данных: lineage, governance, data catalog
- Трансформации в рамках ETL: очистка, обогащение, нормализация и агрегации
- Технологические средства трансформации: Spark SQL, HiveQL, MapReduce
- Распределение нагрузки и планирование загрузок: incremental, CDC, SCD
- Lambda и Kappa на Hadoop: достоинства, ограничения и выбор подхода
- Безопасность, соответствие и данные: Kerberos, Ranger, Sentry, masking и privatность
- Управление ресурсами и планирование: YARN, queues, capacity, autoscaling
- Эксплуатационная модель: мониторинг, логирование, tracing и observability
- Девопс для ETL в Hadoop: CI/CD, тестирование конвейеров и окружения
- Управление качеством данных: валидации, тестовые данные и предотвращение дефектов
- Риски, типичные ошибки и лучшие практики развертывания
- Практические кейсы и сценарии: финансы, телеком, розничная торговля, здравоохранение
- Архитектурные дорожные карты зрелости ETL в Hadoop
- Будущее ETL в экосистеме Hadoop: миграции, lakehouse и новые паттерны


