

SQL для DWH: оптимизация аналитических запросов и работа с большими объёмами
SQL остаётся основным инструментом работы с данными в корпоративных хранилищах (DWH), обеспечивая доступ к аналитике, построение отчётности и поддержку бизнес-решений. Однако при работе с большими объёмами данных эффективность запросов напрямую влияет на производительность платформы, стоимость вычислений и скорость получения инсайтов.
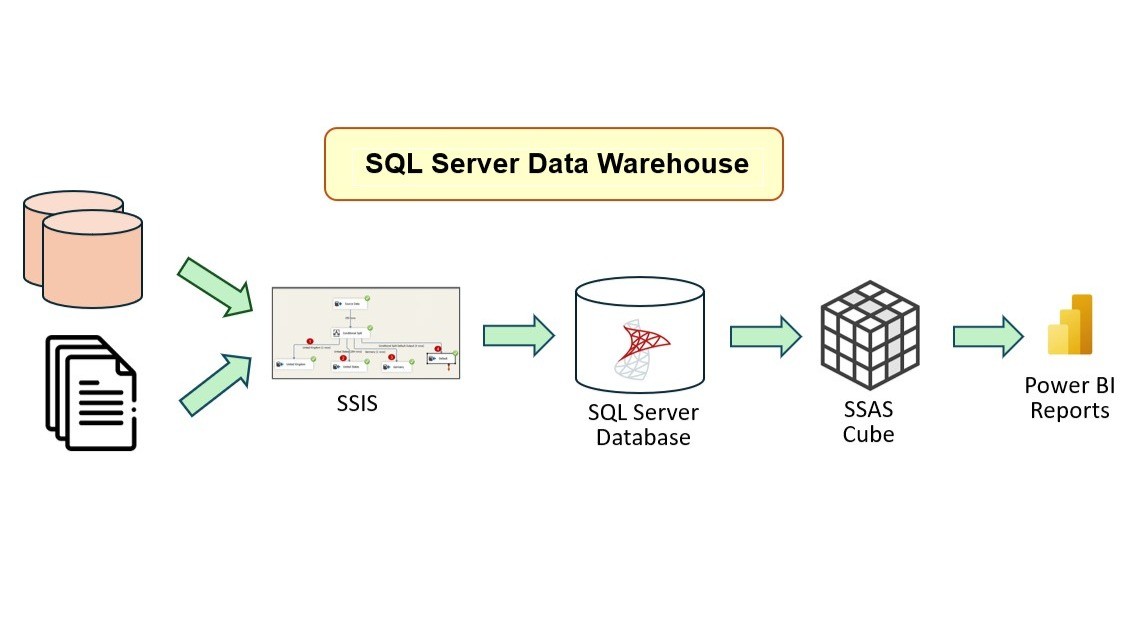
В этом разделе рассматриваются принципы оптимизации SQL-запросов в DWH: понимание планов выполнения, работа оптимизатора, выбор стратегий джоинов, агрегаций и фильтрации. Особое внимание уделяется архитектурным аспектам — партиционированию, кластеризации, колоночным форматам хранения и использованию MPP-подходов для масштабирования вычислений.
Дополнительно раскрываются продвинутые техники оптимизации: predicate pushdown, материализованные представления, кэширование, а также управление метаданными и качеством данных. Такой подход позволяет выстроить эффективную работу с аналитическими запросами, снизить нагрузку на систему и обеспечить стабильную производительность DWH в условиях роста данных.
- Введение в SQL для DWH: цели, термины и контекст
- Архитектура данных DWH: слои, потоки данных и управляемость
- Хранение данных: колоночные форматы, компрессия и физическая организация
- Типовые аналитические запросы: агрегации, оконные функции, временные диапазоны
- Теория выполнения запросов: оптимизатор, план выполнения, cardinality estimation
- Физический план и операции: сканы, джоины, агрегации, сортировка, spill
- Параллелизм и MPP-архитектуры: распределение задач и интерфейсы данных
- Метаданные, каталоги и управление качеством данных
- Архитектурные паттерны DWH: Star, Snowflake, Data Vault, Data Lakehouse
- Слои архитектуры: staging, core, presentation слои
- Правила хранения и репликации: партиционирование, кластеризация и pruning
- Построение и использование планов: автоматизация оптимизации и rewrite
- Продвинутые техники оптимизации SQL: predicate pushdown, раннее применение фильтров, подзапросы
- Индексы, сортировка и структуры хранения: zone maps, bitmap, компрессия
- Материализованные виды и кэширование результатов: подходы и trade-offs
- Управление данными: lineage, качество данных, governance и каталоги
- Модели данных под аналитическую нагрузку: денормализация vs нормализация, агрегаты
- Интеграция и ELT против ETL: стратегия загрузки и pushdown
- Инструменты и технологии DWH: выбор движков, облачных решений и API
- Архитектура безопасности: доступ, маскирование, аудит и соответствие требованиям
- Риски и типовые ошибки в SQL-оптимизации DWH
- Мониторинг и операционная эксплуатация: метрики, алерты, трассировка запросов
- Тюнинг и конфигурация СУБД: ресурсы, память, spill, параллелизм
- Автоматизация и масштабирование: оркестрация, autoscaling и планирование нагрузок
- Развитие и зрелость DWH: дорожная карта, миграции и стратегическое внедрение
- Практические кейсы: оптимизация реальных крупномасштабных запросов
- Кейсы архитектурной миграции: переход на Lakehouse/MPP-платформы
- Практические сценарии: реалтайм аналитика против батчевой аналитики


