

Prometheus для инженеров данных и DevOps: PromQL и анализ временных рядов
Эффективное использование Prometheus невозможно без глубокого понимания языка запросов PromQL и принципов анализа временных рядов. Именно здесь происходит переход от простого мониторинга к аналитике метрик и поиску причин проблем.
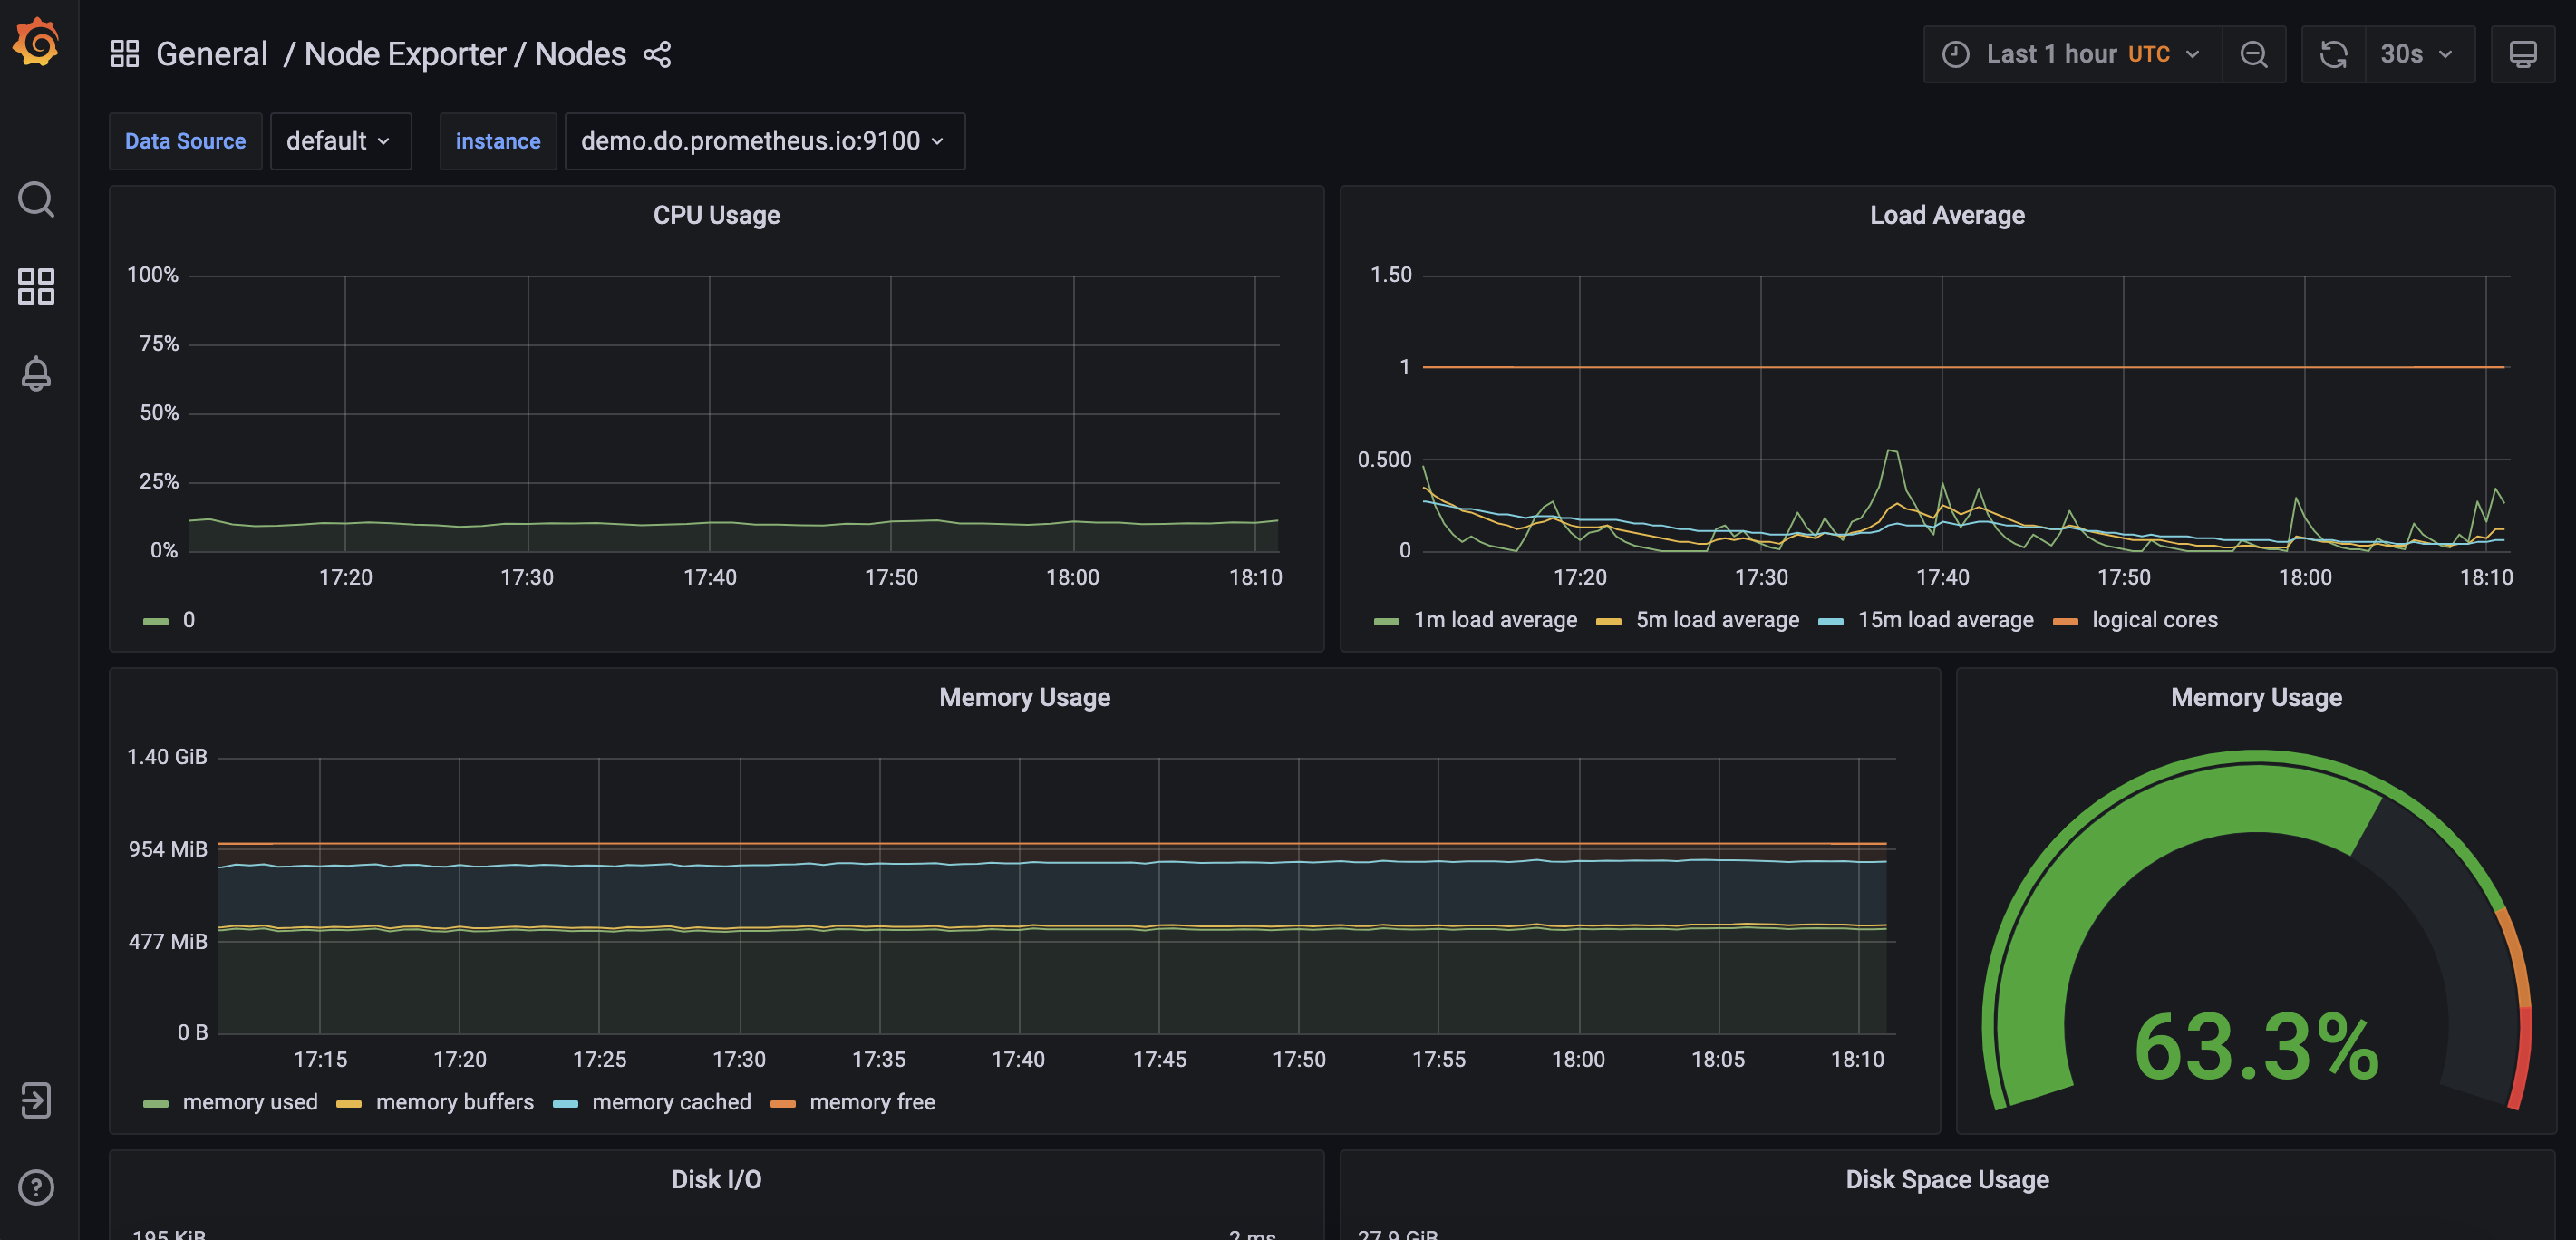
В этом разделе рассматриваются типы метрик (counter, gauge, histogram), агрегации, оконные функции и работа с high-cardinality данными. Особое внимание уделяется оптимизации хранения, построению аналитических запросов и снижению нагрузки на систему.
Дополнительно раскрываются практики SRE, алертинга и визуализации. Такой подход позволяет использовать Prometheus как полноценный аналитический инструмент.
- Введение в мониторинг данных и DevOps: стратегические цели и роль Prometheus
- Архитектура Prometheus: компоненты, данные и взаимодействие
- Мониторинг на уровне предприятий: архитектурные паттерны централизованный и федеративный сбор
- Стандарты и форматы метрик: OpenMetrics, exposition formats и совместимость
- Моделирование метрик: имена, лейблы, схемы классификации
- Типы метрик Prometheus: counter, gauge, histogram, summary
- Язык запросов PromQL: синтаксис, базовые выражения и примеры
- Агрегации и оконные вычисления в PromQL: функции, агрегации по лейблам
- Методы анализа временных рядов: rate, irate, increase, скользящие окна
- Архитектура хранения: TSDB, компрессии, индексы и срок жизни данных
- Управление хранением и ретеншном: политики хранения и стратегий downsampling
- Расширяемость и интеграции: Thanos, Cortex, VictoriaMetrics и совместимость
- Интеграции с Kubernetes: ServiceMonitor, Prometheus Operator, Helm
- Инфраструктурные метрики и экспортёры: системные, сеть, база данных, облачные сервисы
- Приложенческие и бизнес-метрики: KPI, SLI/SLA, бизнес-енгейджмент
- Высокая кардинальность: проблемы, подходы и практические решения
- Архитектурные паттерны мониторинга микросервисов: exporter, sidecar, pull, push
- Практика внедрения: дорожная карта проекта, пилоты и переходные этапы
- Практические инструменты визуализации: Grafana, дашборды и аналитика запросов
- Реализация мониторинга: сбор метрик, экспортёры, агрегация, хранение
- Надежность и операционная модель: SRE практики, SLO/SLI, алертинг
- Безопасность и управление доступом: RBAC, секреты, шифрование данных
- CI/CD и IaC для мониторинга: Helm, Ansible, Terraform, репозитории изменений
- Тестирование и валидация метрик: тест-драйверы, synthetic метрики, валидность данных
- Управление рисками: ловушки PromQL, перегрузки, ложные алерты
- Развитие, масштабирование и зрелость мониторинга: дорожная карта эволюции
- Практические кейсы по архитектуре мониторинга: крупномасштабные кластеры, multi-tenant
- Практические кейсы по аналитике метрик: оптимизация запросов и дашбордов
- Практические кейсы по снижению затрат: экономия хранения и вычислений
- Резюме: будущее Prometheus и эволюция экосистемы


