

CAP теорема
Знаменитой CAP теореме исполнилось 25 лет, поэтому хотелось что это такое, зачем она и как появилась. Про это есть отличная статья от Eric Brewer, автора теоремы, который написал ее больше 10 лет назад, которую хотелось вспомнить, так как она хороша:)
Начнем с самого утверждения теоремы (цитата из статьи выше)
The CAP theorem states that any networked shared-data system can have at most two of three desirable properties:
- consistency (C) equivalent to having a single up-to-date copy of the data;
- high availability (A) of that data (for updates); and
- tolerance to network partitions (P).
Дальше надо вспомнить про ее появление
- 25 лет назад, осенью 1998 года была сформулирована CAP теорема
- в 1999 году она была опубликована в статье "Harvest, Yield, and Scalable Tolerant Systems" в ACM
- в 2000 представлена на Симпоузиуме "Symposium on Principles of Distributed Computing" (презентация здесь)
- в 2002 доказана формально (где консистентность из теоремы превратилась в линеаризуемость)
Потом теорема пошла в массы и превратилась в условные "выберите 2 свойства из трех: C, A, P", что является сильным упрощением по трем причинам, что указывает Эрик в уже упоминавшейся статье:
- Из-за редкости partition нет смысла выбирать между C и A (про это подробнее в следующий раз при обсуждении PACELC Theorem)
- Решение о C или A принимается не единоразово для всех компонентов и всех данных, а на другом уровне гранулярности и может зависеть от типа операции или данных
- C, A, P это не бинарные свойства, а скорее непрерывные availability от 0 до 100%, уровни консистентности тоже бывают разные и даже partitions имеют нюансы:)
В итоге, Эрик говорит о том, что в отсутствии разделения системы мы можем выбирать A или C, а во время проблем у нас должен быть понятный алгоритм
- определения, что случился partition
- перехода в явный partition режим, в котором часть операций может быть лимитирована
- запуска процесса восстановления консистентности и компенсации ошибок, что возможно были в рамках partition
Потом Эрик рассказывает про связь акронимов ACID, BASE и CAP
- BASE расшифровывается как Basic Availability, Soft state и Eventually consistency. Первые два из свойств помогают достигать доступности при разделении системы на части
- ACID расшифровывается как Atomicity, Consistency, Isolation, Durability. Этот акроним знают многие, кто работал с реляционными базами данных, но как я писал выше Consistency из CAP и из ACID это про разное и это добавляет сложности в понимании:)
Следом идет часть про latency, которая отсутствует в классической формулировке, но неявно присутствует. Ведь выполняя операцию в разделенной системе, мы в какой-то момент должны принять решение
- отменить операцию и уменьшить доступность
- продолжить операцию, но принять риск неконсистентности данных
Конечно можно попробовать повторно выполнить операцию (retries), но это просто откладывает принятие решение на некоторое время. Таким образом, с прагматической точки зрения разделение — это ограничение по времени (таймаут), который мы закладываем в свое общение. А из этого следует несколько последствий
- Не существует глобального понятия partition, поскольку некоторые узлы могут обнаружить partition, а другие — нет.
- Те узлы, что обнаружили partition входят в режим partition-mode, собственно ту часть, где нам надо выбирать между C и A
В итоге, проектировщики системы выставляют time bounds так, чтобы соответствовать целевым скоростям ответа системы на запросы, а чем жестче эти time bounds, тем выше вероятность попадания в partition mode, причем даже просто при медленной сети, но без реального ее разделения.
В приведенной ниже статье есть еще много интересных мыслей про scope консистентности и как это соотносится с датацентрами, как явно управлять процессами перехода в partition mode и восстанавливаться после partition. Очень рекомендую ее к прочтению.
CAP двенадцать лет спустя: Как изменились "правила игры"
Согласно теореме CAP, любая сетевая система с общими данными может обладать только двумя из трех желаемых свойств. Однако, обрабатывая разделы, разработчики могут оптимизировать согласованность и доступность данных, то есть достигнуть определенного компромисса между всеми тремя свойствами.
За 10 лет, прошедшие с момента появления теоремы, разработчики использовали (а иногда и откровенно злоупотребляли) CAP как повод для изучения широкого спектра новых распределенных систем. Движение NoSQL даже выдвигало ее в качестве основного аргумента против традиционных баз данных.
Итак, согласно теореме CAP, любая сетевая система с общими данными может обладать не более чем двумя из трех желаемых свойств:
- согласованность данных (consistency - C), эквивалентная наличию единственной актуальной копии данных;
- высокая степень доступности (availability - A) этих данных (для обновлений); и
- терпимость к разделению сети (Partition tolerance - P).
Основная цель CAP заключалась в том, чтобы «распахнуть умы» разработчиков для более широкого спектра систем и компромиссов - действительно, за последние 10 лет появилось огромное количество новых систем. Формулировка "2 из 3" всегда вводила многих в заблуждение, поскольку чрезмерно упрощала противоречия между свойствами систем. Сегодня даже мельчайшие нюансы имеют большое значение. CAP «запрещает» лишь небольшую часть пространства проектирования: идеальную доступность и согласованность при наличии разделений сети, которые встречаются довольно редко.
Хотя разработчикам все еще приходится выбирать между согласованностью и доступностью при наличии разделений, существует множество различных способов добиться компромисса. Современная цель CAP состоит в том, чтобы максимизировать число комбинаций согласованности и доступности, которые имеют смысл для каждого конкретного приложения. Такой подход включает в себя разработку планов работы во время разделений и восстановления после них.
Почему "2 из 3" не совсем верное утверждение
Самый простой способ понять CAP - представить себе два узла по разные стороны разделения. Если разрешить хотя бы одному узлу обновлять состояние, узлы станут непоследовательными, что приведет к потере C. Аналогично, если необходимо сохранить последовательность, одна из сторон разделения должна вести себя так, как будто она недоступна, что приведет к потере A. Только когда узлы «общаются», можно сохранить и последовательность, и доступность, что неизбежно приведет к потере P. Считается, что для систем с широкой зоной доступа разработчики не могут отказаться от P, поэтому им приходится выбирать между C и A. В некотором смысле движение NoSQL - это создание вариантов, в которых на первом месте стоит доступность, а на втором - согласованность; в случае баз данных, придерживающихся свойств ACID (атомарность, согласованность, изоляция и долговечность), на первом месте – согласованность, а на втором – доступность.
Фактически, именно эта дилемма привела к появлению теоремы CAP. В середине 1990-х годов мы с коллегами создавали различные кластерные системы с широкой зоной доступа (по сути, ранние облачные вычисления), включая поисковые системы, прокси-кэши и системы распространения контента. Ввиду огромного желания получить прибыль доступность системы была на первом месте, поэтому мы регулярно ее оптимизировали с помощью таких решений, как использование кэшей или протоколирование обновлений для последующей сверки. Такой подход, безусловно, повышал доступность, при этом нам все же приходилось жертвовать согласованностью данных.
Первая версия аргумента "согласованность против доступности" появилась под названием ACID vs BASE и в была воспринята достаточно враждебно, прежде всего потому, что люди любят свойства ACID и не решаются от них отказаться. Цель теоремы CAP заключалась в том, чтобы обосновать необходимость изучения более широкого пространства проектирования - отсюда и формулировка "2 из 3". Теорема «родилась» осенью 1998 года, была опубликована в 1999 году, а годом позже, в 2000 году, была упомянута в докладе на Симпозиуме по принципам распределенных вычислений.
Итак, установка "2 из 3" не совсем верна по нескольким причинам. Во-первых, поскольку разделения встречаются достаточно редко, нет особых причин отказываться от C или A, если система не разделена. Во-вторых, выбор между C и A может происходить несколько раз в рамках одной и той же системы - подсистемы могут не просто делать разные выборы, но и меняться в зависимости от операции, конкретных данных или даже пользователя. Наконец, все три свойства являются скорее непрерывными, чем бинарными. Доступность непрерывна от 0 до 100 процентов, у согласованности совершенно точно есть несколько уровней, и даже у разделений есть свои нюансы, включая «разногласия» внутри системы по поводу того, существует разделение или нет.
Изучение этих нюансов требует пересмотра традиционного способа работы с разделениями, что является фундаментальной проблемой. Поскольку разделения встречаются достаточно редко, CAP должна допускать идеальные C и A в большинстве случаев. Но, как только появляются разделения, нам необходимо использовать стратегию, которая поможет учесть их в процессе работы. Эта стратегия должна состоять из трех шагов: обнаружение разделений, вход в режим явного разделения, который может ограничить некоторые операции, и запуск процесса восстановления для восстановления согласованности и исправления ошибок, допущенных во время разделения.
ACID, BASE и CAP
ACID и BASE - две философии проектирования систем, основанные на совершенно противоположны взглядах на согласованность и доступность. Свойства ACID сосредоточены на согласованности и являются традиционным подходом к базам данных. BASE появилась в конце 1990-х годов как результат работы моей команды, стремящейся отразить новые подходы к проектированию систем с высокой степенью доступности. Современные системы, включая облачные решения, используют сочетание этих двух подходов.
Хотя оба термина являются скорее мнемоническими, чем точными, аббревиатура BASE более запутанная: Basically Available, Soft state, Eventually consistent (В основном доступный, мягкое состояние, в конечном счете непротиворечивый). Мягкое состояние и согласованность - это техники, которые хорошо работают при наличии разделений и, таким образом, способствуют доступности.
Отношения между CAP и ACID более сложны, отчасти потому, что C и A в ACID – это не то же самое, в CAP. Итак, ACID:
- Атомарность (Atomicity - А). Все системы выигрывают от атомарных операций. Когда основное внимание уделяется доступности, обе стороны разделения должны по-прежнему использовать атомарные операции. Более того, атомарные операции более высокого уровня (какие и предполагает ACID) на самом деле значительно упрощают восстановление;
- Согласованность (Consistency - С). В ACID буква C означает, что транзакция сохраняет все правила базы данных, такие как уникальные ключи. В CAP буква С относится только к согласованности единственной копии, строгому подмножеству согласованности ACID. В ACID согласованность также не может поддерживаться при разделении. Для восстановления раздела потребуется восстановление согласованности ACID. В более общем плане сохранение инвариантов во время разделений может оказаться невозможным, поэтому необходимо тщательно продумать заранее, какие операции необходимо запретить и как восстанавливать инварианты во время восстановления;
- Изоляция (Isolation - I). Изоляция лежит в основе CAP: если системе требуется изоляция ACID, она может работать только на одной стороне во время разделения. Упорядочиваемость в целом требует коммуникации и, следовательно, не работает при разделениях. Более слабые определения корректности применимы в условиях разделений посредством компенсации во время восстановления после разделения.
- Долговечность (Durability - D). Как и в случае с атомарностью, нет особых причин отказываться от долговечности, хотя разработчик может отказаться от нее в силу дороговизны и выбрать мягкое состояние (в стиле BASE). Тонкость заключается в том, что во время восстановления разделения можно отменить устойчивые операции, которые нарушили инвариант во время операции. Однако на момент восстановления, учитывая историю с обеих сторон, такие операции можно скорректировать. В общем, запуск транзакций ACID на каждой стороне разделения значительно упрощает восстановление и обеспечивает структуру для компенсации транзакций, которые можно использовать для восстановления после разделения.
Соединение с CAP- задержкой
В своей классической формулировке теорема CAP не принимает во внимание задержку, хотя на практике задержка и разделения тесно связаны между собой. Технически суть CAP проявляется во время тайм-аута или периода, во воемя которого программа должна принять фундаментальное решение — решение о разделении:
- отменить операцию и тем самым снизить доступность, или
- продолжить операцию и тем самым подвергнуть себя риску несогласованности.
Повторная попытка установить связь для достижения согласованности, например, через Paxos или двухэтапную фиксацию, лишь откладывает решение. В какой-то момент программа все-таки должна принять решение; бесконечное повторение попыток восстановления связи, по сути, означает выбор C (вместо A).
Таким образом, с практической точки зрения, разделение — это временнОе ограничение связи. Неспособность достичь согласованности в течение ограниченного времени подразумевает разделение и, следовательно, выбор между C и A для данной операции. Эти концепции охватывают основную проблему разработки в отношении задержки: могут ли две разделенные стороны продолжать функционировать?
У данного подхода есть несколько важных последствий. Во-первых, нет глобального понятия разделения, поскольку одни узлы могут обнаружить разделение, а другие нет. Во-вторых, узлы могут обнаруживать разделение и переходить в режим разделения — это центральная часть оптимизации C и A.
Наконец, эта точка зрения означает, что разработчики могут намеренно устанавливать временные ограничения в соответствии с целевым временем отклика; системы с более жесткими границами, скорее всего, будут чаще входить в режим разделения, даже в те моменты, когда сеть просто медленная и на самом деле не разделена.
Facebook использует противоположную стратегию: главная копия всегда находится в одном месте, поэтому у удаленного пользователя, как правило, - близкая, но потенциально устаревшая копия. Однако, когда пользователи обновляют свои страницы, обновление поступает непосредственно в мастер-копию, как и все чтения пользователя в течение короткого времени, несмотря на более высокую задержку. Через 20 секунд трафик пользователя возвращается к более близкой копии, которая к тому времени должна отражать обновление.
Путаница CAP
Аспекты теоремы CAP часто трактуются неправильно, особенно область доступности и согласованности, что может привести к нежелательным результатам. Если пользователи не могут получить доступ к обслуживанию, у них нет выбора между C и A, за исключением случаев, когда часть обслуживания выполняется на клиенте. Это исключение, широко известное как работа без подключения к сети или автономный режим, становится все более и более важным. Некоторые функции HTML5, в частности постоянное хранение на клиенте, упрощают дальнейшую работу в автономном режиме. Эти системы обычно выбирают A, а не C, и поэтому должны восстанавливаться после длительных разделений.
Область согласованности отражает идею о том, что в пределах некоторой границы состояние согласовано, но за пределами этой границы правила согласованности больше не действуют. Например, внутри основного раздела можно обеспечить полную согласованность и доступность, за его пределами это сделать невозможно. Paxos и атомарные многоадресные системы обычно соответствуют этому сценарию. В Google основной раздел обычно находится в одном центре обработки данных; однако для обеспечения глобального консенсуса на обширной территории используется Paxos (Chubby).
Независимые самосогласованные подмножества могут продолжать функционировать и при разделении, хотя глобальные инварианты в таком случае обеспечить не получится. Например, при шардировании, когда разработчики предварительно разделяют данные по узлам, возрастает вероятность того, что каждый сегмент может добиться определенного прогресса во время разделения. И наоборот, если соответствующее состояние оказалось разделенным или необходимы глобальные инварианты, то в лучшем случае только одна сторона сможет добиться прогресса, а в худшем случае прогресс попросту невозможен.
Имеет ли смысл выбирать именно согласованность и доступность (CA) в качестве «2 из 3»? Как справедливо отмечают некоторые исследователи, совершенно неясно, что именно означает отказ от P. Может ли разработчик отказаться от разделений? Если выбрать CA, а затем появится разделение, то снова нужно будет выбирать C или A. Лучше всего думать об этом так: выбор CA должен означать, что вероятность разделения намного меньше, чем вероятность других системных сбоев, таких как аварии или множественные одновременные ошибки.
Такая точка зрения вполне правомерна, поскольку реальные системы при некоторых наборах ошибок теряют и. С, и А. На практике большинство специалистов предполагают, что центр обработки данных (единственная площадка) не имеет внутренних разделений, и проектируют СА в пределах одной площадки; такие конструкции, в том числе традиционные базы данных, существовали по умолчанию до появления CAP. Однако, несмотря на то, что разделения внутри центра обработки данных маловероятны, они все-таки возможны, поэтому обеспечение CA становится проблематичным. Наконец, учитывая высокую задержку в системах с широким территориальным распределением, довольно часто в целях повышения производительности приходится отказываться от идеальной согласованности.
Ещё один недостаток CAP — это скрытая цена утраты согласованности, которая заключается в необходимости знать инварианты системы. Утонченная красота согласованной системы заключается в том, что инварианты имеют тенденцию сохраняться, даже если разработчик не знает, что именно они из себя представляют. Следовательно, широкий диапазон разумных инвариантов будет прекрасно работать сам по себе. И наоборот, когда разработчики выбирают вариант доступной системы, который требует восстановления инвариантов после разделения, они должны явно указать все возможные инварианты, что само по себе сложно и повышает риск возникновения ошибок. По сути, это та же проблема параллельных обновлений, которая делает многопоточность более сложной по сравнению с последовательным программированием.
Управление разделениями
Здесь перед разработчиками стоит непростая задача — смягчить влияние разделения на согласованность и доступность. Идея заключается в том, чтобы четко управлять разделениями, контролируя не только обнаружение, но и определенный процесс восстановления и план для всех инвариантов, которые могут быть нарушены во время разделения. Такой подход к управлению состоит из трех этапов:
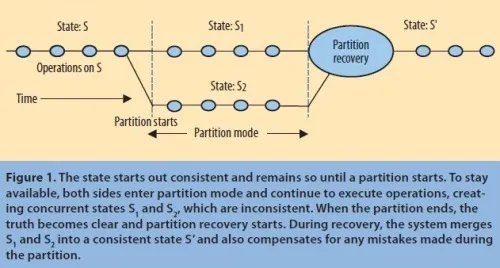
- обнаружить начало разделения;
- ввести явный режим разделения, который может ограничить некоторые операции, и
- запустить восстановление раздела при восстановлении связи.
Последний шаг направлен на восстановление согласованности и исправление ошибок, допущенных программой за время разделения системы.
На рис. 1 показано развитие разделения. Обычный процесс представляет собой последовательность атомарных операций, поэтому разделения всегда начинаются между операциями. По истечении времени ожидания система обнаруживает разделение, и обнаруживающая сторона переходит в режим разделения. Если разделение существует, в этот режим входят обе стороны, но возможны и односторонние разделения. В таких случаях другая сторона поддерживает связь как положено, и либо эта сторона получает правильные ответы, либо связь не требуется; в обоих случаях операции остаются согласованными. Однако, поскольку обнаруживающая сторона может выполнять несогласованные операции, она должна войти в режим разделения. Системы, использующие кворум, являются примером такого одностороннего разделения. Одна сторона будет иметь кворум и сможет продолжить работу, а другая – нет. Системы, поддерживающие автономную работу, явно имеют понятие режима разделения, так же как и некоторые атомарные многоадресные системы, такие как JGroups в Java.
Как только система переходит в режим разделения, возможны два пути. Первый — ограничить некоторые операции, тем самым снизив доступность. Второй — записать дополнительную информацию об операциях, которая будет полезна при восстановлении после разделения. Продолжение попыток установить связь позволит системе определить, когда разделение закончится.
Какие операции следует продолжить?
Решение о том, какие операции стоит ограничить, зависит прежде всего от инвариантов, которые должна поддерживать система. Учитывая набор инвариантов, разработчик должен решить, поддерживать ли конкретный инвариант в режиме разделения или рискнуть нарушить и возобновить его во время восстановления. Например, в случае с инвариантом, когда ключи в таблице уникальны, разработчики обычно решают рискнуть этим инвариантом и разрешить дублирование ключей во время разделения. Дублирующиеся ключи легко обнаружить при восстановлении, а с учетом того, что их можно объединить, разработчик сможет восстановить инвариант без особых усилий.
Однако в случае с инвариантом, который должен поддерживаться во время разделения, разработчик должен запретить или изменить операции, которые могут его нарушить. Внешние события, такие как снятие средств с кредитной карты, часто работают таким образом. В этом случае стратегия состоит в том, чтобы записать намерение и выполнить его после восстановления. Такие транзакции обычно являются частью более крупного рабочего процесса, в котором есть явное состояние обработки заказа, и отсрочка операции до завершения разделения не особо страшна. Разработчик жертвует А таким образом, что конечные пользователи этого не видят. Они знают только то, что они разместили заказ и что система выполнит его чуть позже.
В более общем плане режим разделения ставит сложную задачу пользовательскому интерфейсу – сообщить, что задачи выполняются, но не завершены. Исследователи довольно подробно изучили эту проблему в режиме автономной работы, которая представляет собой простое длинное разделение. Программа-календарь Bayou, например, показывает потенциально несогласованные (предварительные) записи другим цветом. Такие уведомления регулярно отображаются как в приложениях для выполнения рабочих процессов, , так и в облачных решениях с автономным режимом ( Google Docs).
Одна из причин остановиться именно на явных атомарных операциях, а не просто на чтении и записи, заключается в том, что анализировать влияние более высокоуровневых операций на инварианты гораздо проще. По сути, разработчик должен построить таблицу, которая рассматривает перекрестное произведение всех операций и всех инвариантов и решает для каждой записи, может ли эта операция нарушить инвариант. Если да, то разработчик должен решить, следует ли запретить, отложить или изменить операцию. На практике эти решения также могут зависеть от состояния, аргументов или от того и от другого сразу. Например, в системах с домашним узлом для определенных данных операции обычно выполняются на домашнем узле, а не на других узлах.
Лучший способ отслеживать историю операций с обеих сторон — это использовать векторы версий, которые фиксируют причинно-следственные зависимости между операциями. Элементы вектора представляют собой пару (узел, логическое время) с одной записью для каждого узла, обновившего объект, и временем его последнего обновления. Учитывая две версии объекта, A и B, A новее, чем B, если для каждого общего узла в их векторах время A больше или равно времени B, и по крайней мере одно из значений времени A больше.
Если упорядочить векторы невозможно, значит, обновления были одновременными и, возможно, несогласованными. Таким образом, учитывая историю векторов версий обеих сторон, система может легко определить, какие операции уже выполняются в определенном порядке, а какие выполняются одновременно. Недавние исследования доказали, что такого рода причинно-следственная связь является наилучшим возможным результатом, если разработчик решает сосредоточиться на доступности.
Восстановление после разделения
В определенный момент связь возобновляется и разделение заканчивается. Во время разделения каждая сторона была доступна и продолжала функционировать, но разделение задержало некоторые операции и нарушило определенные инварианты. На этом этапе системе известно состояние и история обеих сторон, поскольку в режиме разделения всё подробно записывалось в журнал. Состояние не так полезно, как история, благодаря которой система может вычислить, какие операции на самом деле нарушили инварианты и какие результаты были вынесены за пределы системы, в том числе ответы, направленные пользователям. При восстановлении разработчик должен решить две сложные задачи:
- состояние с обеих сторон должно стать согласованным, и
- должно быть предусмотрено исправление ошибок, допущенных в режиме разделений.
Как правило, проще исправить текущее состояние, начиная с состояния на момент разделения и воспроизводя оба набора операций, поддерживая при этом согласованное состояние. Например, Bayou «откатывал» базу данных до определенного времени и воспроизводил полный набор операций в четко определенном порядке так, чтобы все узлы достигли одного и того же состояния. Похожим образом из общей согласованной точки запускается система контроля исходного кода (например, Concurrent Versioning System или CVS), которая затем, следуя определенному порядку, выполняет обновление за обновлением.
Большинство систем не всегда в состоянии разрешить возникшие конфликты. Например, в CVS иногда возникают конфликты, которые пользователь может разрешить только вручную.
И наоборот, некоторые системы всегда разрешают конфликты, выбрав определенные операции. В качестве примера можно привести редактирование текста в Google Docs, которое ограничивает возможные операции применением стиля и добавлением или удалением текста. Таким образом, хотя общая проблема разрешения конфликтов в целом неразрешима, на практике разработчики могут ограничивать использование определенных операций во время разделения, чтобы система могла автоматически объединять состояния во время восстановления. Отсрочка рискованных операций — одна из относительно простых реализаций этой стратегии
Использование коммутативных операций — это наиболее близкий подход к общей структуре автоматической конвергентности состояний. Система объединяет журналы, сортирует их в определенном порядке, а затем выполняет соответствующие операции. Коммутативность подразумевает способность перестраивать операции в предпочтительный глобальный порядок. К сожалению, использовать только коммутативные операции намного сложнее, чем кажется на первый взгляд.
Недавняя работа Марка Шапиро и его коллег из INRIA значительно облегчила использование коммутативных операций для конвергентности состояний. Эти святила (не побоюсь этого слова) в области данных разработали коммутативные реплицированные типы данных (commutative replicated data types — CRDT), класс структур данных, которые доказуемо сходятся после разделения, и описали, как использовать эти структуры для того, чтобы:
- гарантировать, что все операции во время разделения коммутативны,
- или представить значения на сетке и гарантировать, что все операции во время разделения монотонно возрастают по отношению к этой сетке значений.
Последний подход конвергирует состояние, передвигая к максимуму значения каждой стороны. По сути, это усовершенствование того, что Amazon делает со своей корзиной: после разделения конвергентное значение представляет собой объединение двух корзин, причем объединение представляет собой операцию с монотонным множеством. При выборе такого подхода удаленные элементы могут появиться снова.
Однако CRDT могут выполнять и устойчивые к разделениям наборы инструкций, которые добавляют и удаляют определенные элементы. Суть данного подхода заключается в введении двух множеств: по одному для добавленных и удаленных элементов, причем элементами этих множеств являются изменения. Каждый упрощенный набор сходится, а значит, сходятся и изменения. В какой-то момент система может навести порядок, просто удалив удаленные элементы из обоих наборов. Однако подобная очистка, как правило, возможна только в том случае, если система не разделена. Другими словами, разработчик должен запретить или отложить некоторые операции во время разделения.
Таким образом, реализуя состояние через CRDT, разработчик может выбрать A и по-прежнему гарантировать, что состояние автоматически сходится после разделения
Исправление ошибок
В дополнение к определению состояния после разделения существует более сложная проблема исправления ошибок, допущенных во время разделения. Отслеживание и ограничение операций в режиме разделения обеспечивает возможность определения того, какие инварианты могли быть нарушены, что, в свою очередь, позволяет разработчику создать стратегию восстановления для каждого инварианта. Как правило, система обнаруживает нарушение во время восстановления и в это же время должна выполнить нужное исправление.
Существуют различные способы исправить инварианты, в том числе такие банальные как «last writer wins» (которые игнорируют некоторые обновления) или более разумные подходы, объединяющие операции. Примером последнего является избыточное бронирование мест в самолете: посадка в самолет в некотором смысле является восстановлением после разделения с инвариантом, согласно которому мест должно быть не меньше, чем пассажиров. Если пассажиров слишком много, некоторые из них потеряют свои места, и в идеале служба поддержки должна будет возместить им понесенный ущерб.
Пример с самолетом также наглядно демонстрирует экспортированную ошибку: если бы авиакомпания не проинформировала пассажира, что для него в самолете забронировано место (а по факту места нет), решить проблему было бы намного проще. Это еще одна причина откладывать рискованные операции: на момент восстановления правда уже совершенно точно известна. В основе исправления таких ошибок лежит идея компенсации; разработчики должны создавать компенсирующие операции, которые восстанавливают инвариант и исправляют экспортированную ошибку.
Для восстановления после экспортированных ошибок обычно требуется некоторая история внешних выходных данных. Рассмотрим пример «набора номера» в состоянии алкогольного опьянения, когда человек не помнит, как делал различные телефонные звонки, будучи пьяным предыдущей ночью. Состояние этого человека на другой день может быть нормальным, но журнал по-прежнему показывает список совершенных звонков, некоторые из которых могут быть ошибочными. Звонки являются внешним последствием состояния человека (опьянения). Поскольку человек не помнит совершенные им звонки, исправить возникшие из-за них проблемы может быть достаточно трудно.
В контексте оборудования компьютер во время разделения может выполнять заказы дважды. Если система в состоянии отличить два специально сделанных заказа от дублирующихся заказов, она может отменить один из дубликатов. В случае экспортирования ошибки, одна из компенсационных стратегий будет состоять в том, чтобы автоматически сгенерировать электронное письмо для клиента, объясняющее, что система случайно выполнила заказ дважды, но ошибка была исправлена, и прикрепить купон на скидку на следующую покупку. Однако без надлежащей истории ошибку искать придется самому покупателю.
Некоторые исследователи формально рассматривают компенсационные транзакции как способ работы с долгосрочными транзакциями. Долгосрочные транзакции сталкиваются со следующими вариантами решений по поводу разделений: что лучше – удерживать блокировки в течение длительного времени для обеспечения согласованности или отпускать их раньше и предоставлять незафиксированные данные другим транзакциям, обеспечивая при этом более высокий уровень параллелизма? Типичным примером является попытка обновить все записи о сотрудниках за одну транзакцию. Сериализация данной транзакции обычным способом блокирует все записи и предотвращает параллелизм. Компенсационные транзакции используют другой подход, разбивая большую транзакцию на «сагу», состоящую из нескольких субтранзакций, каждая из которых фиксируется по мере выполнения. Таким образом, для того, чтобы прервать более крупную транзакцию, система должна отменить каждую совершенную субтранзакцию, создавая при этом новую транзакцию, которая корректирует ее последствия — компенсирующую транзакцию.
Таким образом, основная цель заключается в том, чтобы избежать отмены транзакций, которые использовали неправильно зафиксированные данные. Корректность данного подхода зависит не от сериализуемости или изоляции, а скорее от чистого влияния последовательности транзакций на состояние и выходные данные. Вопрос в том, оказывается ли база данных после компенсации в месте, эквивалентном тому, где она была бы, если бы субтранзакции никогда не выполнялись? Эквивалентность должна включать внешние действия; например, возврат денег за дублирующую покупку – это не то же самое, что и не взимать плату с этого клиента сразу, хотя, возможно, в определенном смысле это эквивалентные решения. Та же идея сохраняется и при восстановлении после разделения. Поставщик услуг или продуктов не всегда сразу же может исправить ошибки, но стремится признать их и предпринять компенсирующие меры. Вопрос о том, как лучше всего применить эти идеи для восстановления после разделений, до сих пор остается открытым.
Разработчики систем не должны слепо жертвовать согласованностью или доступностью при наличии разделений. Используя предложенный подход, они могут оптимизировать оба свойства за счет тщательного управления инвариантами во время разделения. По мере того, как новые методы, такие как векторы версий и CRDT, внедряются во фреймворки, упрощающие их использование, данный вид оптимизации должен получить более широкое распространение. Однако, в отличие от транзакций ACID, данный подход требует более продуманного развертывания по сравнению с прошлыми стратегиями, лучшие решения будут в значительной степени зависеть от конкретных инвариантов и операций сервиса.
Решения по компенсации, предусмотренные при использовании банкоматов
При проектировании банкомата логичным выбором кажется строгая согласованность, но на практике приоритет отдается A. Причина достаточно проста: более высокая доступность означает более высокий доход. Так или иначе, конструкция банкомата служит хорошим примером для рассмотрения некоторых проблем, связанных с компенсацией инвариантных нарушений во время разделения.
Основными операциями банкомата являются внесение средств, снятие средств и проверка баланса. Ключевым инвариантом является то, что баланс должен быть равен нулю или выше. Поскольку инвариант может нарушить только снятие средств, для него потребуется специальная обработка, две другие операции могут быть выполнены всегда.
Разработчик системы банкоматов может запретить снятие средств во время разделения, поскольку в это время невозможно узнать истинный баланс, при этом он поставит под угрозу доступность. Вместо этого, используя режим ожидания (режим разделения), современные банкоматы ограничивают снятие средств, например, до $200. Ниже этого лимита снятие средств осуществляется беспрепятственно; как только лимит достигнут, система отказывает в снятии средств. Таким образом, банкомат выбирает сложный лимит доступности, который разрешает снятие средств, но ограничивает риски.
По окончании разделения должен быть предусмотрен способ восстановления согласованности, а также способ исправления ошибок, допущенных при разделении системы. Восстановить состояние просто, поскольку операции коммутативны, исправление ошибок же может принимать несколько форм. Окончательный баланс ниже нуля нарушает инвариант. Банкомат выдал деньги, из-за чего ошибка стала внешней. Банк компенсирует это, взимая комиссию и ожидая погашения задолженности. Учитывая, что риск ограничен, проблема не столь серьезная. Однако предположим, что баланс был ниже нуля в какой-то момент во время разделения (неизвестный банкомату), но более поздний депозит восстановил его. В этом случае банк может по-прежнему взимать комиссию за овердрафт задним числом или игнорировать нарушение, так как клиент уже произвел необходимый платеж.
В целом, из-за задержек связи правильная работа банковской системы зависит не от согласованности, а скорее от аудита. Ещё один пример — «check kiting», когда клиент снимает деньги в нескольких отделениях до того, как они смогут связаться между собой, и исчезает. Овердрафт будет взыскан позже, что, возможно, приведет к компенсации через суд.


