

Введение в Apache Doris: хранилище данных нового поколения
Предлагаю Вашему вниманию технический обзор Apache Doris. Давайте поговорим о том, как именно данный инструмент обеспечивает высокую производительность запросов благодаря своим архитектурным особенностям и функционалу.
Что такое Apache Doris?
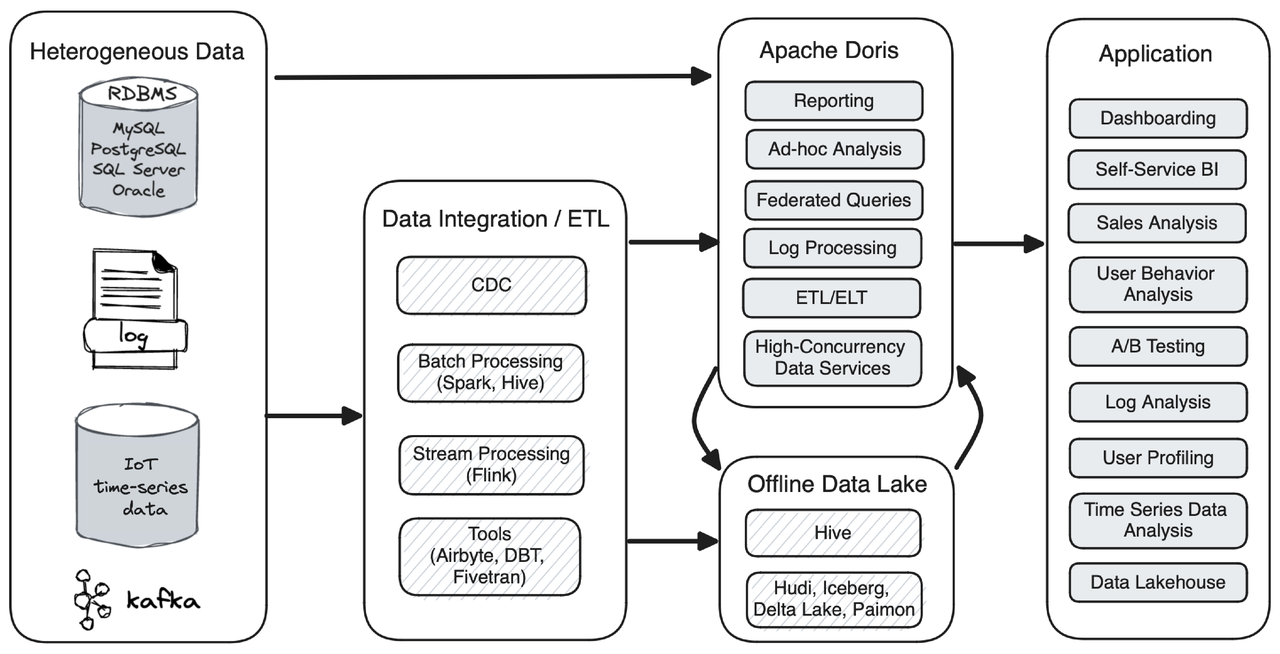
Apache Doris - это open-source хранилище данных, работающее в режиме реального времени. Оно может собирать данные из самых различных источников, включая реляционные базы данных (MySQL, PostgreSQL, SQL Server, Oracle и т. д.), а также журналы и данные временных рядов с IoT-устройств. Данный инструмент способен создавать отчеты, проводить специальный анализ, выполнять объединенные запросы и анализировать журналы, поэтому его можно использовать для создания дашбордов, A/B-тестирования, анализа поведения пользователей и т. д.
Apache Doris поддерживает как пакетный импорт, так и потоковую запись. Он может быть с легкостью интегрирован с Apache Spark, Apache Hive, Apache Flink, Airbyte, DBT и Fivetran. Кроме того,его можно подключить к озерам данных, таким как Apache Hive, Apache Hudi, Apache Iceberg, Delta Lake и Apache Paimon.
Производительность
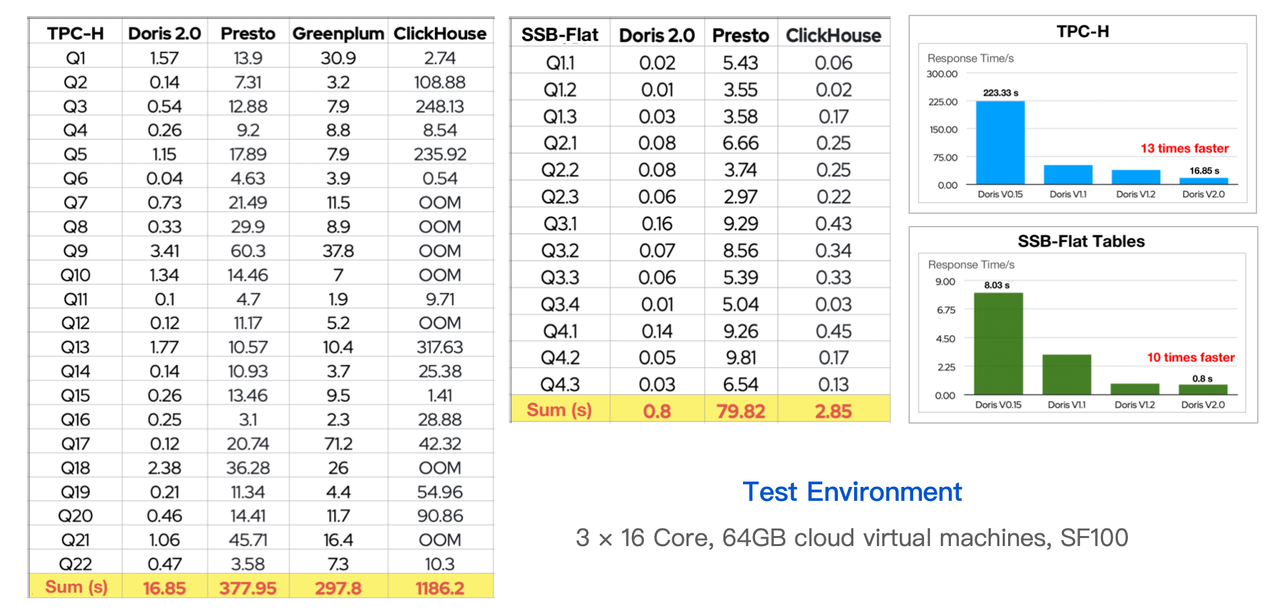
Будучи OLAP-движком, работающим в режиме реального времени, Apache Doris имеет огромное конкурентное преимущество в плане скорости выполнения запросов. Согласно данным TPC-H и SSB-Flat, Doris может обеспечить гораздо более высокую производительность, чем Presto, Greenplum и ClickHouse.
Что касается его развития, то за последние два года он увеличил скорость выполнения запросов более чем в десять раз.
Архитектура
За высокой скоростью работы Apache Doris стоят архитектурные особенности, широкий функционал и механизмы, которые способствуют повышению производительности Doris.
Прежде всего, Apache Doris имеет оптимизатор на основе затрат (CBO), который может определить наиболее эффективный план выполнения самых сложных запросов. Он обладает полностью векторным механизмом выполнения запросов, что позволяет значительно сократить количество виртуальных вызовов и кэш-промахов. Данный инструмент основан на MPP (Massively Parallel Processing), поэтому может в полной мере использовать все возможности виртуальных машин и ядер. В Doris выполнение запросов напрямую зависит от качества данных.
Быстрые точечные запросы для базы данных, ориентированной на столбцы
Apache Doris - это колоночная база данных, поэтому она может значительно упростить и ускорить процесс сжатия и разделения данных. Однако это может не подойти для таких случаев, как работа с клиентами. В подобных случаях платформе данных придется обрабатывать запросы от большого количества пользователей одновременно (так называемые "высококонкурентные запросы"), а использование столбцового хранилища увеличит количество операций ввода-вывода в секунду, особенно если данные расположены в плоских таблицах.
Для того, чтобы решить эту проблему, в Apache Doris реализовано гибридное хранение данных, то есть одновременное использование строкового и столбцового хранилищ.
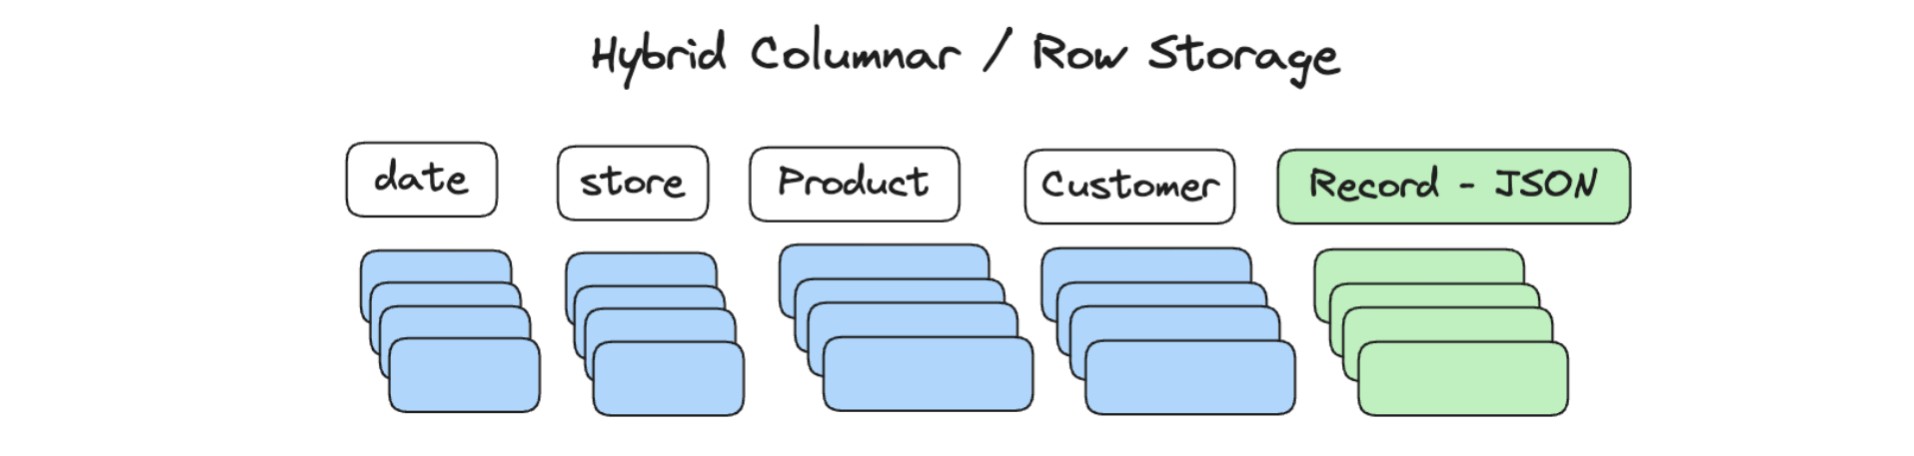
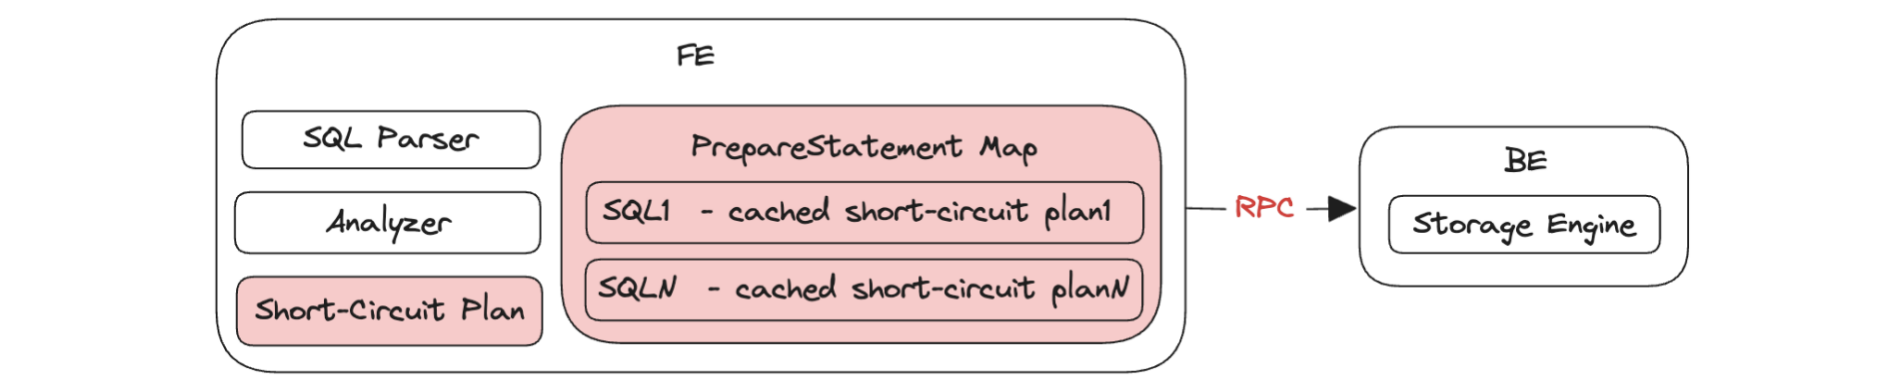
Кроме того, поскольку все точечные запросы являются простыми запросами, обращение к планировщику запросов будет излишним, поэтому Doris выполняет для них короткий план схемы, что позволяет снизить накладные расходы.
Еще один большой источник накладных расходов в высококонкурентных точечных запросах - SQL парсинг. В связи с этим в Doris есть специальные операторы. Идея состоит в том, чтобы предварительно вычислять SQL-выражения и кэшировать их, чтобы затем их можно было бы повторно использовать для аналогичных запросов.
Поглощение данных
Apache Doris предлагает широкий спектр методов поглощения данных.
Записи потока в режиме реального времени (Real-Time Stream Writing)
- Stream Load: этот метод можно использовать для записи файлов или потоков данных через HTTP. Он линейно масштабируется и в некоторых случаях может достигать пропускной способности в 10 миллионов записей в секунду.
- Коннектор Flink-Doris: Благодаря встроенному CDC, этот коннектор передает данные из OLTP-баз данных напрямую в Doris. На данный момент мы реализовали автосинхронизацию данных из MySQL и Oracle в Doris.
- Routine Load: для получения данных из очередей сообщений Kafka.
- Insert Into: особенно полезно, когда Вы пытаетесь выполнить операции ETL непосредственно в Doris, например, записать данные из одной таблицы Doris в другую.
Пакетная запись
- Spark Load: С помощью данного метода Вы можете использовать ресурсы Spark для предварительной обработки данных из HDFS перед записью непосредственно в Doris.
- Broker Load: Для поддержки протоколов HDFS и S3.
- insert into <internal table> select from <external table>: с помощью этой достаточно простой команды Вы сможете подключиь Doris к самым различным системам хранения, озерам данных и базам данных.
Обновление данных
Для обновления данных Apache Doris предлагает функции Merge on Read и Merge on Write: первый вариант - для низкочастотного пакетного обновления, второй - для записи в режиме реального времени. При использовании Merge on Write данные будут готовы к моменту выполнения запросов, и именно поэтому данная технология может повысить скорость выполнения запросов в 5-10 раз по сравнению с Merge on Read.
Doris поддерживает все самые распространенные операции обновления данных:
- Upsert: для замены или обновления всего ряда
- Частичное обновление столбцов: для обновления нескольких столбцов в ряду
- Обновление с определенным условием: для того, чтобы отфильтровать некоторые данные, объединив несколько условий, и заменить или удалить их
- Insert Overwrite: для того, чтобы переписать таблицу или раздел
В некоторых случаях обновление данных происходит параллельно, то есть поступает множество новых данных, которые пытаются изменить существующую запись, поэтому порядок обновления имеет большое значение. Именно поэтому Doris позволяет Вам определять порядок либо по фиксации транзакции, либо по порядку столбца последовательности. Кроме того, Doris поддерживает функцию удаления данных на основе заданного предиката, и именно так выполняется обновление с условием.

Доступность сервисов и надежность данных
Помимо высокой производительности выполнения запросов и получения данных, Apache Doris также обеспечивает гарантию доступности сервисов, и вот как это делается:
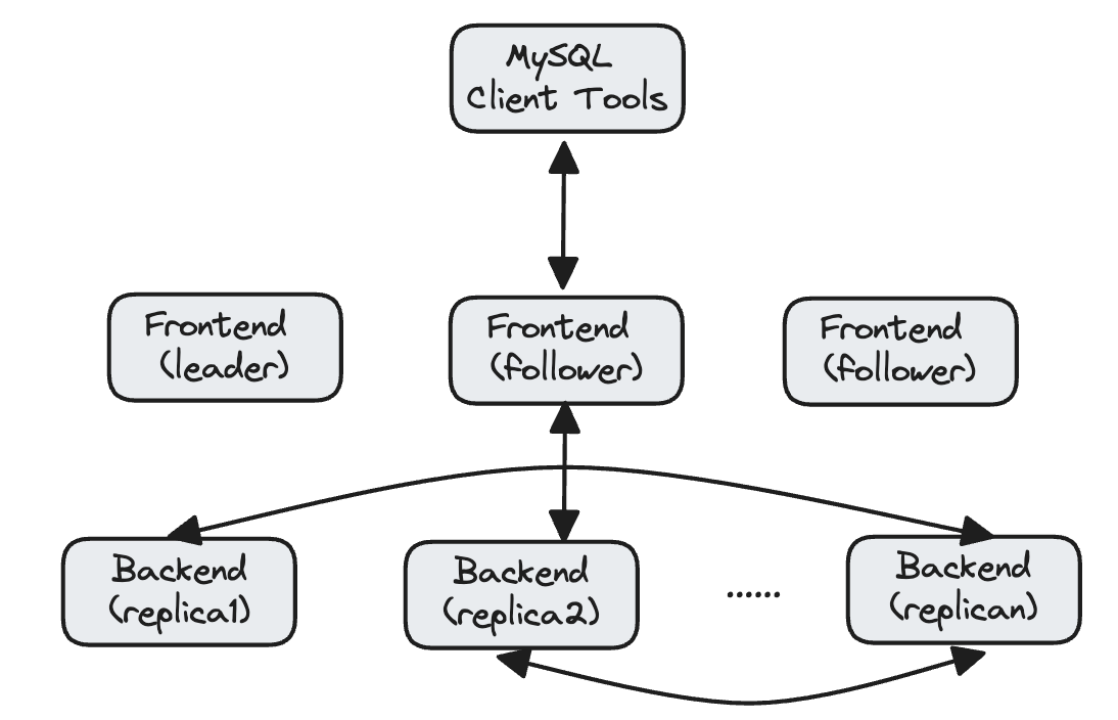
Doris состоит из двух процессов: фронтенда и бэкенда. Оба они легко масштабируются. Фронтенд-узлы управляют кластерами и метаданными, а также обрабатывают запросы пользователей; бэкенд-узлы выполняют запросы и предназначены для автоматической балансировки данных и автовосстановления. Поддерживается возможность модернизации и масштабирования кластера во избежание прерывания работы сервисов.
Межкластерная репликация
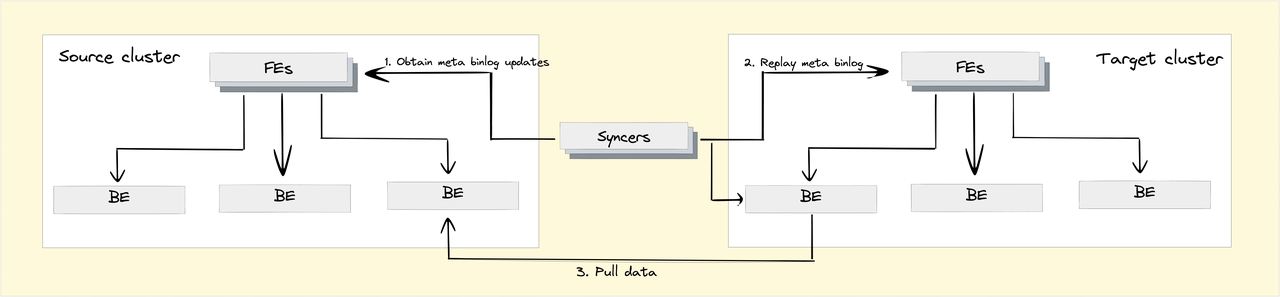
Компаниям, в первую очередь занятым в сфере финансов или электронной коммерции, необходимо создавать резервные копии кластеров или всего центра обработки данных на случай форс-мажорных обстоятельств. Поэтому в Doris 2.0 появилась функция межкластерной репликации (CCR), с помощью которой можно сделать следующее:
Аварийное восстановление: для быстрого восстановления сервисов данных
Разделение чтения и записи: ведущий (master) + ведомый (slave); один для чтения, другой для записи
Изолированное обновление кластеров: при масштабировании кластера CCR позволяет создать резервный кластер для пробного запуска, чтобы устранить возможные проблемы несовместимости и ошибки.
Многопользовательское управление
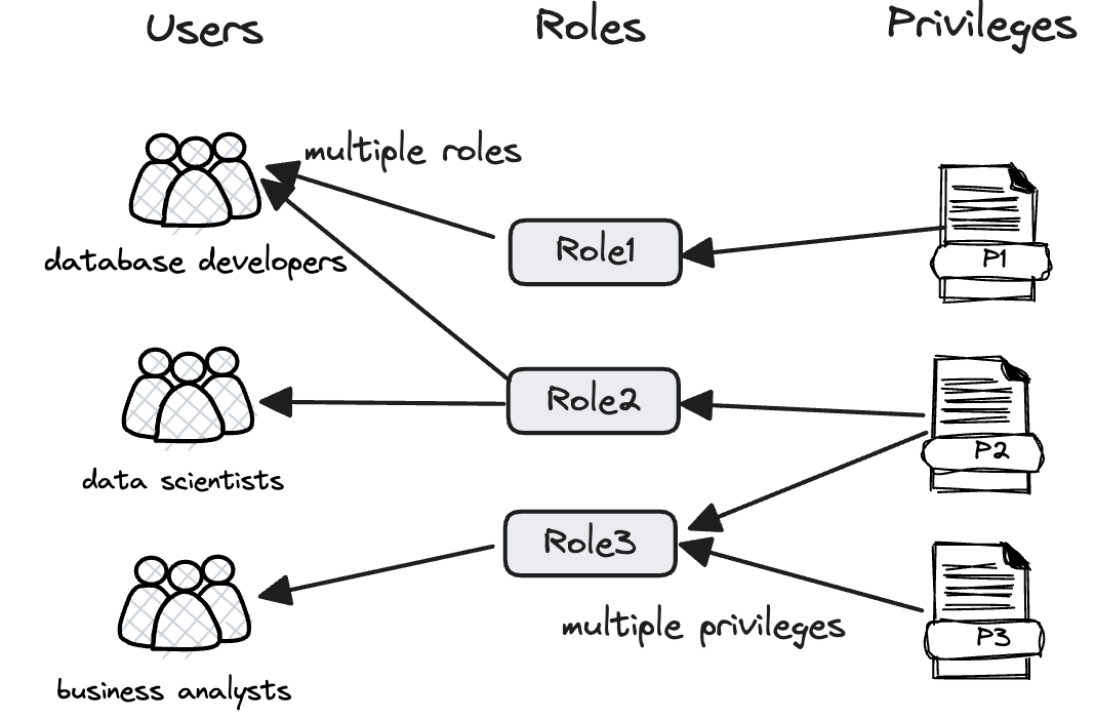
Apache Doris имеет развитую систему управления доступом на основе ролей и позволяет осуществлять тонкий контроль привилегий на уровне баз данных, таблиц, строк и столбцов:
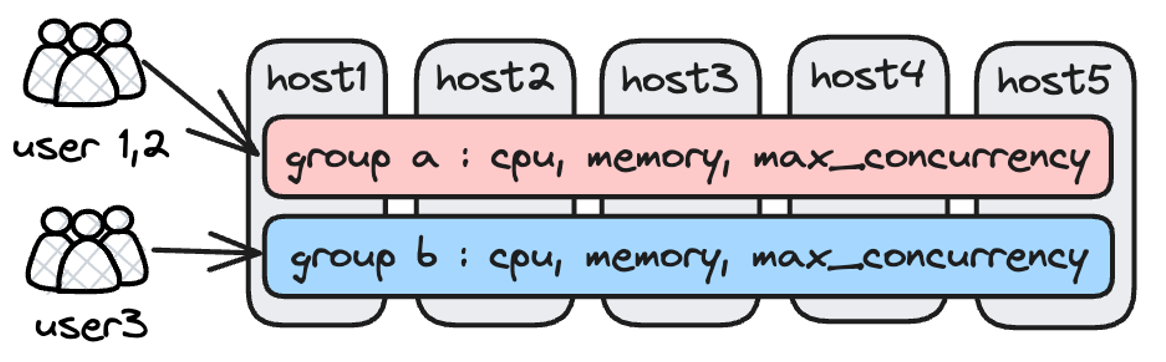
Для изоляции ресурсов Doris использовала план жесткой изоляции, который заключается в разделении узлов бэкенда на группы ресурсов и назначении групп ресурсов различным рабочим нагрузкам. Он достаточно прост и аккуратен. Но иногда пользователи могут максимально эффективно использовать свои вычислительные ресурсы, поскольку некоторые группы ресурсов простаивают.
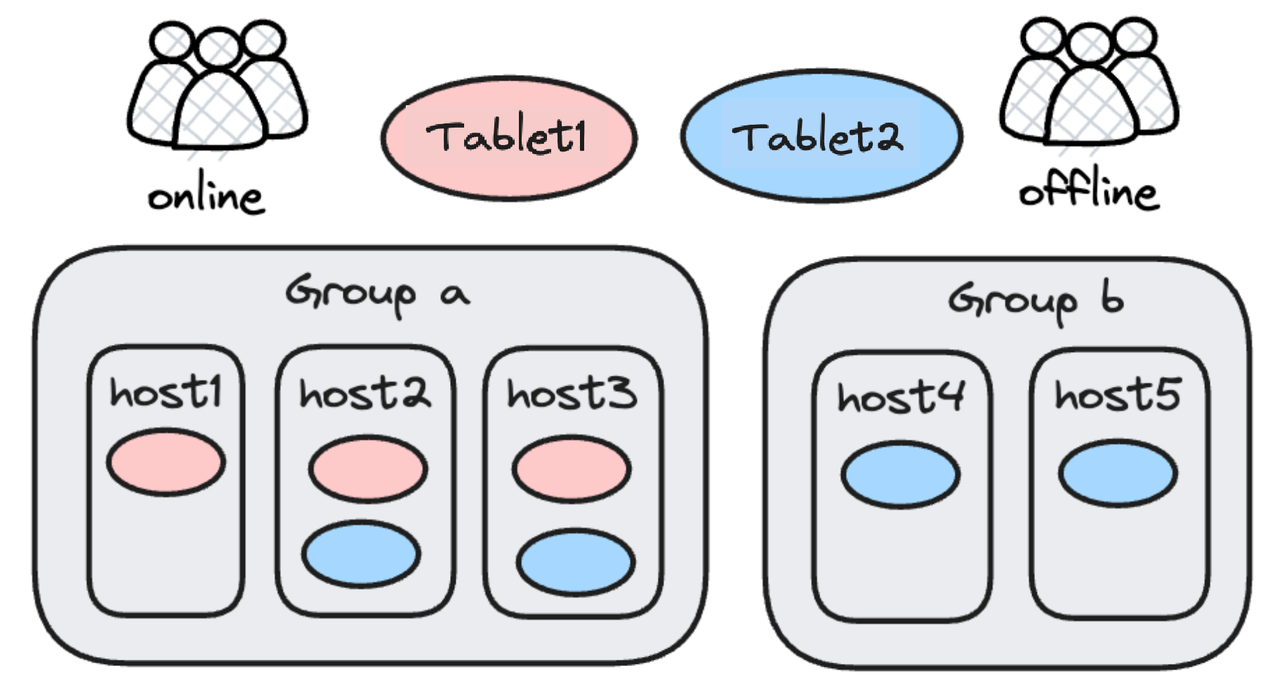
Таким образом, вместо групп ресурсов в Doris 2.0 появились группы рабочих нагрузок. Для группы рабочей нагрузки устанавливается мягкое ограничение на количество ресурсов, которые она может использовать. Когда этот мягкий предел достигнут, остаются незадействованные ресурсы, которые будут распределены между группами рабочих нагрузок. Пользователи также могут устанавливать приоритеты для групп рабочих нагрузок с точки зрения их доступа к незадействованным ресурсам.
Легкость в использовании
При всем многообразии возможностей, которые предоставляет Apache Doris, он невероятно прост в использовании. Инструмент поддерживает стандартный SQL и совместим с протоколом MySQL, а также с большинством BI-инструментов, представленных на рынке.
Дополнительная попытка повысить удобство использования - это функция Light Schema Change: если пользователям нужно добавить или удалить некоторые столбцы в таблице, им достаточно обновить метаданные во фронт-энде, при этом не нужно изменять все файлы данных. Незначительное изменение схемы может быть выполнено за миллисекунды. Данная функция также позволяет изменять индексы и типы данных столбцов. Сочетание Light Schema Change и коннектора Flink-Doris позволяет осуществлять синхронизацию данных за миллисекунды.
Полуструктурированные данные
Наиболее распространенными примерами полуструктурированных данных являются журналы и временные ряды. В данном случае особую важность имеют возможности многомерного анализа и полнотекстового поиска.
В текстовом анализе большинство людей используют оператор LIKE, поэтому мы приложили много усилий для повышения его производительности, включая перенос оператора LIKE на уровень хранения (для уменьшения сканирования данных) и внедрение NGram Bloomfilter, библиотеки регекс-сопоставления Hyperscan и алгоритма Волницкого (для сопоставления подстрок).

Кроме того, мы добавили инвертированный индекс для токенизации текста. Этот мощный инструмент для поиска по ключевым словам, а также для полнотекстового поиска.
Data Lakehouse
Для создания высокопроизводительного хранилища данных и унифицированного шлюза запросов Doris может сопоставлять, кэшировать и автоматически обновлять метаданные из внешних источников. Данный инструмент поддерживает метахранилище Hive и почти все открытые форматы озерных хранилищ данных. Вы можете подключить его к реляционным базам данных, Elasticsearch и многим другим источникам. Он позволяет повторно использовать собственные системы аутентификации, такие как Kerberos и Apache Ranger, для внешних таблиц.
Apache Doris в 3~5 раз быстрее Trino в запросах к таблицам Hive. Это результат нескольких особенностей:
- Эффективный механизм запросов
- Механизм кэширования горячих данных
- Вычислительные узлы
- Представления в Doris
Вычислительные узлы - это новое решение, появившееся в версии 2.0 для озер хранения данных. В отличие от обычных бэкэнд-узлов, вычислительные узлы не имеют статусов и не хранят никаких данных. Они также не участвуют в балансировке данных при масштабировании кластера. Таким образом, они могут гибко и легко присоединяться к кластеру во время пиковых нагрузок.
Кроме того, Doris позволяет записывать результаты вычислений из внешних таблиц в Doris для формирования представления. В некотором смысле это похоже на идею материализованных представлений. После выполнения запроса к внешним таблицам результаты можно поместить в Doris. При последующих аналогичных запросах система может напрямую считывать результаты предыдущих запросов из Doris, что ускоряет работу.
Многоуровневое хранение
Основная цель многоуровневого хранения данных - экономия средств. Многоуровневое хранение означает разделение горячих и холодных данных по разным хранилищам, при этом горячие данные - это данные, к которым обращаются часто, к холодным же данным обращаются редко. Это позволяет пользователям размещать горячие данные на быстрых, но дорогих дисках (таких как SSD и HDD), а холодные данные - в объектном хранилище.
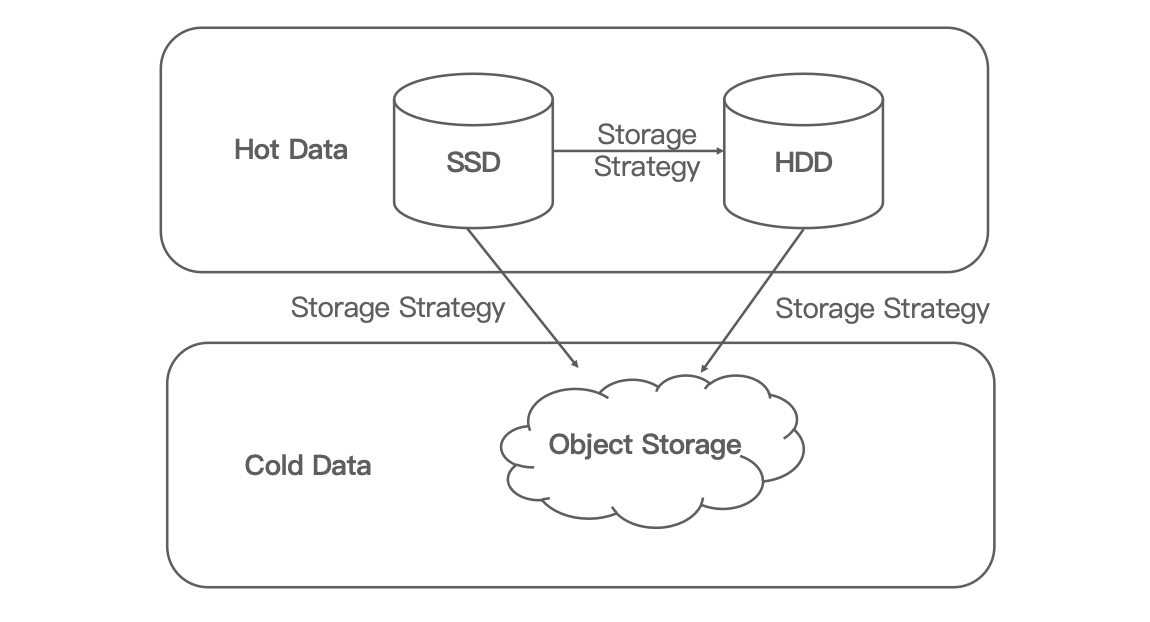
В среднем, для массива данных, состоящего на 80 % из "холодных" данных, многоуровневое хранение позволяет сократить расходы на хранение на 70 %.
Сообщество Apache Doris
Это обзор Apache Doris, хранилища данных реального времени с открытым исходным кодом. Оно активно развивается благодаря своему активному сообществу, которое обрабатывает любые вопросы, идеи и отзывы.


