

Вычисляемые поля в DataLens: формулы, функции и частые ошибки
Вычисляемые поля в DataLens помогают создавать новые показатели прямо в датасете или чарте: считать нарастающий итог, объединять строки, обрабатывать деление на ноль, использовать CASE, IF, оконные функции и условия для фильтров.
На этой странице собраны практические вопросы по вычисляемым полям в DataLens: как применять RSUM и MSUM, почему возникают ошибки агрегации, что делать с ограничениями Яндекс Метрики, как работать со строками, NULL и разными типами данных.
Что вы найдете в этом разделе:
- как сделать нарастающий итог в таблице DataLens;
- когда использовать RSUM, MSUM, LAG и BEFORE FILTER BY;
- почему появляются ошибки Inconsistent aggregation и Invalid argument types;
- как объединять текстовые поля через CONCAT;
- как обрабатывать деление на ноль;
- какие ограничения есть у подключений к Яндекс Метрике и AppMetrica;
- когда проще решить задачу через SQL-чарт.
Вычисляемые поля
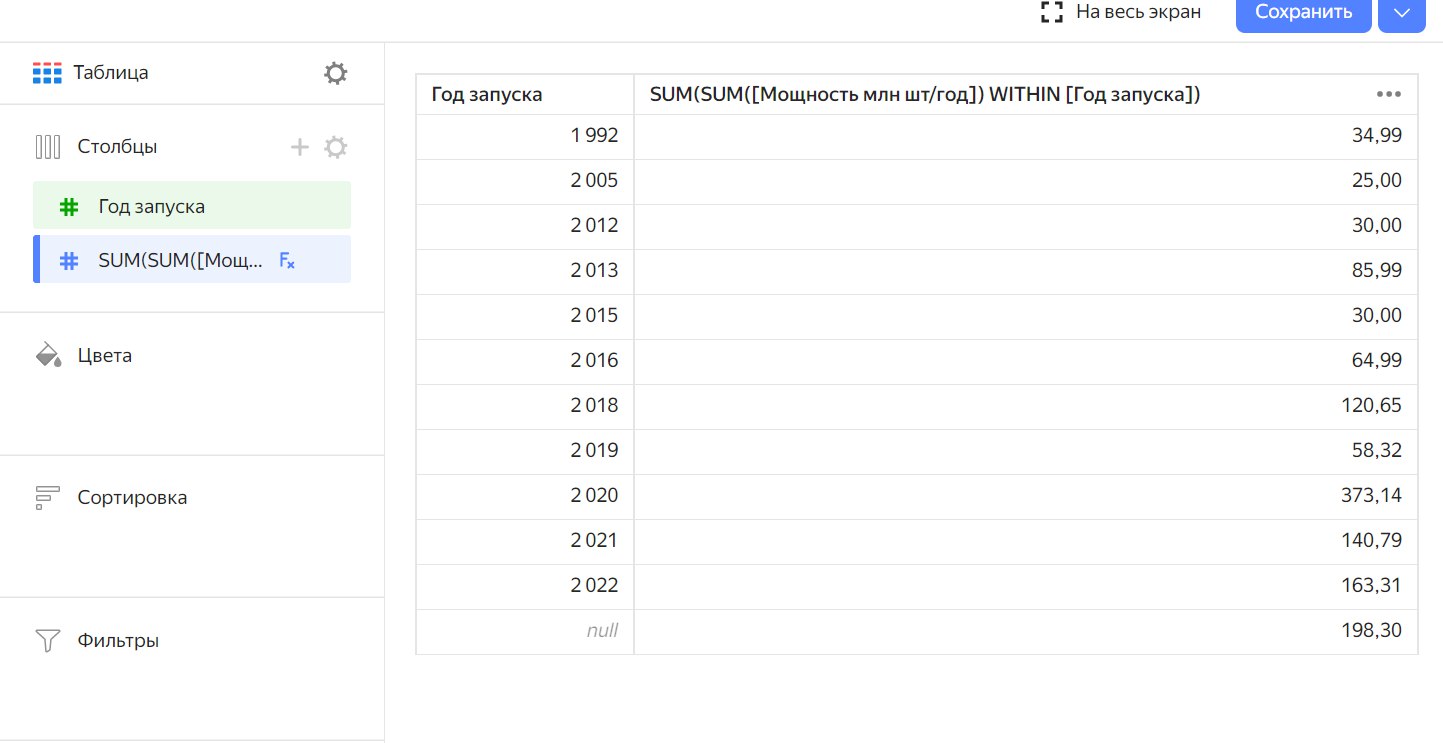
Подскажите, пожалуйста, как сделать нарастающий итог в таблице? Пока что я смогла только просуммировать значения по годам, теперь хочется, чтобы новый столбец показывал прирост значений. Как можно будет прописать функцию?
Необходимо использовать MSUM() и уже посчитанный столбец, использовать в качестве вложенного
IF([фильтр]='ozon', RSUM([count]) BEFORE FILTER BY [created_at]) Почему это не работает?
Используйте BEFORE FILTER BY ... в RSUM, а затем добавьте default result для IF
коллеги, можно ли сделать текстовое поле, собранное из двух других, но чтобы второе с новой строки начиналось
для новой строки <br> должно помочь
где новое поле будет использоваться? если на графике - будет работать
когда я int преобразую в строку, чтобы CONCAT сделать, удаляются разделители разрядом, пробелы. Видимо тут не вылечить
Лечится формулой: прописать условие добавления пробела после третьей/шестой... цифры
кто-нибудь сталкивался с ошибкой "Invalid argument types for operator _IF_BLOCK_; dialect: METRIKAAPI; types: (BOOLEAN, STRING, NULL); however, the ClickHouse database
supports such operator."
Сможете подсказать как решить?
Может другое решение подскажите, если есть опыть суть: Имеется таблица событий с яндекс метрики (подключение AppMetrica), в событии есть [Параметры событий] barcode и параметр title, но само значение barcode или title хранится в [Параметры событий: уровень 1], следовательно нужно получить в таблице все значения barcode у которых пустой title
Там целый микс из типов данных, и еще Метрика -там очень много ограничений, если прямую интеграцию использовать.
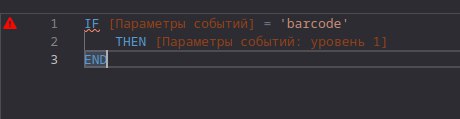
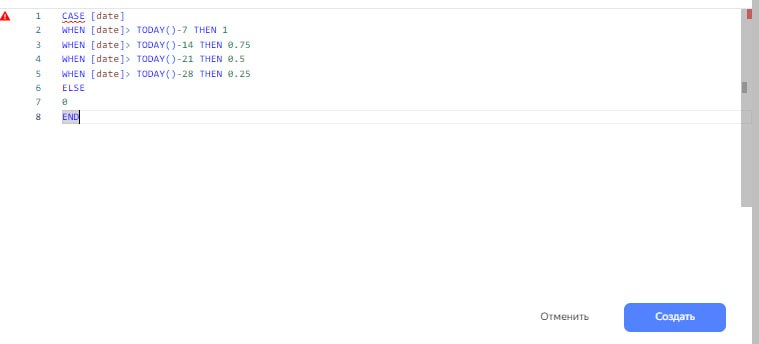
Создаю простое поле с CASE, но возникает ошибка. Вроде бы все просто, но не пойму причины. Может подскажет кто в чем дело?
Метрика не поддерживается.


Здравствуйте.
Есть датасет и под условия селекторов попадает по пять значений двух столбцов [sales_amount] и [sales_month]: типа (12, 13, 10, 20, 15) и (1, 2, 3, 4, 5). По этим значениям без проблем строится Столбчатая Диаграмма.
Далее я хочу, зная только относительное расположение, вывести на Индикаторе это значение.
Например, третье с конца: т.е. значение, которое соответствует [sales_month] = 3, т.е. [sales_amount] = 10.
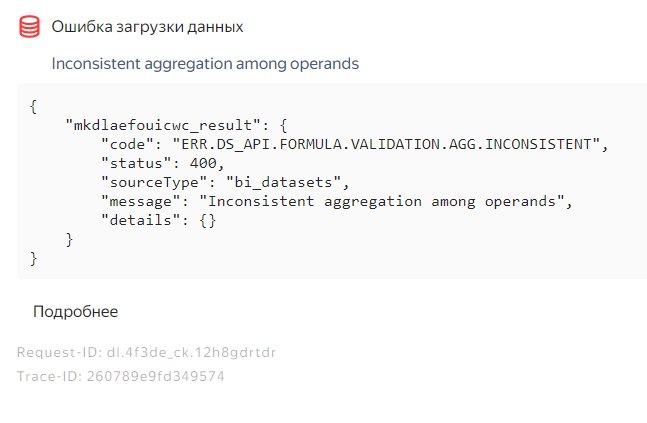
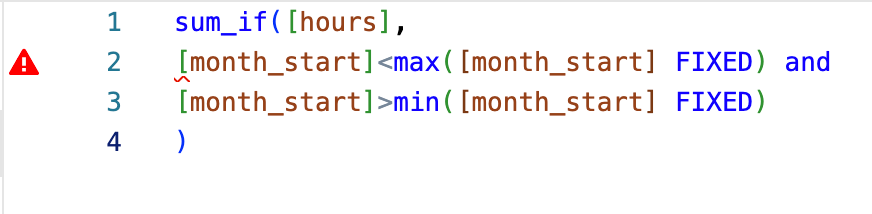
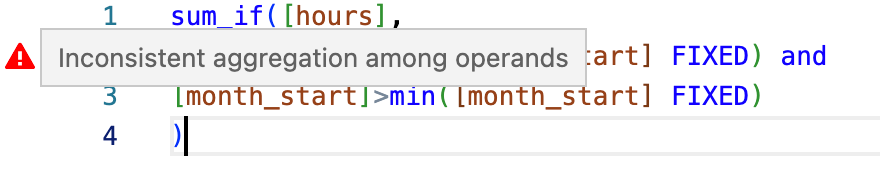
Конструкция типа LAG(sum([sales_amount]), -3 ORDER BY [sales_month]) выдает ошибку "Inconsistent aggregation among operands". Конструкция LAG([sales_amount], -3 ORDER BY [sales_month]) без ошибки, но всегда выдает 0
Проще всего через SQL-чарт
Подскажите пожалуйста, в вычисляемом поле делю два числа number_1 / number_2.
Как можно обработать ситуацию, чтобы если происходит деление на ноль, то возвращалось число 0?
зависит от вашей Базы. Где-то хватает преобразовать знаменатель к float, где-то надо делать IF
подскажите пожалуйста есть другие варианты интеграции?
avg(COUNTD([sku] INCLUDE [user_id])) - вот формула которую ищете скорее всего
А как люди оборачиваемость склада считают, например ?
в базе
в ДЛ все же показывают, а не считают
Подскажите пожалуйста, нужно сделать вычисляемое поле, которое вычисляет сумму с начала года до выбранной даты. То есть, чтобы потом чарт отображал сумму с первого числа года до выбранной даты. Возможно ли такое реализовать?
Конечно , через if
Всем привет!
У меня есть таблица
_timestamp | ID | status
23:15 | 1 | true
23:15 | 2 | true
23:16 | 1 | false
23:16| 2 | true
Мне необходимо выводить в таблицу только последнее актуальное значение по ИД. Как можно это сделать?
Да и вообще вести расчеты только с последней актуальной строчкой по таймстемпу. Как мне это делать?
MAX(MAX(LAST(sum(id) WITHIN timestamp order by timestamp) INCLUDE timestamp ))
Подскажите пожалуйста формулу для расчета доли выручки по категории товара SUM(выручка)/SUM(выручка EXCLUDE категория)
Кладете в таблицу КАТЕГОРИЯ
Возможно ли создать вычисляемое поле, основываясь на показателях из разных датасетов?
Одни датасеты из БД подключаю,
Другие из Google Sheets тяну
Соединяю эти датасеты на уровне чарта
Но новое поле почему-то дает только рассчитать по показателям этого датасета, который выбран
Нельзя, датасеты между собой не общаются кроме связанных полей
Вопрос по функции RANK.
Как сделать, чтобы она ранжировала общий итог, а не его составные части?
Пример, есть несколько организаций, по каждой известно количество сотрудников, в т.ч. отдельно мужчин и женщин.
Задача: отобрать первые 10 организаций по общему количеству сотрудников.
Делаю rank [кол-во сотрудников], а потом это поле в фильтр.
Когда просто линейчатая диаграмма - все ок. Если же в цвета добавить пол сотрудника, чтобы видеть ещё и структуру, то функция rank отбирает первые 10 не по общему количеству, а по количеству мужчин или женщин.
Как сделать, чтобы отбор оставался по общему количеству?
Подскажите пожалуйста, есть таблица, где есть поле sales, date и year_month. Нужно построить столбчатый график , где будет отображена сумма с накоплением sales по месяц.
Пробовал использовать MSUM(SUM(sales) ORDER BY year_month), но эта формула некорректная.
Как можно решить данную задачу?
запятую поставить и MSUM на RSUM заменить
подскажите какой формулой получить значение вычисления: 10% от поля с суммой (число)
10% это 0,1
Не могу найти ответ, подскажите пжлст.
Вопрос простой.
Есть таблица, два столбца:
Показатели: Выручка, Расходы.
Значения: Сумма
Как посчитать сумму для Выручки так, чтобы в таблице она была в каждой строке.
Цель научиться считать удельный вес расходов в выручке.
Или любых других показателей с помощью фильтрации.
Даны поля: дата и выручка. Надо в третьем поле подсчитать выручку с начала месяца и вывести в линейную диаграмму, чтобы была вмдна динамика в прошлом месяце и текущем. Подскажите пожалуйста формулу.
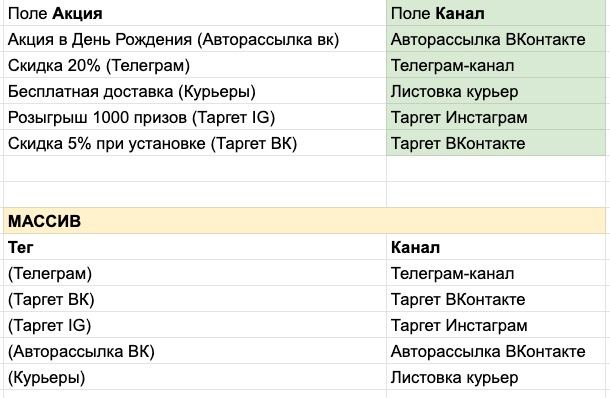
Есть поле Акции типа Строка (который содержит название акции с определенным тегом)
И есть часто дополняемый массив – соответствие Тега рекламному Каналу
Задача – создать поле Канал (на скрине зеленое), которое будет находить в поле Акции тег из массива и выдавать значение Канал, соответствующее тегу. Тогда вариант еще более удобный:
Присвоить в новом поле таблице с тегами тегам индексы. Условно, вк - 1, тг -2 и т.д. Так получите первичный ключ в таблице тегов.
А в таблице акций через условную конструкцию case создать внешний ключ через like
У меня есть датасет, состоящий из трех колонок: дата, метрика1, метрика2
Как правильно прописать формулу в вычисляемом поле, чтобы с помощью селектора выбирать, какую из двух метрик выводить на чарт (метрика1, метрика2)?
Через параметр это можно сделать, более подробно описано в демо дашборде. Если кратко, то добавляете параметр и поле, в котором при выборе одного параметра будет метрика №1, а при выборе второго метрика №2
Есть средняя скорость автомобиля:
avg(float([speed (1)]))
Но ко сожалению она считает и скорость "0" , это не правильно.
Как расчитать среднюю скорость не учитывая показатель "0"
AVG_IF( expression, condition
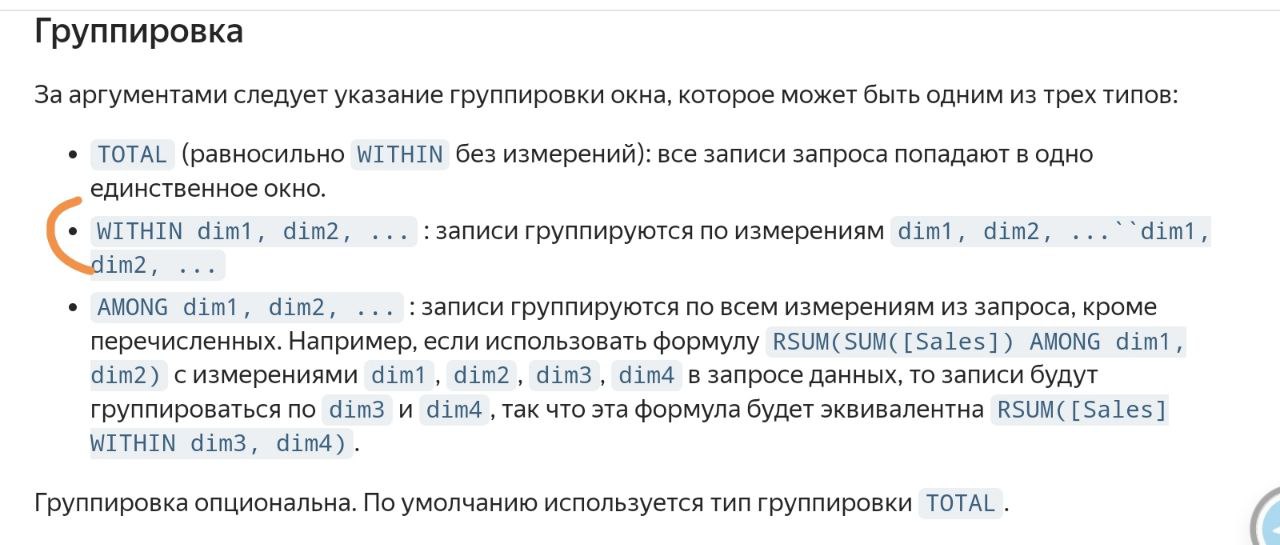
TOTAL | WITHIN ... | AMONG ...
[ BEFORE FILTER BY ... ]
)
Где можно посмотреть как создавать кагорты?
Если нужно как именно в DL можно оформить когортный анализ - это в демодашборд, там отдельная вкладка "когорты".
Подскажите какой аналог COUNT DISTINCT ? Т.е. нужно подсчитать количество уникальных значений
Countd
Я написал код в таблице чтобы вычислить полю используя if else. Еще в таблице есть иерархия. Первый слой в иерархии нормально, а вот когда нажимаю один из строк, тогда ошибка будет. Что можно сделать, подскажите пожалуйста
В DataLens вы не можете использовать в одном выражении агрегированные и неагрегированные значения. Нельзя использовать в одном выражении показатели (отображаются в датасете и в визарде синим цветом) и измерения (отображаются в датасете и в визарде зеленым цветом).Подробнее
есть [Lat] и [Lon] - координаты в отдельных столбцах
как в датасет добавить новое поле [lat,Lon] , где [ ] часть строки , в итоге в ячейке должна быть такая запись "[55.7158,37.6828]"
Concat('[',lat,lng,']') все это строки, соответственно строковыми функциями обрабатывается
Подскажите пожалуйста, в каком направлении искать гайды - создаю небольшой борд по посещаемости сайта, хочу сгруппировать в большие группы по переменным из utm_source (присвоить множественным переменным группы, что-то по типу справочника из таблиц). Буду благодарен за наводку, готовый вариант не ищу, просто хочется понять как это правильно делать в DL
лучше сделать справочник или делать вычисляемое поле с длинным CASE
Столкнулся тут с такой задачей. Нужно сделать группировку для построения гистограммы. Начал писать CASE такого вида
Но он выдает ошибку
"message": "Failed to parse formula: unexpected token"
Кейс пишу глядя в документацию и не очнь понимаю в чем ошибка, только только перешли на DataLens, осваиваю вот.
Может кто сталкивался с подобным? Помогите, пожалуйста
if-else подойдет, если условия between


есть [Lat] и [Lon] - координаты в отдельных столбцах
как в датасет добавить новое поле [lat,Lon] , где [ ] часть строки , в итоге в ячейке должна быть такая запись "[55.7158,37.6828]"
CONCAT('[',[Y],',',[X],']'), X Y
Подскажите, пожалуйста, возможно ли создать дополнительный столбик в чарте, который бы суммировал данные в этом же чарте но по конкретным столбцам?
Построение такое
Датасет 1
- Показатель 1
Датасет 2
- Показатель 2
Датасет 3
- Показатель 3
Разные датасеты т.к. разные источники
На основании трех датасетов построил один чарт, в нем:
- Показатель 1
- Расчетное поле которое показывает «место» - 1 лучший…20 худший
- Показатель 2
- Расчетное поле которое показывает «место» - 1 лучший…20 худший
- Показатель 3
- Расчетное поле которое показывает «место» - 1 лучший…20 худший
Получилась таблица с 6ю столбцами
Как можно добавить (и можно ли) еще один столбец, который бы суммировал места показателей 1, 2, 3?
На стороне источников считать надо, в ДЛ никак не получится.Вместе показать - да, но не считать.
Мне нужно было в сводной таблице нужно показать значение, которое из которого вычитавется значение из другой таблицы. То есть код примерно так у меня выглядел: sum([К1]- SUM_IF([table.lost_stage]= "П1") - где leads_table.lost_stage - это значение из другого датасета. У меня не особо это получилось и соответственно у меня вопрос такое вообще можно сделать или у меня проблема в запросе
нет
Подскажите, пожалуйста, в датасете определенный столбик содержит пустоту.
Необходимо создать дополнительный столбец, который бы преобразовывал пустые ячейки в 0
не могу найти функцию как это сделать?
Ifnull
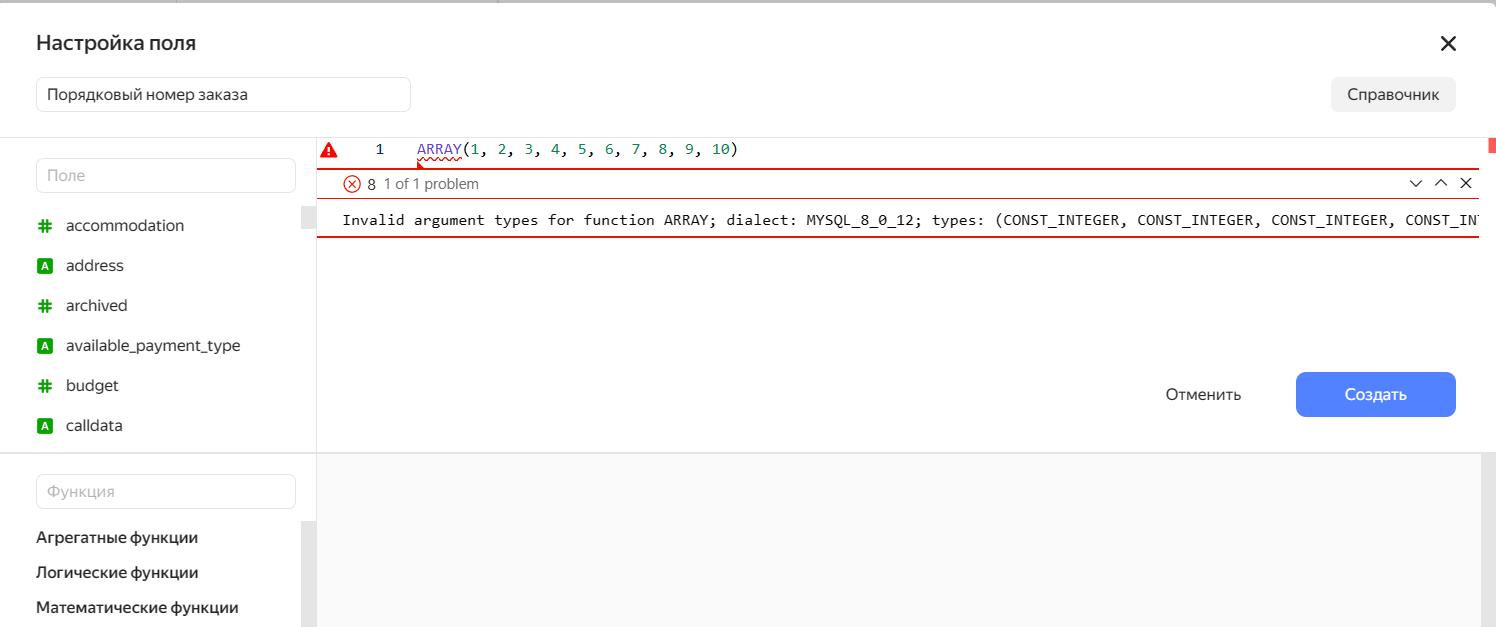
подскажите, пожалуйста, как создать новое поле с цифрами от 1 до 10? При попытке создать с помощью ARRAY вылезает ошибка.
Этой функции для MySQL нет, ее аналог это select * from numbers(10);
или
select arrayJoin(range(5));
Если в сводной таблице данные из двух google sheets, можно ли в вычисляемом столбце использовать столбцы из обоих источников? если нет, как обойти этот запрет?
Нельзя два разных источника посчитать между собой в ДЛ.
Эту историю легко обойти в самих таблицах, можно сделать готовую плоскую таблицу для Datalens, и в Datalens останется только красоту навести.
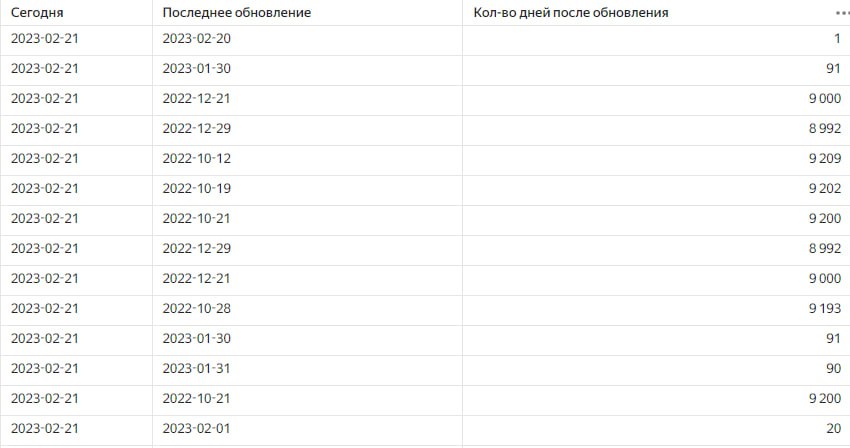
Необходима разница между сегодняшней датой и датой загрузки. В данный момент при вычитании дат формула срабатывает некорректно (в пределах месяца считает нормально).
Использую формулу:
TODAY()-[Последнее обновление]
Потому что вычитание производилось не числа дней из числа дней, а из числа 20230221 числа 20230130 - вот вам и 91. Поможет эта формула:
INT((INT([date2])-INT([date1]))/86400)
как добавить в ql-чарт свой столбец с условием if?
Прописать его в своём запросе вместе с остальными столбцами
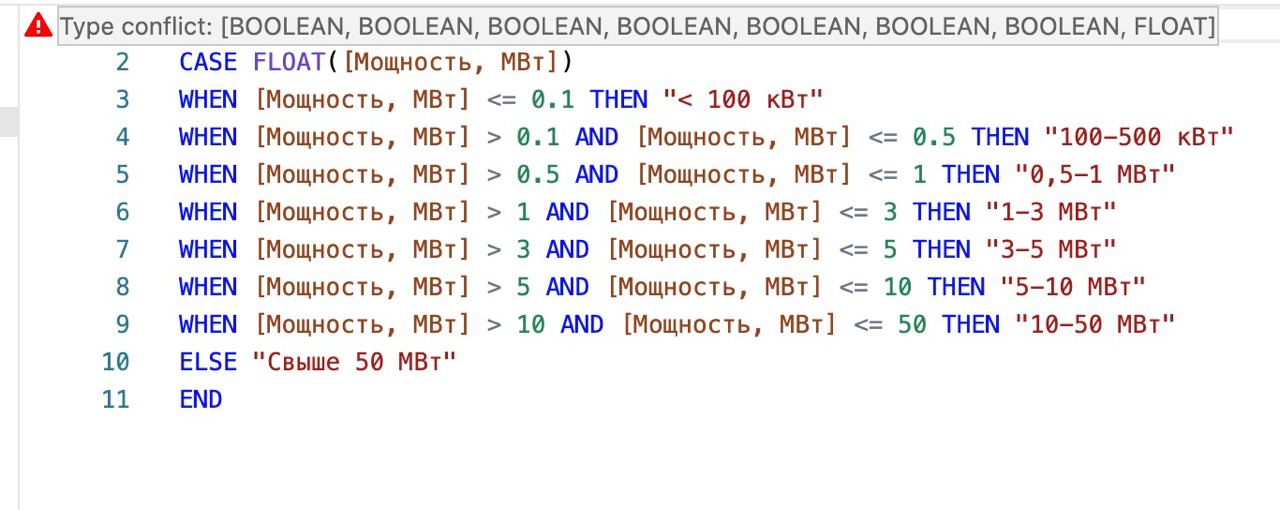
В чем ошибка?
Нет же тут никакого FLOAT - везде текст возвращает. С условиями используется if else, не case
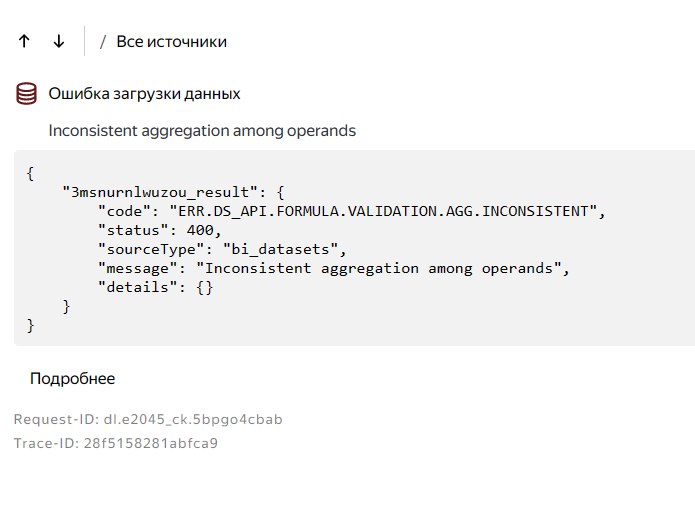
подскажите пожалуйста, можно реализовать с помощью параметров вывод либо в числе либо в проценте if(
[currency1] = 'RUB', [Значение параметра Размерность],
[currency1] = 'Percent', SUM([Значение параметра])/SUM([Значение параметра] EXCLUDE [Источник]), 0.) такая ошибка
несовместимые агрегированные значения, нужно совмещать построчно или делать агрегирование одного уровня
подскажите пожалуйста как из поля datetime взять только дату?
ddmmyyyy (это в настройках поля), либо функция DATE
Мне необходимо сделать разницу в сравнении год к году, мес к мес и день ко дню. Т.е. есть показатели, как сделать год к году и мес к мес я примерно поняла, но это будет больше топорно через if, но вот как сделать день ко дню не понимаю. Т.е. допустим у меня есть с 1.03 по 3.03 и мне нужно сравнить это с 1.02 по 3.02. Возможно есть более гибкое решение, которое не нужно выводить через if закладывая каждый период (в случае с годом и месяцем)?
Через if делать две колонки, в одну собирать ту, что от начала предыдущего периода до порядкового номера дня в периоде. Во второй то же самое, но для текущего периода. Например, от первого дня недели (месяца) до порядкового дня недели (месяца)
Подскажите пожалуйста, есть в даталенс функция заливки ячейки цветом по условию.

Подскажите, пожалуйста, можно ли в datalens посчитать среднее взвешенное значение?
У вас есть столбец, есть веса, перемножьте, а затем поделите на сумму весов. Готово
Подскажите пожалуйста по следующему вопросу - у меня есть секунды. Как можно секунды преобразовать во время? Например есть 78 секунд и нужно чтобы было так - 00:01:18
это не время, это строка. Соответственно и преобразовывать нужно их
Подскажите, пожалуйста, как в сводные таблицы в DataLens добавить столбец, аналогичный счетесли? Пробовала добавить вычисляемый показатель COUNT_IF([остатки]>0), но он добавляется в каждый столбец с датой. Как сделать, чтобы он выводился только один раз в конце таблицы (последним столбцом)? И чтобы пересчитывался, если в селекторе меняешь дату?
Сделать такую таблицу в базе и отдельным полем в ней посчитать и это поле :)
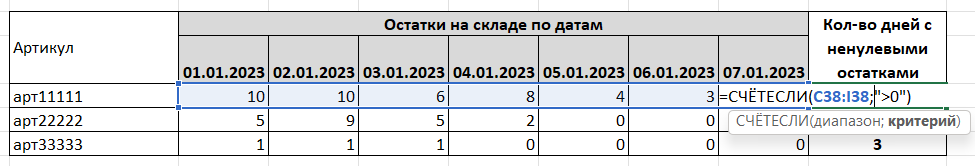
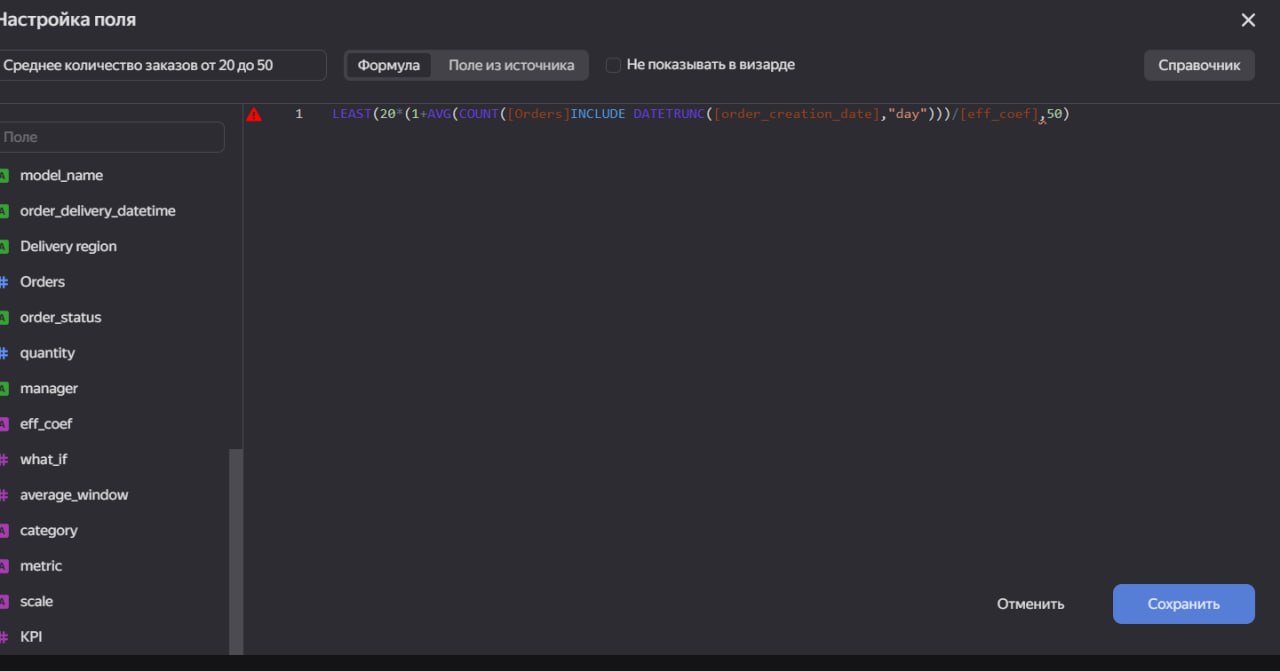
Подскажите, где может быть ошибка
Ошибка в скобках
как убрать с графика нулевые значения? Спасибо.
Воспользоваться фильтром

Есть два столбика
Кол-во Заказ
Как посчитать сумму по столбцу кол-во только для уникальных заказов?
Через if countd(заказ)>0 then sum(кол-во) end
функцию TOP_CONCAT() как-то можно применить для создания поля, если используется подключение к Postgresql? Может есть какие-то альтернативные варианты?
Нужно вывести на индикатор моду строкового типа.
Нет, ищите аналог для ПГ и делайте на стороне базы, а строки в индикатор выводятся через группировки типа ANY
какая функция выводит все уникальные значения, встречающиеся в диапазоне?
В столбце? Дистинкт
подскажите пожалуйста как этот демо-дашборд называется
https://cloud.yandex.ru/marketplace/products/yandex/demo-dashboard
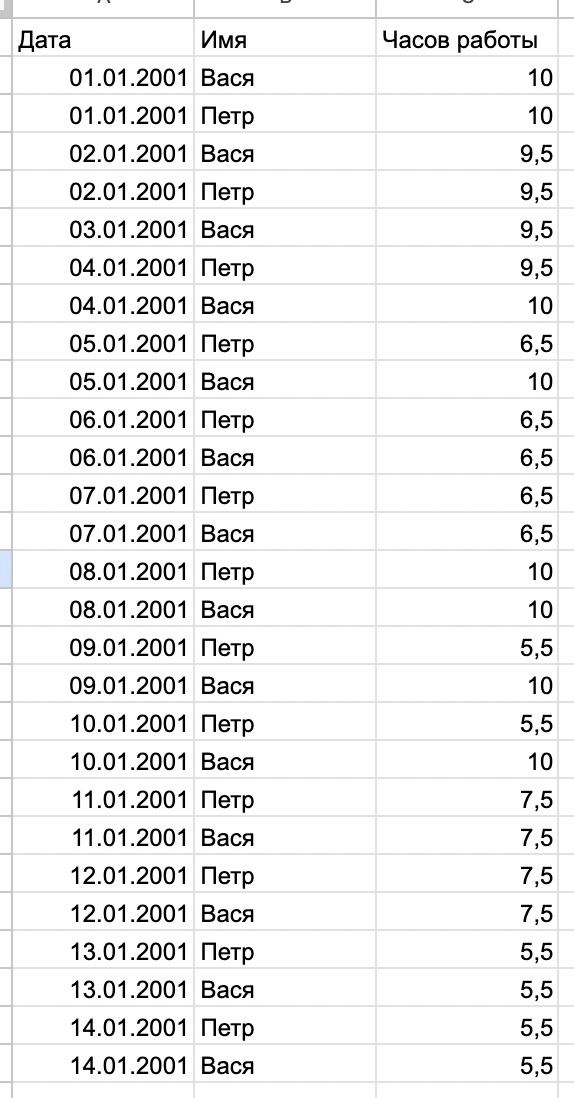
подскажите пожалуйста, по какой формуле можно сложить сумму часов работы Васи и Пети за определённую неделю (допустим за 01.01.2001 - 07.01.2001)
И отобразить в определенном столбце? Дабы в дальнейшем вычислить % разницы, кто где отработал больше / меньше.
https://datalens.yandex/9fms9uae7ip02?tab=Are
Добрый день, исходный тип данных - Строка, пример:
FHD-монитор CF39 [C24F390FHI]
FHD-монитор T45F [F27T450FZI]
Игровой монитор Odyssey G7 [C32G75TQSI]
UHD-монитор UR55 [U28R550UQI]
Мышь проводная Aceline CM-408BU черный [800 dpi, светодиодный, USB Type-A, кнопки - 3]
Мышь проводная Aceline CM-407BU черный [800 dpi, светодиодный, USB Type-A, кнопки - 3]
Мышь проводная Aceline CM-710BU черный [1000 dpi, светодиодный, USB Type-A, кнопки - 3]
Ключевые слова из названий - монитор \ мышь.
Какой формулой можно посчитать их кол-во по ключевым словам и отобразить это в сводной таблице?
Желаемое отображение:
Монитор - 4 \ Мышь - 3
Создайте вычисляемое поле, где будет Мышь/Комп. Определить значение можно с помощью CONTAINS.
Далее, это поле в столбцы можно добавить, будет два столба - Комп и Мышь.
Можно также еще считать по условию - COUNT_IF, в условие CONTAINS
Добрый день, коллеги.
можете помочь.
есть поле (строка) "Иванов Иван Иванович"
нужно сделать "Иванов И.И."
Или как вариант "ИИИ"
можете помочь с формулой?
SPLIT([name]," ",1) + " " + Left(SPLIT([name]," ",2),1)+"."+Left(SPLIT([name]," ",3),1)+"."
Такой матрешкой можно решить
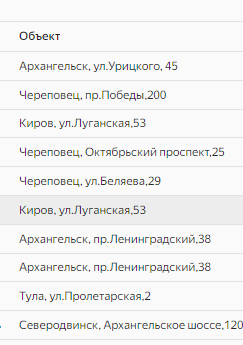
Подскажите как обрезать текст в строке до заданного символа (до ", ") , нужно оставить только города, источник GS.
В SPLIT можно индекс передавать
SPLIT([Объект],",",1)
есть ли в DataLens какой-то инструмент для удаления дубликатов строк?
Именно удаления дубликатов строк нет.
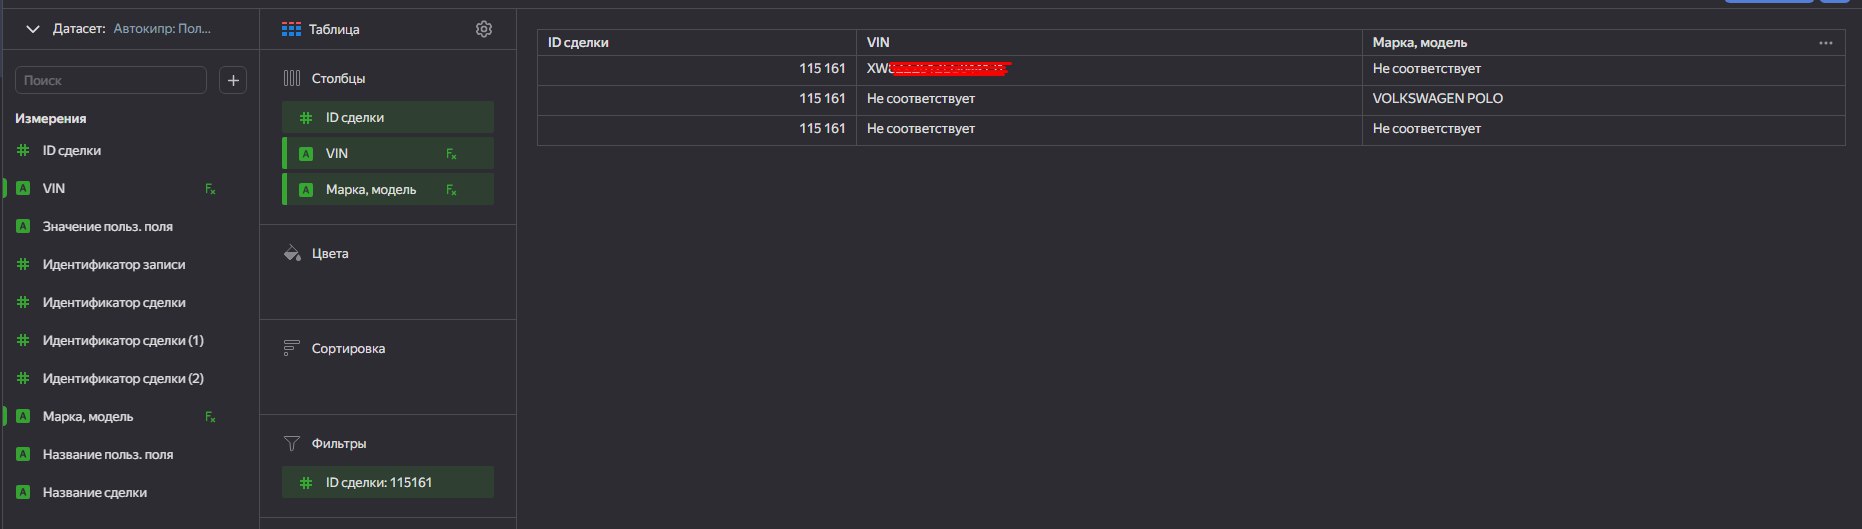
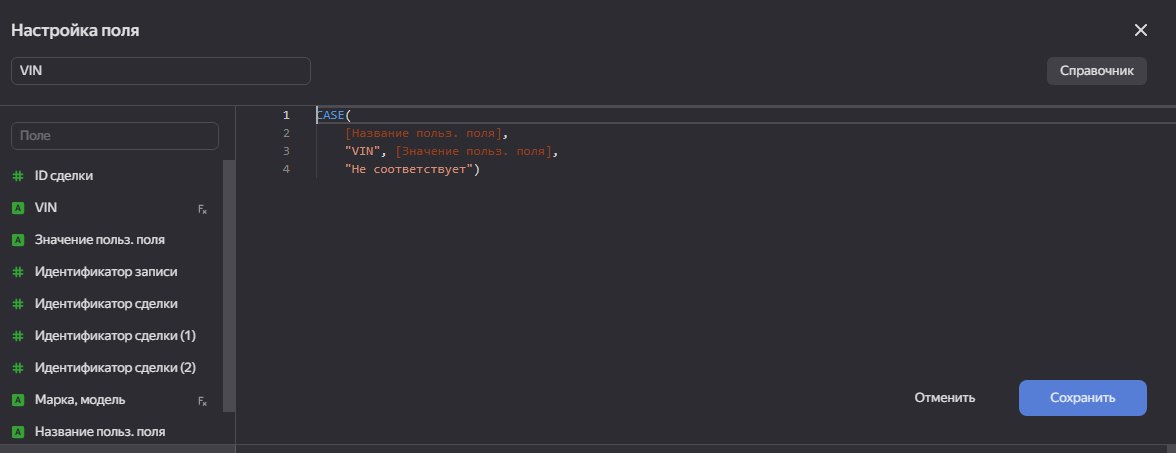
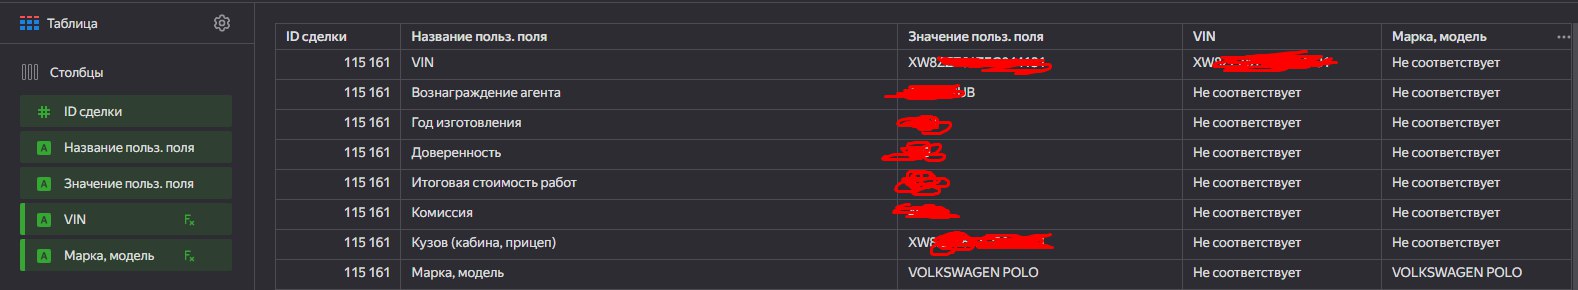
Будьте добры, подскажите, пожалуйста, выход из ситуации.
В датасете есть поле, которое, прошу прощения, содержит наименования всех польз. полей Битрикс. Второе содержит значения этих полей.
Есть задача отобразить значения двух разных полей в соседних ячейках. Пытался реализовать через CASE, но вышло не то, что я ожидал. Может подскажете какую формулу можно использовать в этом случае?
Отобразить значения двух разных полей - это CONCAT
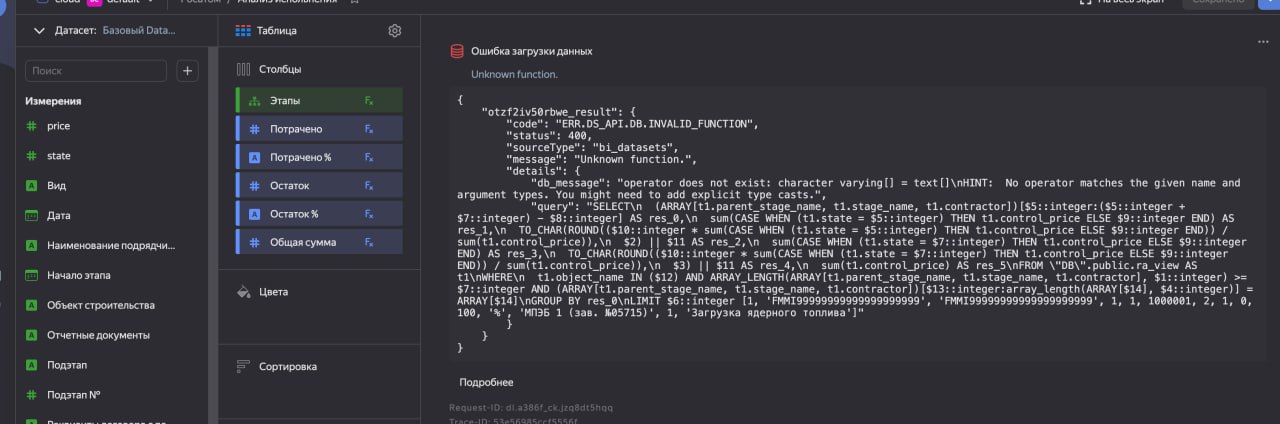
Могли бы уточнить функция TREE(ARRAY([Этап],[Подэтап])) работае в постгресе. У меня вываливается ошибка когда жму на +
У постгреса суть не в типе строка Datalens, а в типе в бд - нужен не varchar, а text
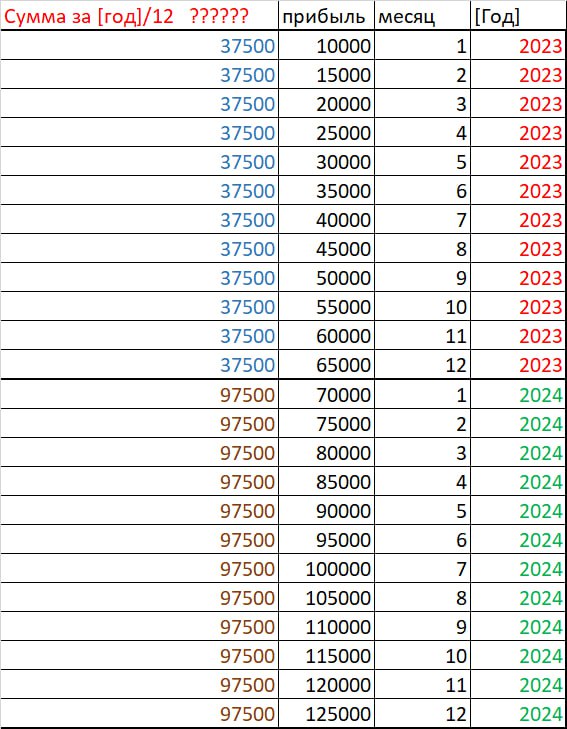
Нужно посчитать в каждой ячейке первого столбца среднюю стоимость за год. Как прописать формулу? что бы вот так выглядело в датасете
sum(прибыль within год) и делим это на 12
как получить номер последнего дня текущего месяца
взять первый день следующего месяца и вычесть 1 от результата, применить DAY()
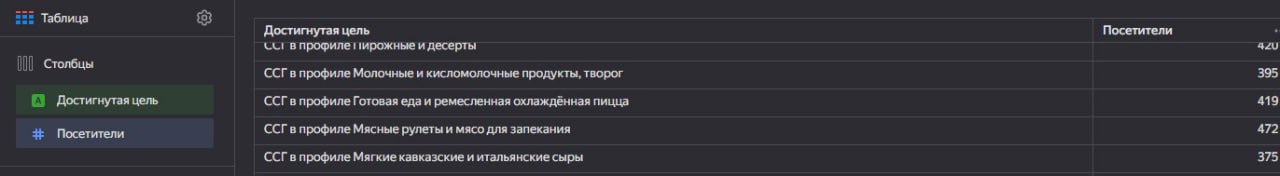
пытаюсь сделать конверсионно поле из ЯМ
Мне нужно получить достижение цели посетителя / всего посетителей
Но у меня нет поля всего посетителей , чтобы это сделать, а "конверсия по любой цели" показывает неверно
если вы берете данные из метрики через стандартное подключение, то по нему есть ограничения

Не нашел в чате информацию как добавить вычисляемое поле с суммой 2х полей из разных датасетов datalens. Поля в одинаковом формате. Между датасетами связи сейчас нет.
Никак
кто сможет подсказать как разобраться с формулой. Мне нужно по каждому человеку посчитать сколько он зарабатывает в неделю в среднем (есть данные по дням
). то есть посчитать сумму за каждую неделю и вывести среднее по всем неделям на человека. пробовала такую формулу, работает, но выдает не корректный результат
AVG(SUM([зп]) WITHIN [дата округленная до недели], [сотрудник])
. что не так?
avg(sum([зп] INCLUDE [дата до недели],[сотрудник]))
как можно построить формулу с участием полей двух разных датасетов в показатель?
спотыкаюсь об валидацию, что такого поля не существует, хотя датасеты связал
Нельзя
Не могу сообразить, как посчитать отношение двух индикаторов на основе разных датасетов и подключений? Помогите, направьте на путь..... Спасибо
Вычисляемые поля только в рамках одного датасета
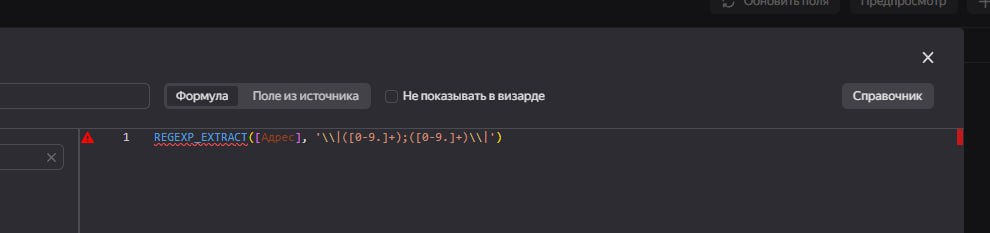
есть список урлов - как-то можно вывести поле, в котором будет домен из них вычленяться?
+ в идеале, чтоб убирал https:// и www, так как часть из урлов с ними, а часть без
Воспользуйтесь функцией REGEXP_EXTRACT.
Подскажите, можно ли диаграммой Карты на основе названий городов (или конкретных адресов), а не координат?
нет. Но вы можете загрузить таблицы с готовыми координатами и сопоставить с ним свои списки городов
в вычисляемые поля можно как-то передавать в виде параметра выбор с селектора?
Да. Только селектор этот будет с ручным вводом, не из датасета.
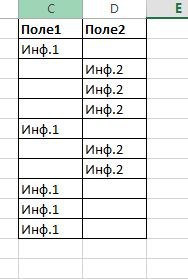
какую функцию выбрать для объединения информации из двух полей в одно. Пример полей на фото:
Собираете новое поле по условию "если одно пустое - берём другое"
У меня есть два признака , по этим двум признакам я хочу сделать группировку
Сначала необходимо найти max по этим двум признакам (это 801 и 1200)
Потом нужно их сложить получится 2001
Возможно ли такое решение сделать в DL для индикатора?
Чтобы он мне отобразил 2001?
SUM(SUM(MAX([Значение]) INCLUDE [Признак 1],[Признак 2]))
как корректно получить разницу даты и времени?
Я пробовал простым вычитанием , но мне кажется это плохой способ, да и не понятно что за значение при этом получается...
Например, 2023-04-07 09:56:10.910000 - 2023-04-07 09:55:25.742000 = 0.0005227777777777778 В часах - 0.0005227777777777778*24
В минутах - 0.0005227777777777778*24*60
В секундах - 0.0005227777777777778*24*60*60
Нужно вывести поле, где будет сумма по аналогичному показателю год назад.
При этом данные в датасете хранятся не в разрезе месяца, а как рандомные даты.
Что-то вроде LFL пытаемся настроить
Вам подойдет функция AGO. Убедитесь, что формула, используемая во втором аргументе функции, точно совпадает с формулой в оси «X».
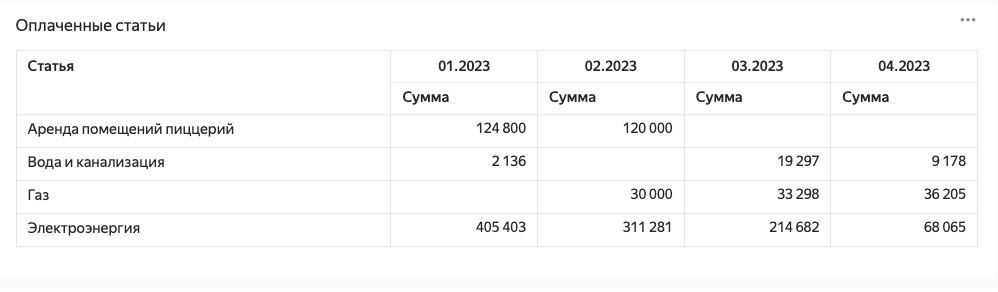
Как можно вывести начала прошлого месяца? Подскажите пожалуйста
DATETRUNC
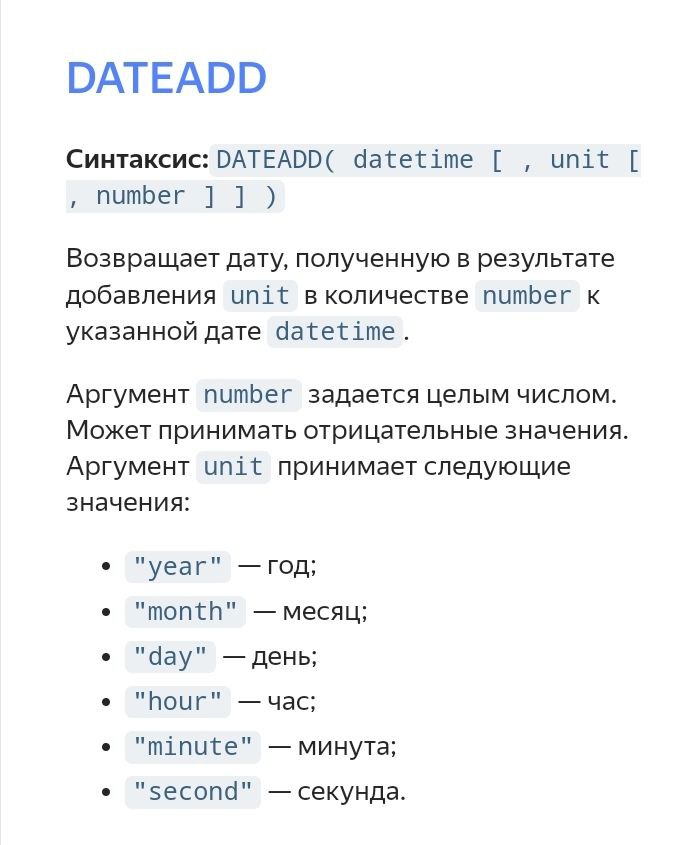
DATEADD
есть 2 столбца datetime и user_id
Нужно подсчитать, количество пользователей за каждые сутки. Пока все понятно:
DATETRUNC([datetime], "day") | COUNTD([user_id])
А вот дальше интереснее, сутки нужно считать не с 0:00 по 0:00, а с 6:00 утра по 6 утра следующего дня. То есть пользователи, пришедшие в 5:30 утра будут в отчете значиться за вчера.
DATETRUNC(
DATEADD([dt обращения], 'hour', -6),
[param_date]
)
Есть 3 связанные таблицы.
Нужно по ним построить следующую таблицу: первый столбец ID объектов, второй столбец названия объектов, третий название компании у которой есть этот объект. Однако не все значения ID заполнены. В случае, когда значения ID равно null, необходимо в соответствующем поле второго столбца написать "нет объекта". И ещё. Когда в чарте стоят только столбцы ID объекта и его название, при добавлении столбца "название компании" тут же все null меняются на какое-то число.
Не получается найти функцию которая бы меняла все значения в случае встречи с null на 0 и в имя объекта записывало бы "нет объекта"
IFNULL
Если что-то записать строкой надо, то совместно с IF можно
здесь можно ли вместо null ставит просто пустой ящик (
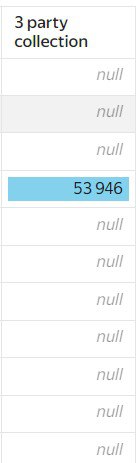
) этот столбец определяется по этой формуле (
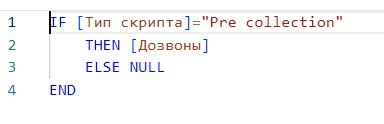
) я хочу например как на этом скрине пустой ящик (
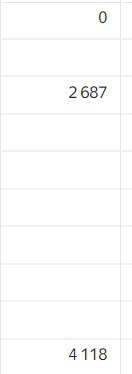
)
Поле должно быть одного типа.
есть таблица с id пользователя и номером заказа [id, order]. Иногда у пользователя может быть несколько заказов.
Как получить таблицу с id и количеством заказов у пользователя - понятно
Вопрос, как получить таблицу с количеством заказов и количеством пользователей с таким количеством заказов, соответственно
Варианты с множественными count и countd не привели ни к чему.
select coint(id), sum_val
from
(
select id,sum(val) as sum_val
from table
group by id)
group by sum_val
потому что вам нужна группировка над группировками
подскажите как в case использовать isnull, цель: есть данные null, 0,1,2,3 через кейс я их преобразовываю 0= архив, 1=новый,2=в работе, 3=завершена default= не определено и мне надо в эту схему внедрить null=удалена
Case when для работы с одним полем, принимающим разные значения. А с нуллом не сравнивают. Для полноценного условия используйте if
Подскажите формулу, которая минусует из ячейки предыдущую ячейку
В реляционной модели нет предыдущих и последующих ячеек. При заданных сортировках могут использоваться такие функции как LAG
Нужна формула, которая считает кол-во сущностей по полю UF_ID, в которых поле с датой соответствует текущему месяцу. Делаю вот так, выдает ошибку COUNTD_IF([UF_ID], [UF_UF_DATA_SOGLASOVANIYA_KP],"month")
COUNTD_IF([UF_ID],DATETRUNC([UF_UF_DATA_SOGLASOVANIYA_KP],"month")=DATETRUNC(today(),"month"))
Если у меня есть гуглотабличка в качестве датасета, то я могу достать оттуда формулой, например, последнее или предпоследнее значение из определенного столбца?
Пронумеруйте или предварительно, или ранком по какому-то условию и доставайте. Но если добавятся данные, ранк поменяется.
Подскажите, пожалуйста, есть ли функция, которая считает сумму предыдущих значений за исключением текущего? У каждого значения своя дата и она всегда растет.
Можно попробовать считать накопительную сумму и вычитать значение текущей строки. RSUM(field)-field
Подскажите аналог функции Excel «еслиошибка» для Datalens. В справочнике сказано что синтаксис как в SQL, но что-то функции через “when …then…” и через “if” не воспринимает.
И подскажите, пожалуйста, как обозначать в синтаксисе datalens в чартах значение-«ошибку».
В SQL нет функции “если ошибка”.
Нужно вывести средний показатель в %. Excel считает 98,62% (в конце столбца, желтым), а в DataLens функция MEDIAN считает 100%. С помощью какой функции можно посчитать более точно?
Если нужно вычислить среднее, то нужно использовать не median, а avg
возможно ли избавиться от плюсика на последнем уровне иерархии?
Вводит в заблуждение, кажется, что там еще что-то есть, но на самом деле это последний уровень
Нет, пока этот плюс там по умолчанию.
подскажите пожалуйста, как сделать фильтр по двум полям, например есть поле CALL_TYPE и CALL_STATUS_CODE
в первом нужны значения CALL_TYPE=1, во втором CALL_STATUS_CODE='Успешный звонок'
Ну и сумму этого всего, подозреваю итог нужно обернуть в SUM(), а вот фильтр из двух сделать не могу...
Попробуйте так sum(IF [CALL_TYPE]=1 and [CALL_STATUS_CODE]="успешный звонок" then 1 else 0 end)
Подскажите, как отформатировать разницу двух дат_со_временем в виде чч:мм?
Я рассчитываю время опоздания как [[планвремя] минус [фактвремя]], и выводить время опоздания я должен в виде часов и минут (и сортировать, чтобы самые большие опоздания были сверху).
можно сформировать с помощью деления без остатка и остатка от деления
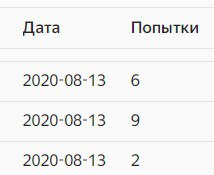
в датасете есть две столбцы: Дата и Попытки. Я хотел вычислит сумму попытки за период с 2023.05.01 по 2023.05.10. Без использование фильтры, чисто с помощью формулы. Можете подсказать, пожалуйста, как это сделать?
через IF , и sum.
есть время в милисекундах, нужно его конвертировать в мм:cc . Можете подсказать, как оптимальнее сделать?
Милисекунды / 60 000 и округляем до целого вниз = кол-во минут
(Милисекунды / 60 000 и минусуем кол-во минут) * 60 = кол-во секунд.
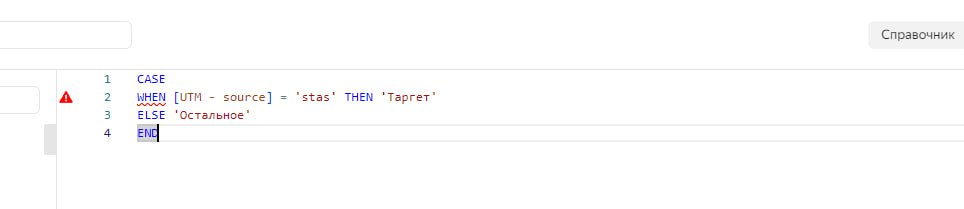
хочу сделать свое объединение меток через case для примера написал вот такую конструкцию, что не так сделал? подскажите, пожалуйста
CASE [ваше_поле]
WHEN 'stas' THEN...
Как-то можно суммировать только уникальные значения в группировке с набора данных, по указанным столбцам?
Нет
Sum distinct - редкая штука
Мне нужно получить процент заполненных значений от общего количества, пишу
ROUND([par_cnt] / [element_id] * 100 , 2)
Ругается, говорит function round(double precision, integer) does not exist
Что ему надо? В какой тип приводить? И в первом, и во втором поле целые числа - количество
Если источник PostgreSQL, то здесь решение
Как вывести дни в сводной таблице в шапке (Поле дата с группировкой по дню), если нужны вывести в том числе дни где было 0 событий. ( В датасете нет строчки с этим днем)
использовать датасет календарь и к нему джойнить основной датасет
Нужно количество уникальных значений по "Номер квс" с учетом этих исключений.
COUNTD_IF( STR([Номер КВС]) , [Социальный статус]!="БОМЖ" OR [Гражданство]!='РОССИЯ' OR [Возраст на момент госпитализации в стационар]>=1 )
Отображает полный список уникальных значений. как разобраться?
Вместо OR (или) поставьте AND (и)
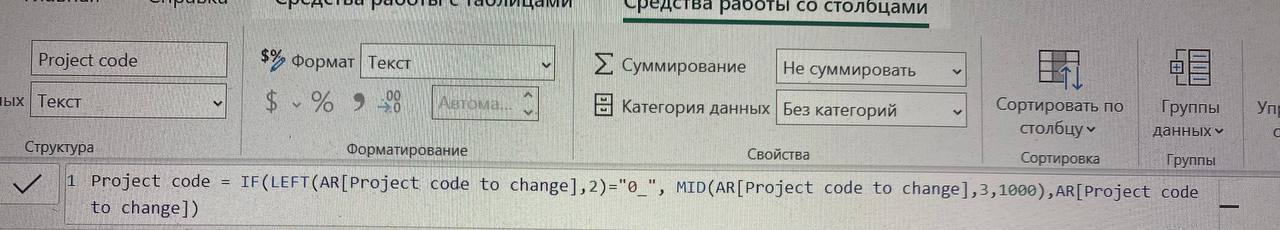
есть ли аналог MID (как в pbi), нужна формула возвращающаяся текст убрав первые 2 ненужных символа
Есть функция возвращающая подстроку с указанного символа есть поддержка регулярок. SUBSTR
А можно ли как-то написать функцию с IF, если строка содержит нужные мне слова?
Смотрите строковые функции
Подскажите какую формулу использовать (или можно без формулы), чтобы вывести не выручку в шт, а долю этой выручки от тотала
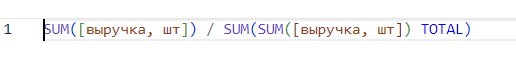
в какую сторону смотреть, что почитать, чтобы в столбчатой диаграмме по годам показать сумму накопленным итогом на дату, выбранную в селекторе? ну то есть в 2023 на 25.05 такие то продажи, в 2022 были такие то и тд. в PBI была такая возможность реализована мерой с фильтрами, тут пока не нашла
Накопленный итог - это RSUM
Можно мануал по функциям посмотреть, там лаконично всё описано.
Возможно ли посчитать retention rate в 3-ий месяц в динамике? Подскажите, пожалуйста, формулу
CRR = ((Кол-во клиентов на конец периода - Кол-во клиентов, которые пришли за весь период) / Кол-во клиентов на начало периода) * 100%
Подскажите пожалуйста, как выглядит функция count_if, если условием счета является конкретное слово в определенном поле? Не нашел в мануале.
Попробуйте, COUNT_IF([название поля] = 'Слово')
Подскажите, пожалуйста, почему при создании такого вычисляемого поля оно помещается в показатели, а не в измерения?
Мне необходимо, чтобы оно было в Измерениях. Можно ли реализовать такое поле каким-то другим образом, но чтобы оно было измерением? Потому что вычисляемое - Это показатели. Можно реализовать в базе
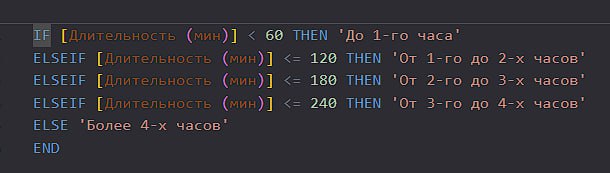
Подскажите, функции TOPONYM_TO_GEOPOLYGON больше нет? Есть ли аналог? Благодарю за помощь)
больше нет, и аналога нет. Для административных территорий можно воспользоваться готовыми наборами данных, для собственных полигонов - рисовать или экспортировать из ГИС готовые, с учетом требования ДЛ к формату записи.
сделала округление до одного знака после запятой.
Он округлил, но второй знак после запятой остался (0).
Как можно это устранить?
Если нужны %, то можете изменить в формате поля

есть ли подобное в Datalens. Необходимо объединить две таблицы, чтобы строки были друг под другом (вариант с изменением источника не подходит), в Power BI была функция Table.Combine, есть ли похожая альтернатива?
можно попробовать в чарт добавить 2 датасета:
Пример:
в чарт добавили 2 датасета с одинаковой структурой (одинаковое название измерений например, датасет 1 имеет поле1, поле2, Продажи, второй датасет поле1, поле2, Возвраты)
создаем чарт на основе одного датасета, потом добавляем второй датасет
далее настраиваем связь полей с одинаковыми названиями
и в итоге получается таблица с поле1, поле2, sum(Продажи), sum(Возвраты)
мне нужно сравнить показатели суммы по годам, использую для этого ago(). Проблема в том, что в итоговом дашборде нужно вывести данные по каждому году отдельно, а когда выбираю только один год, то данные за прошлый пропадают. Есть ли какое-то решение для этого?
Попробуем добавить в формулу расчета ago before filter by... https://cloud.yandex.ru/docs/datalens/function-ref/time-series-functions...
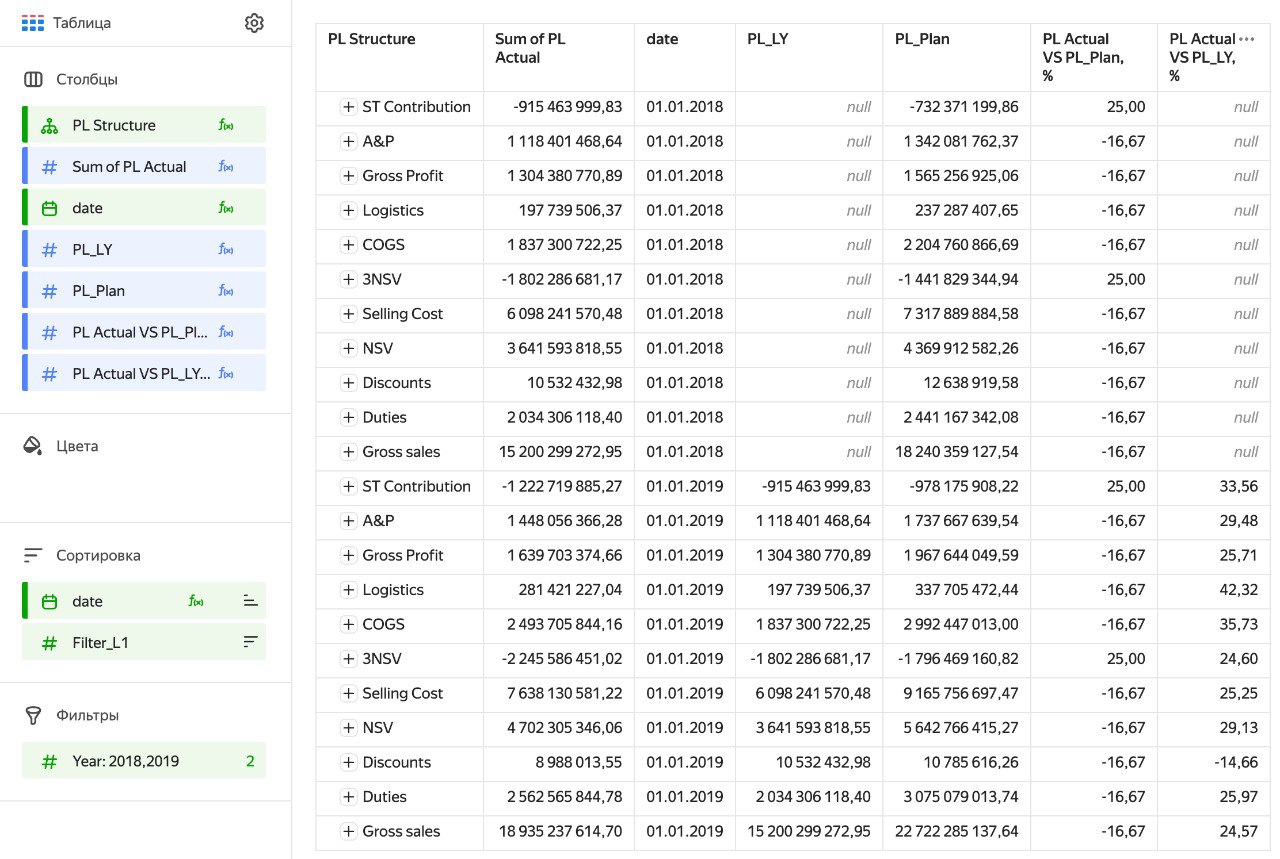

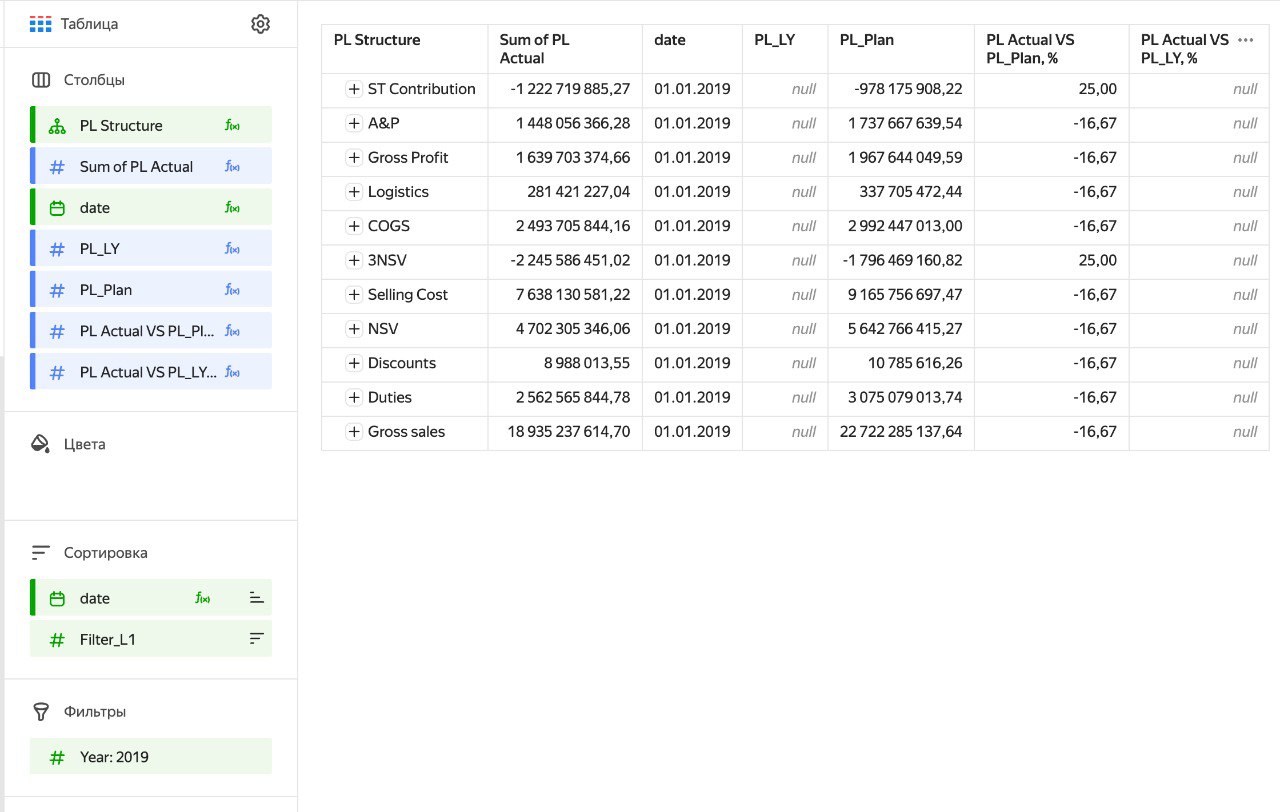
Есть поля дата/территория/прогноз/факт). Требуется выводить в чарт "Индикатор" корреляцию... Естественно чтобы фильтры учитывались, так что вариант считать заранее в БД - не выйдет. Как я понял, готовой функции нет?
Создайте переменную, и внутри укажите необходимую фильтрацию по каждому параметру, и там же выведите корреляцию
Подскажите пожалуйста, как вынуть время из даты и времени?
Вычесть дату и время округленные до начала суток
подскажите, как правильно посчитать отклонения между значениями за этот год и за предыдущий (в целом, не только текущий и предыдущий интересуют, но и между произвольными годами)
функция AGO
есть примеры на демодашборде
Нужно вывести долю каждой строчки в месяце - не могу понять, в чем ошибка?
в первом варианте формулы у меня считает от всего года
а во втором – от каждого месяца по трем годам
И год, и месяц в within киньте
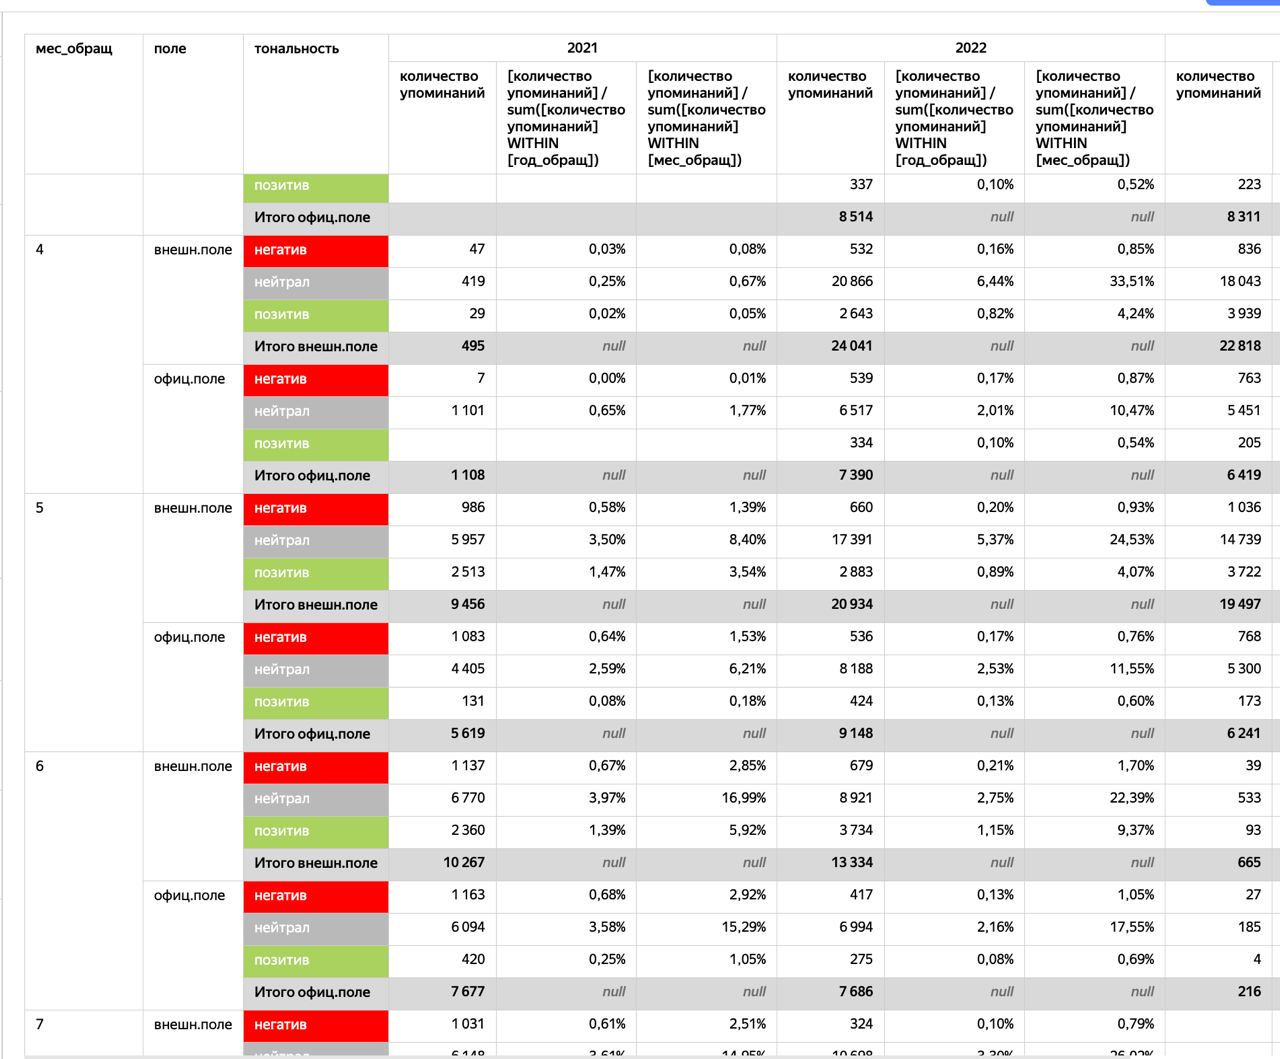
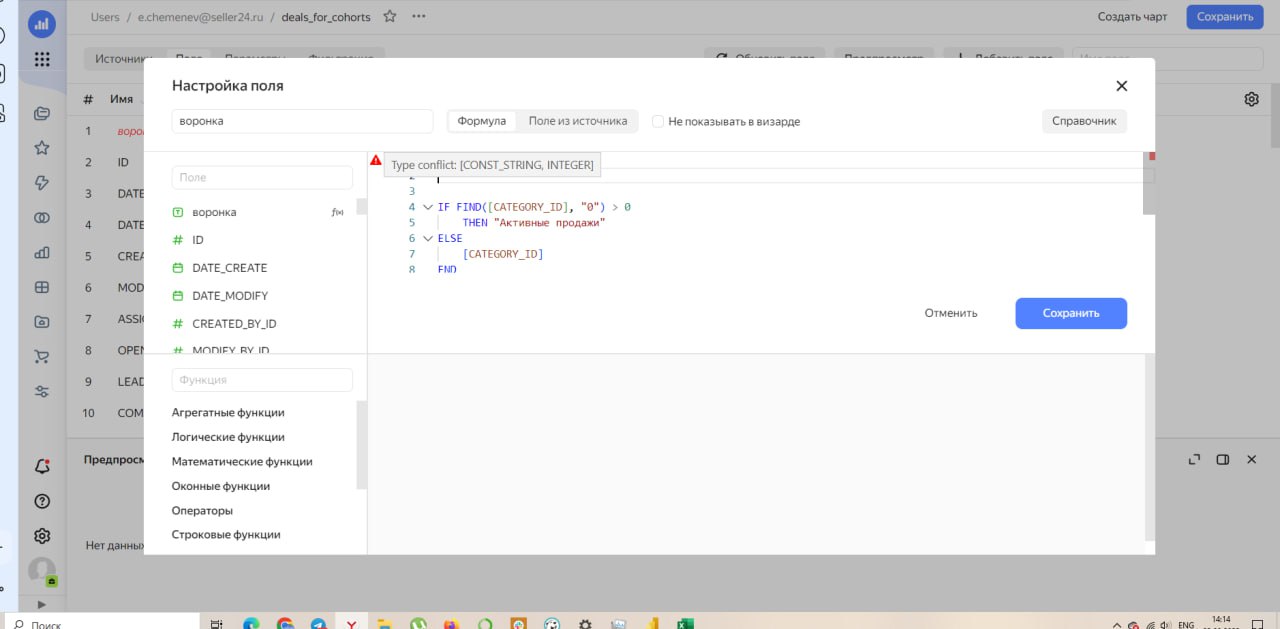
Подскажите пожалуйста, хотел полем с данной формулой:
IF([updateat_dt_tm]>=(NOW()-10),([updateat_dt_tm]), NULL)
выводить показатель за последние 10 дней. Поле работает, но проблема в том, что вместе с датами прокидывается и сам NULL. Есть ли возможность избавиться от пустого значения?
можете перенести условие в фильтр
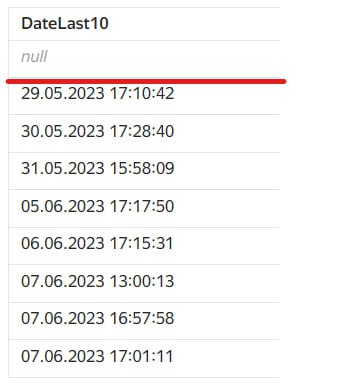
Привет, как отсортировать значения в селекторе? Условно у меня в селекторе отображаются названия, и они отображаются от самого раннего к самому позднему, как изменить порядок? чтобы было наоборот
Селекторы автоматически сортируются по возрастанию/алфавиту , порядок можно изменить только если поставить цифры в названии
подскажите в чем проблема?
COUNT_IF(([Возраст на момент госпитализации в стационар])>0 AND ([Социальный статус]!="БОМЖ" or [Гражданство]!='РОССИЯ') )
Необходимо посчитать количество людей которые старше 0,
У которых соц статус не бомж
и у кого гражданство не РФ
Все эти люди в дальнейшем будут исключаться.
Надо исключать если соответствует хоть одному критерию.
Вместо and прописывал or, ничего не меняется. показывает общее число строк. была ошибка, нашел. сделал в таком виде
count([Номер КВС])-COUNT_IF(([Возраст на момент госпитализации в стационар])<1) - COUNT_IF([Социальный статус]="БОМЖ")- COUNT_IF([Гражданство]!='РОССИЯ')
есть ли такая возможность выводить данные за прошлый год по выбранному интервалу дат, например, не только по целому месяцу, но чтобы можно было выбрать 1-15 июня и увидеть данные за 1-15 июня прошлого года?
Выводить данные за прошлый год по целым месяца получилось вот такой формулой: AGO(SUM([Сумма продажи]), DATETRUNC([День продажи], "month"), "year", 1 BEFORE FILTER BY [День продажи])
А вот с указанием минимальной и максимальной даты как-то не получается
У AGO только стандартные временные диапазоны - месяц, год и т.п. Макс и мин даты задавать - это через параметры можно реализовать.
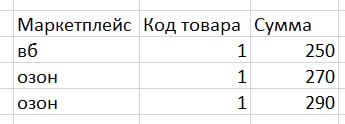
Помогите, пожалуйста, написать формулу, никак не получается..
У меня есть данные (на картинке) и мне нужно формулой выбрать минимальную сумму только среди озона, то есть первую строку вб не учитывать. В конечном итоге получить
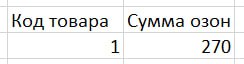
Можно что-нибудь типа min(if маркетплейс=озон then сумма else... ) и после else либо null поставить (не знаю, как он там с нуллом отработает, но попробовать можно), либо число впишите большое и в расчёт минимума оно точно не попадет
У меня есть Clickhouse в яндекс облаке, туда накрутил пару собственных функций (UDF) с бизнес логикой
Можно ли как-то их как-то напрямую использовать из DataLens?
Нет
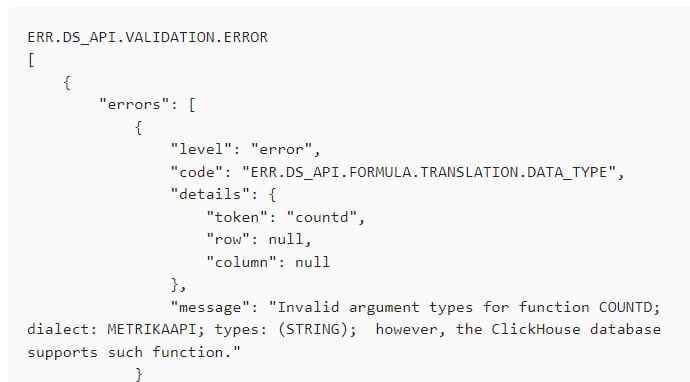
Выгрузила данные в ДЛ из Метрики. Подскажите, при такой связке к параметрам/показателям реально вообще применять функции ? Мне выдает ошибку, например, хочу вывести кол-во уникальных транзакций,вот такая ошибка (см.скрин) . Может кто сталкивался . Судя по ошибке нужно через ClickHouse пробовать
Там куча ограничений, связанных с API - поэтому вот далеко не всё возможно.
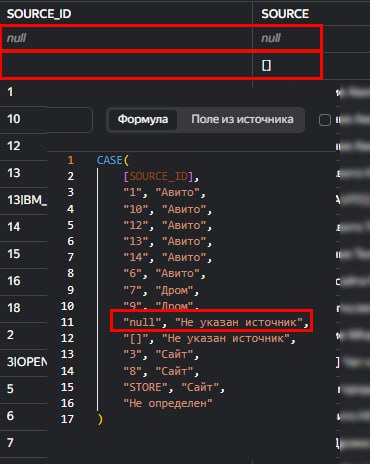
Хочу все источники объединить в категории.
Источники идентифицируются по Source_ID.
Решил это реализовать через CASE.
И есть записи, где источник не проставлен и Source_ID пустой. Соответственно DT там указывает Null.
Подскажите, пожалуйста, как в формуле указать что пустой Source_ID относить к "Не указан источник"? Пробовал указать "", "null" - DT всё ровно считает этот источник не известным и относит к "Не определён".
Потому что Null - это не строка Для проверки на это есть isnull или ifnull
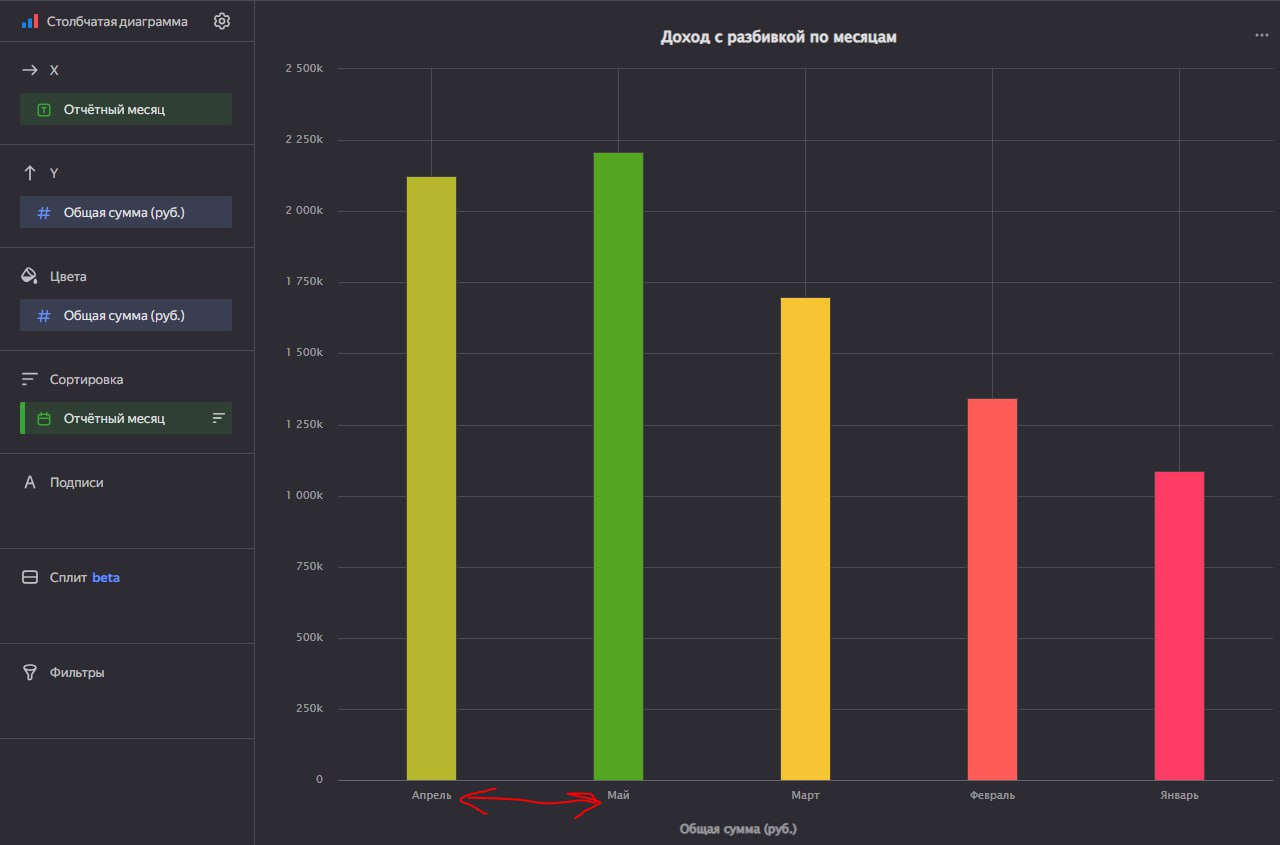
как в датасете сделать сортировку по месяцам, а не по алфавиту. Спасибо.
Правильный способ - на ось класть дату, а не строку
Второй способ - создать поле с нумерацией месяца и добавить в сортировку
Третий - пронумеровать - 01 Январь, 02 Февраль и т.д.
в datalens есть функция обратная функции ALL_CONCAT, чтобы значения из строки с перечислением через запятую преобразовать в отдельные строки?
SPLIT
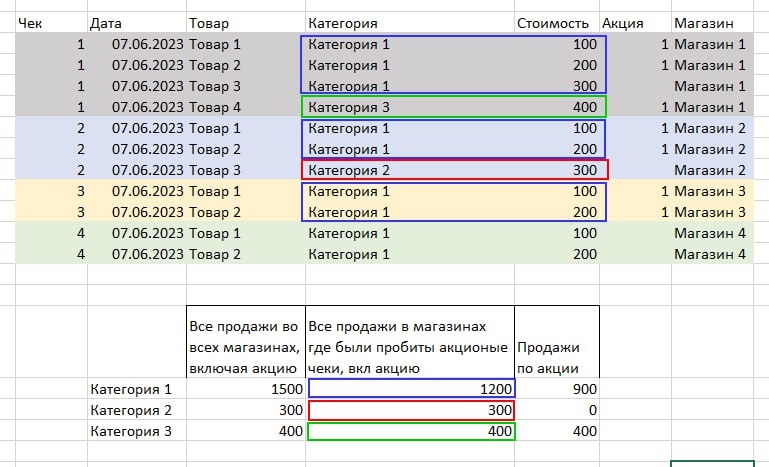
данные - чеки. одна строка в датасете - товар в чеке с датой, категорией, стоимостью, магазином и текстовым значением номера акции (пуст или заполнен акцией). один чек - несколько строк (скрин)
фильтр - номер акции.
подскажите, как можно посчитать такое значение - сумму товаров в разрезе категории, только по тем магазинам, где была акция ?
Сумма с условием, что акция = 1 и с группировкой по категориям. Ну в принципе, также, как и в таблице гугловской, если это делать не костылями, а сводной таблицей.
у меня такой вопрос: я работаю с датасетом, в котором ексель таблица, у меня есть столбец "сумма", мне необходимо посчитать процент сумм со значением от 1 до 5000, от общего количества сумм, подскажите, пожалуйста, как это сделать.
SUM_IF
Работаю с Яндекс Метрикой через Дата Ленс и возник вопрос: Как вырезать параметры ссылок в датасете? Все, что в ссылке идет после симовала "?", включая его самого?
Здесь может помочь substr или substring (не помню как точно называется)
Подскажите пожалуйста, как правильно составить формулу count_if, если нужно подсчитать количество значений, которые равны или содержат слово Текст?
countif([Значение] like "%текст%" or [Значение] like "%Текст%")
Формула чувствительна к регистру
Подскажите формулу как вытащить из даты первый день недели. Номер недели вижу, а именно дату понедельника. Наверное есть уже формула, спасибо!
Округлите до недели и возьмите день.
Что то не получается у меня. Не пойму как это должно выглядеть. Создаю вычисляемый столбец в датасете . Помогите найти ошибку пожалуйста
isnull() Isnull(2) and isnull(3) Ну и end в самом конце

Нужен ваш совет/подсказ
Ситуация такая: формула выдает ошибку по типу данных, хотя тип данных соответсвует заявленному в документации
Подключение напрямую из Appmetrica
Подскажите, в чем может быть проблема?
Формула:
SUM_IF([Количество событий],[Параметры событий: уровень 2] = "stories") Ошибка не про тип данных говорит, а что эта функция работает для других источников, но не для метрики
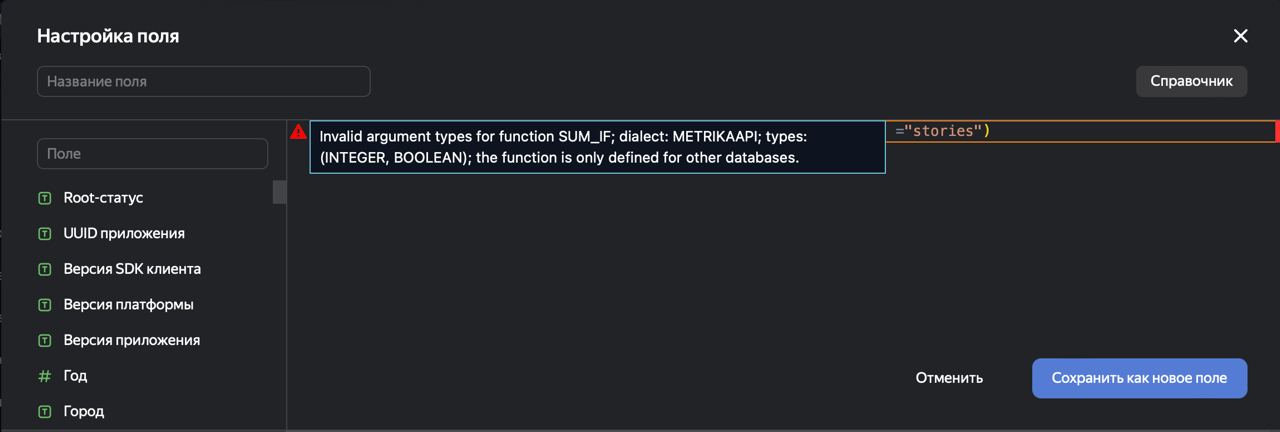
Рис 174_1
Рис 174_2
Выгружаю в даталенс таблицу с рекламными кампаниями. В Датасете у меня среди измерений следующие показатели: возраст, пол, компания. Мне надо сделать срез по одной компании. Как её вычленить в Даталенс?
Кинуть эту компанию в чарте в фильтр, либо в дашборде в селектор
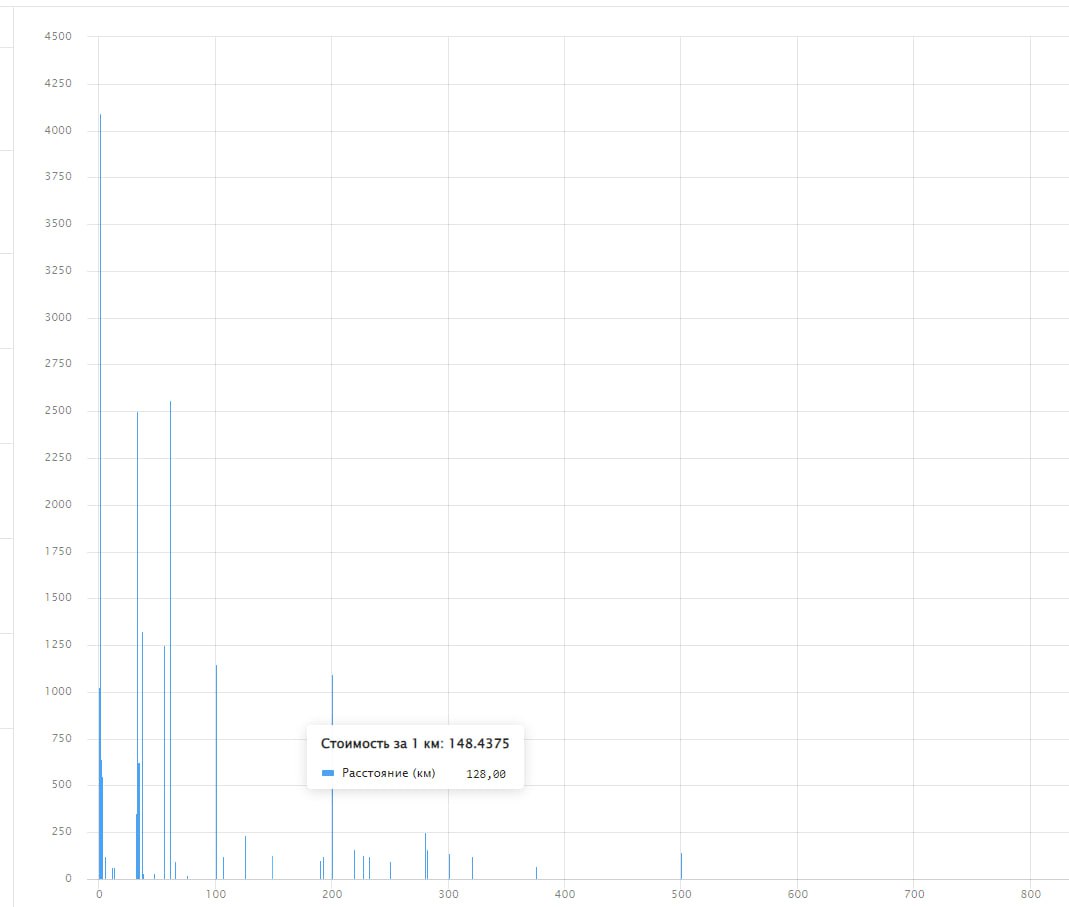
Подскажите, как оси Х сгруппировать результаты по диапазонам, например 0-50, 50-150, 150-300, 300+ ?
Заводите под это отдельное поле, прописав там разделение по категориям вручную
Есть ли регистронезависимый аналог функции CASE, чтобы не использовать IF и кучу ICONTAINS?
Можно все просто приводить к одному регистру
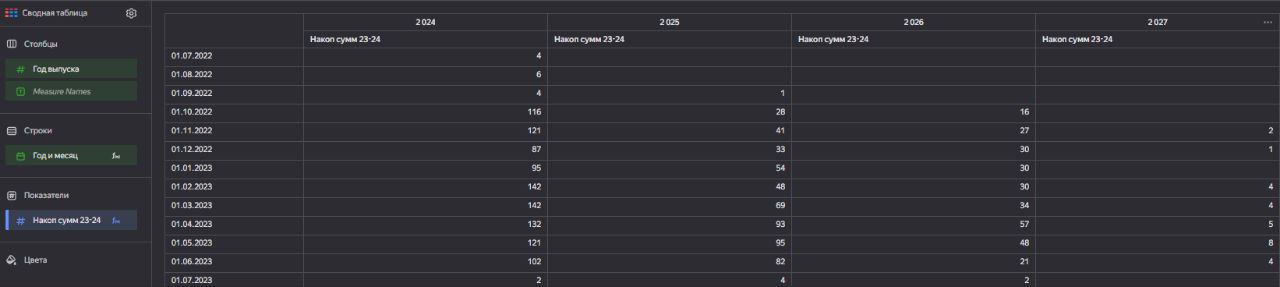
Хочу вывести накопительное количество клиентов по годам выпуска и первой дате месяца
Есть формула, которая считает количество клиентов
[Кл 23-24]
COUNTD([accountid_23_24])
И эту формулу я хочу накопить rsum(sum([Кл 23-24]) within [year_opp],[Год и месяц])
Но почему-то не выводится накопительно. Подскажите где ошибка, пожалуйста
попробуйте не вкладывать sum в rsum
Как сделать так чтобы даты выводились в формате date (только год месяц день), подаются в формате datetime
Через datetrunc выводит так
Нужно прописать order by и поместить туда год и месяц
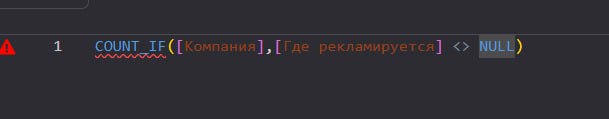
Может кто подскажет, почему Unknown 2-argument function or operator COUNT_IF. Второе поле есть, надо, чтобы не агрегировал пустые ячейки.
У count_if один аргумент, а не два. И нельзя сравнивать с нуллом, для этого есть isnull()
Подскажите пожалуйста как в итоговых значениях подставить разницу между показателями. Строка нужна итоговая с разницей показателей мая и июня Что в столбце, то и в итогах, они автоматически формируются. Так что именно в таком виде разницу реализовать не удастся

хочу сделать вычисляемое поле, оно берется из яндекс метрики, но при попытке обрезать строку, выдает ошибку
Эта функция просто не поддерживается метрикой
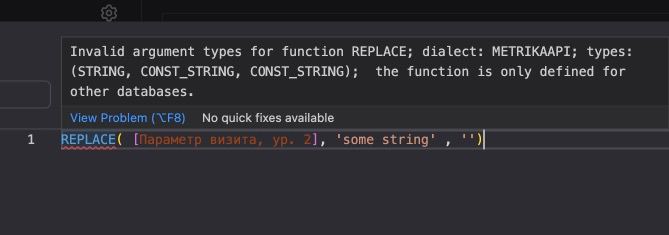
подскажите пожалуйста можно ли в data lens вычислениями перевести значение чч:мм (тип строка) в минуты?
Да, можно. Выберите подстроки, преобразуйте в числа, умножайте на что надо
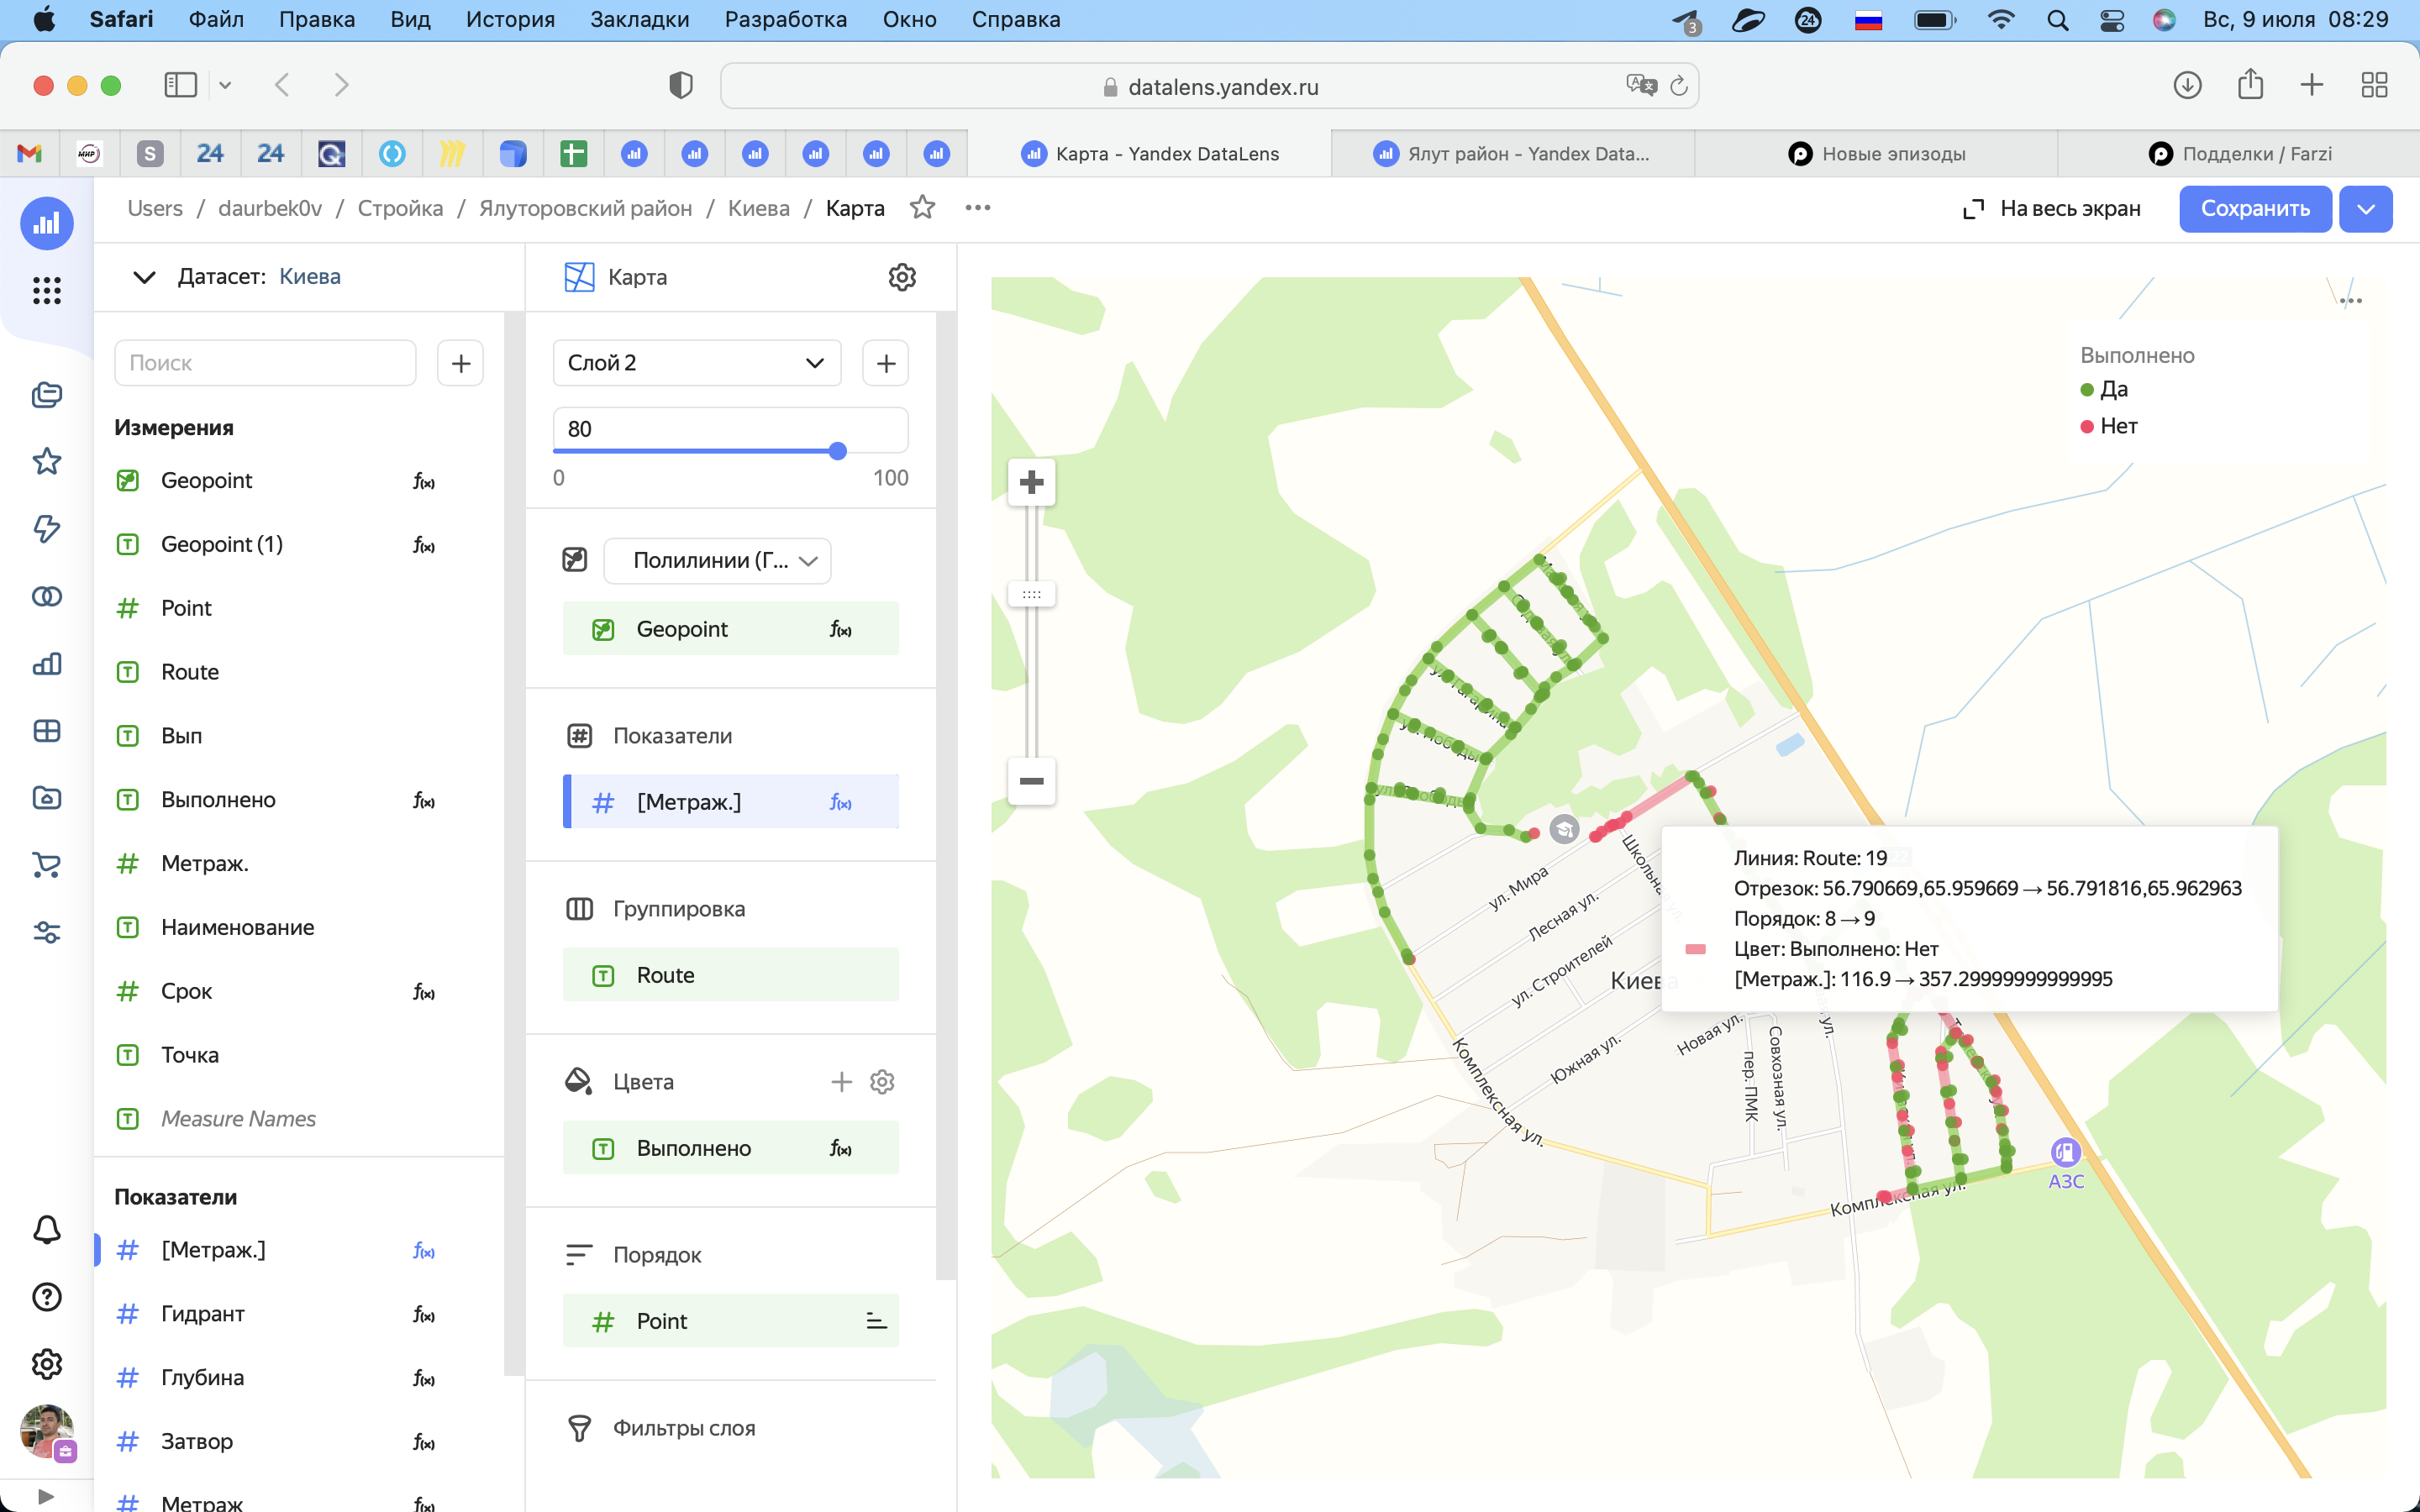
подскажите пож-та, возможно ли сделать чтобы показатель "метраж" в посказке был в виде одного значения а не двух? хочу чтоб было расстояние между точками, а не значение точек. логично же что подсказка по отрезку должна содержать значение длины отрезка, а не значения его начала и конца
Пока такой возможности нет
Сделал подключение с Яндекс Метрикой. Хочу добавить поле - количество достижений цели.
Видел параметр [Достигнутая цель] = [‘Название цели’], но не могу понять что добавить в формулу, чтобы не было ошибок и я смог добавлять это поле на ось
При прямом подключении к метрике есть показатель «Достижение любой цели». Можно либо фильтрами по «Достигнутая цель», либо использовав «Достигнутая цель» в блоке цвета. Но прямое подключение к метрике имеет множество ограничений связанных с API. Рекомендуем выгружать сырые данные в базу данных.
Здравствуйте, подскажите как посчитать сумму всех уникальных значений в столбце?
расчет суммы только уникальных значений классически одним запросом не решается
это либо сначала дистинкт во вложенном запросе, а затем сумма, либо сортировка с лимитом.
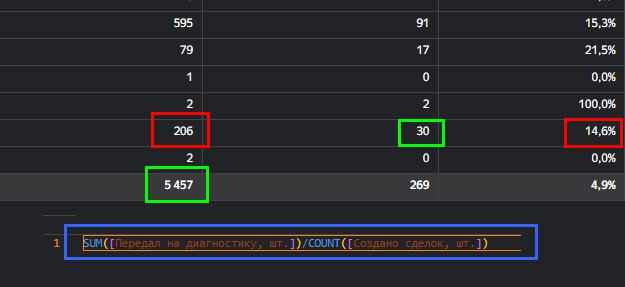
Хочу посчитать конверсию по Сотруднику не от созданных им за период сделок, а от всего созданных сделок.
На примере-скрине: хочу не 30/206, а 30/5457.
Формулу которую на скрине показал использую сейчас, но считается конверсия именно от созданных сотрудником. А как взять от Итого что-то не могу додуматься.
SUM([Передал на диагностику, шт.])/ sum(COUNT([Создано сделок, шт.]) TOTAL)
приходилось кому-нибудь текстовое поле чистить от """? Встало вместо кавычек при выгрузке
replace
Есть таблица с продажами по неделям (неделя 1,2,3...) по магазинам, нужно вывести флаг: если неделя= текущая неделя (максимальная из таблицы) или текущая неделя -1,-2,-3,-4,-5,-6,-7, то флаг = 1, иначе 0. То есть если текущая неделя 29, то у 29,28,27,26,25,24,23,22 флаг будет 1, иначе 0. Какую формулу использовать?
формула IF MAX(AVG([неделя]) TOTAL) - [неделя] >7 THEN 0 ELSE 1 END
есть ли способ получить разницу между текущем полем в таблице и следующим?
Имеет место быть следующее:
[time1] | true
[time2] | false
Соответственны я фильтрую все строки, где вторая колонка = true и хочу вывести в эту строку вычисляемый параметр [time1] минус [time2]
функция ANY
Подскажите пожалуйста, не могу понять, могу ли я сделать два подключения, из них сделать два датасета, соединить их, и использовать все поля вместе, а не переключаться между двумя
Мне это нужно чтобы сделать вычисляемое поле и столбцов, которые в разных датасетах
Вот я могу в одном датасете все его поля использовать и в другом, переключаясь между ними, но не могу написать одну формулу где два источника буду использовать
Нет, совместить разные подключения вместе не удастся для этого
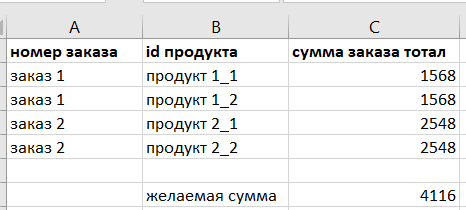
Строки разбиты по продуктам заказа, в значении повторяется тотал сумма заказа. Хочу на выходе получить без дублей сумма заказа 1 + сумма заказа 2. На SQL я бы сделал группировку(mean) и посчитал сумму уже сгруппированного. Не могу понять как синтаксисом datalens сделать
sum(AVG([ecommerce_purchase_revenue] FIXED [ecommerce_transaction_id]))
А как-то можно задать несколько условий в sum_if?
Да. AND и OR
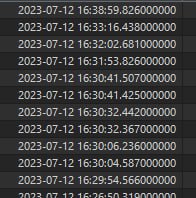
есть ли встроенные возможности у ДЛ для хранения даты и времени с точностью до милисекунд?
Нет. Но вы можете использовать таймстемпы и строки.
Подскажите, пожалуйста: есть несколько полей - "дата", "сумма", "время", "количество", делаю вычисляемое поле "время делить на количество" чтобы выявить среднее время, далее пытаюсь вычислить это время для разных сегментов по сумме через IF, выглядит это так: IF [сумма]<=5000000 then [время делить на количество] END. Результатов это никаких не выдает на графике, при этом в предпросмотре данные в это поле подгружаются, если в графике просто вставить поле [время делить на количество] тоже выдает результат, но именно через IF не работает. В чем может быть дело? P.s. - если поле "сумма" вставить в фильтр, то выдает корректный результат.
Язык запросов является непроцедурным. Могут быть только вложенные и связанные выборки, то есть уровни детализации и окна
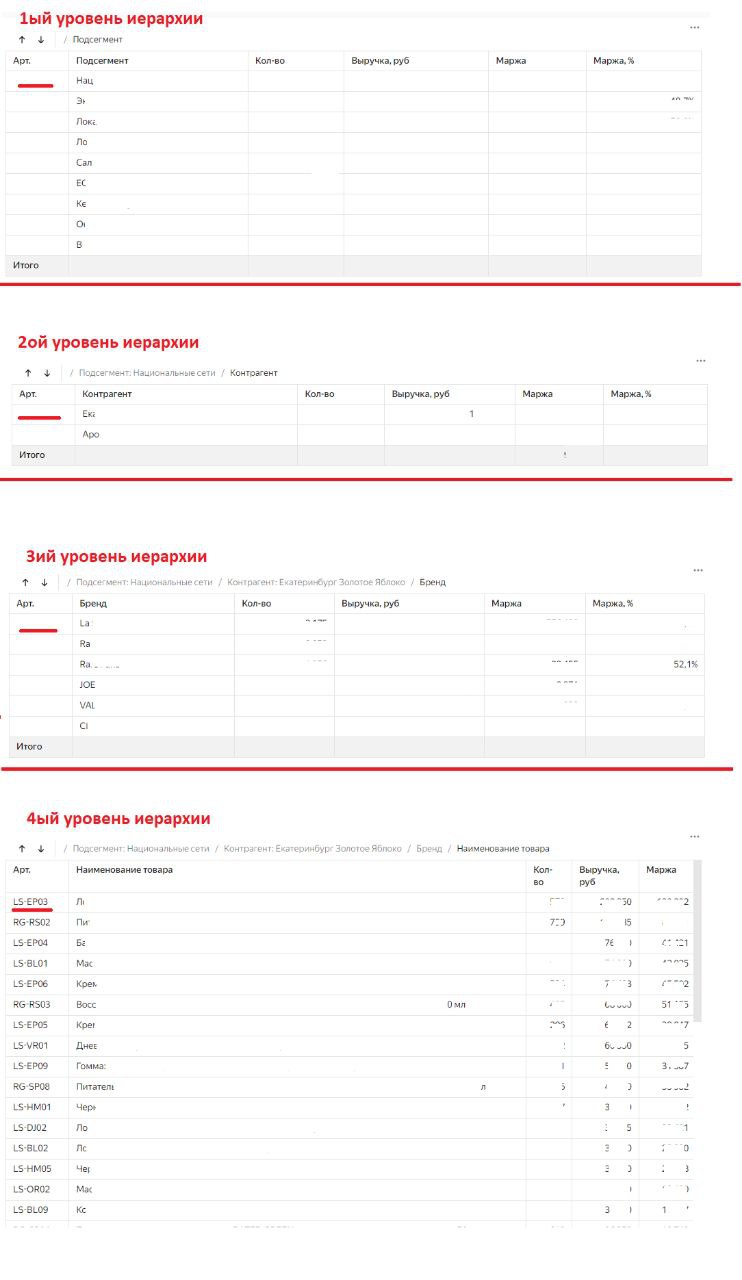
У нас такая проблема: при попытке добавить поле с текстовым значением (которое должно появляться только на 4 уровне иерархии) в таблицу, где присутствует иерархия, возникает ошибка, либо рушится иерархия.
Таблица выглядит следующим образом по столбцам:
1) Артикул (строка);
2) Иерархия (строка);
----1 ур. Канал продаж (строка);
----2 ур. Контрагент (строка);
----3 ур. Бренд (строка);
----4 ур. Наименование товара (строка);
3) Кол-во проданного товара (целое число);
4) Выручка (целое число);
5) Маржа (целое число);
6) Маржа, % (дробное число);
(тип чарта- таблица)
Ранее мы тестировали такой вариант кода для артикула в DL и все сработало (тогда подгружали данные из csv файла, сейчас через Managed Service for PostgreSQL):
if COUNTD([Артикул])>1
then ""
else ANY([Артикул])
END
По задумке артикул товара, должен появляться только на 4 уровне иерархии(но бывают исключения).
Во вложении высылаю фото с примером таблицы, где данное решение сработало.
Сейчас же, применяя данный код, выходит такая ошибка:
{
"uo9h3dv4yd3qj_result": {
"code": "ERR.DS_API.FORMULA.VALIDATION.AGG.INCONSISTENT",
"message": "Inconsistent aggregation among operands",
"details": {}
}
Полагаю, что функция "any" не работает в Postgres.
Скажите, пожалуйста, есть ли в Postgres аналог данной функции?
Или есть ли другие варианты решения такой задачи?
if [all_articles]<>[max_articles]
Then ""
Else [max_articles]
End
Где:
[all_articles] = ALL_CONCAT([Артикул])
[max_articles]=MAX([Артикул])
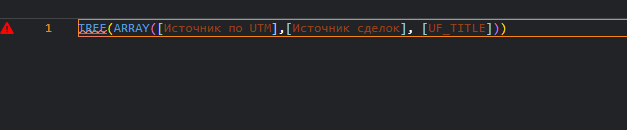
Подскажите пожалуйста, что не так с формулой, пытаюсь сделать дерево для таблицы
Ваш источник не поддерживает деревья, можно сделать иерархией
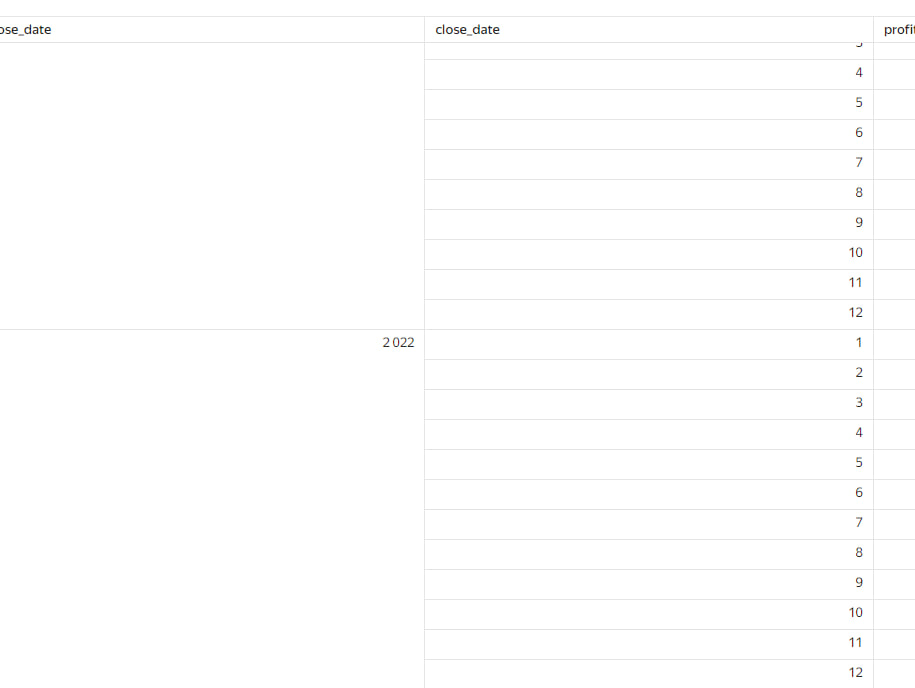
подскажите, без sql запроса могу ли я заменить цифры на наименования месяца ?
Вполне, через создание нового поля и IF или CASE
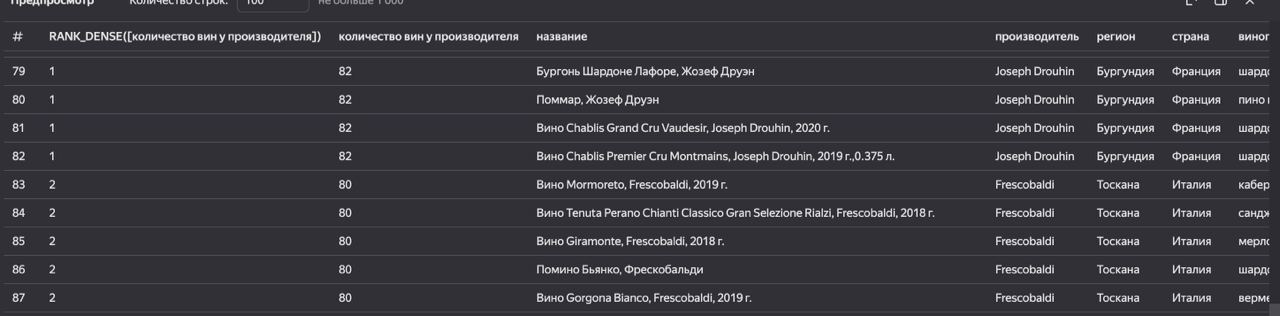
в предросмотре полей идут верные значения rank, а в таблице одни единицы, как это работает
Предпросмотр показывает вам построчную выборку, а таблица с группировкой

можно ли значения выбранные в фильтрах пробрасывать как переменную в вычисляемое поле?
Можно, через параметры. Заводите параметр, к нему селектор ручной и чарт будет меняться по вычисляемому полю в зависимости от выбранного параметра https://datalens.yandex/9fms9uae7ip02?tab=Zyd
нет ли в даталенсе функции чтобы пропуски в данных заполнить? Например, средним между двумя точками разрыва? (речь идет о пропусках во временных данных)
на графике можно в настройках оси.
Может быть, кто-нибудь подскажет, можно ли в DL для ALL_CONCAT как-то гарантировать ORDER BY? В доке не нашел про это. А то печально, если после склейки для одинаковых наборов входных значений могут получаться разные выходные. Судя по инспектору, дефолтный ORDER BY по возрастанию всех параметров там отсутствует, а в источнике, насколько я знаю, в агрегатных функциях такой дефолтный порядок тоже не гарантирован (источник postgres).
Там в теории можно подшаманить, просто добавив сортировку рядов, тогда агрегатная функция возьмет ряды в нужном порядке и должно получиться все ок, но хотелось бы менее грязное решение с явной сортировкой внутри агрегатной функции, а не на входе в общий SELECT, может быть, кто-то сможет подсказать.
В реляционной модели порядок строк не имеет значения. Это значит, что если не выполняется явно заданная сортировка, то как СУБД будет выбирать данные в таком порядке и отдаст. На практике - это порядок хранения или порядок, зависящий от используемых при выборке индексов…
Подскажите, пжл, у меня есть два датасета, я делаю union all для них чтобы получить 1 датасет. В нем мне надо рассчитать метрики для для каждого из датасетов по отдельности и у меня есть поле data_name, которое разделяет 1 датасет от другого.
и у меня есть следующая формула - я могу где-то указать, что все эти расчеты должны проводиться по полю data_name = 1?
Можно дописать условие and data_name = 1
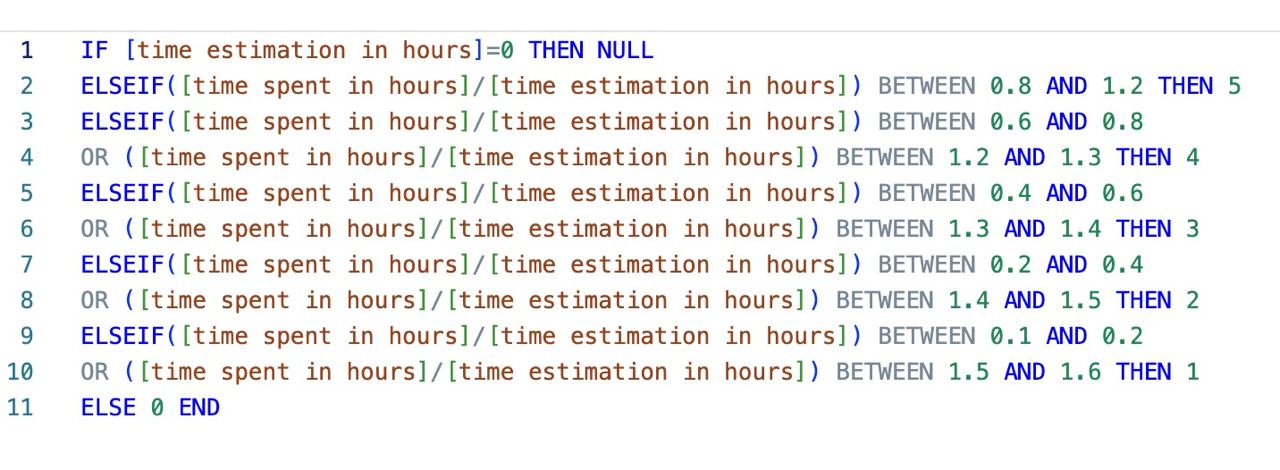
Пытаюсь сделать поле, которое бы = TRUE если в нём было бы одно из значений [user_uf_department] = '[107]' OR '[108]'
но больше одного значения поле не хочет брать. Есть варианты?
[user_uf_department] in ('[107]', '[108]')
Подскажите, считаю кол-во заполненных полей, но при указании нескольких условий получаю значение NULL. Я могу казать, что при NULL мы в ячейке пишем "0"? Если да, то помогите на примере этого поля сделать, пожалуйста. sum([sum])
Вообще, если хотите избавиться от Null, то вам в помощь if [Формула] is null then 0 else [Формула] end
Или ifnull([Формула], 0)
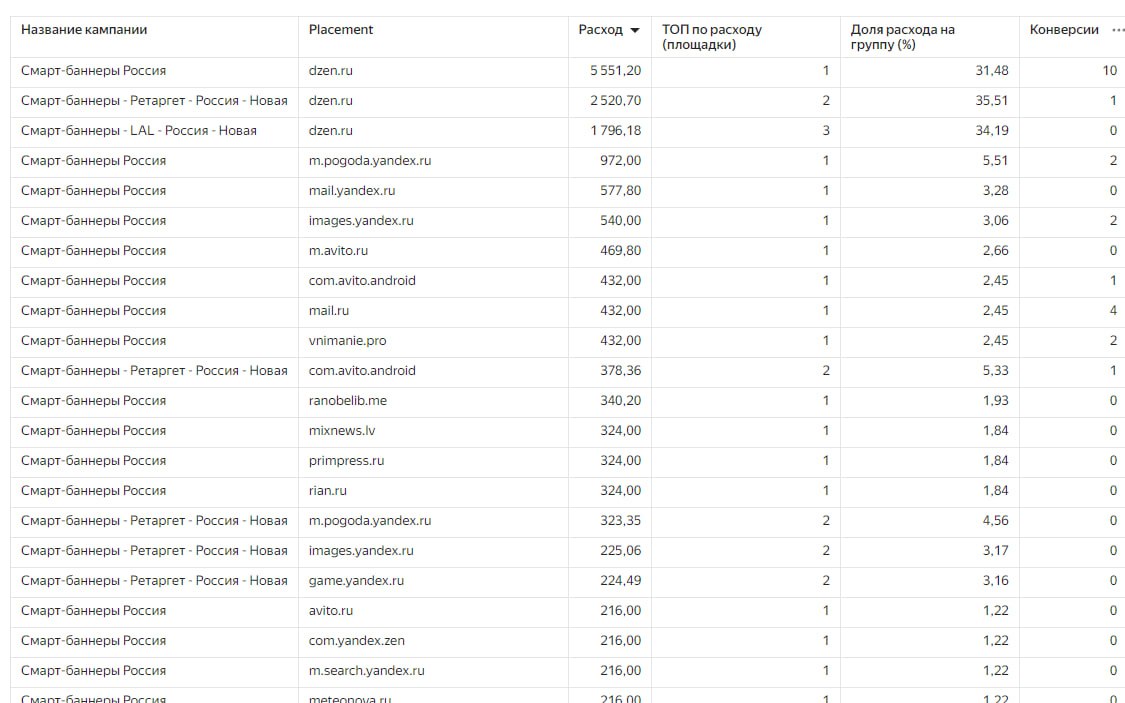
Не могу сообразить как сделать ранжирование внутри кампаний по площадкам, чтобы для каждой кампании каждой площадке назначал ранг по расходу.
Сейчас использую функцию как на скриншоте. Она выводит для каждой площадки 1,2,3 в зависимости от позиции кампании по расходу.
Если поменять в формуле аргемент на площадку, он соотвественно выводит ранжирование по площадкам суммарно, без учета группировки по кампаниям.
Как сделать поле, которое будет ранжировать по расходу площадки, учитываю группировку по кампаниям?
within попробуйте заменить на fixed или сделайте exclude [Placement]

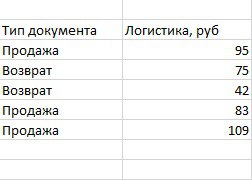
Если кто-то сталкивался, напишите пожалуйста. Подключение google heets. Необходимо создать новое поле (формула) в Датасет, какую функцию можно использовать что-бы суммировать значения по типу документа "Продажа" ? Возможно есть пример.
SUM IF
А можете помочь решить задачу....есть два датасета, по каждому выведен индикатор с агрегирующим значением...как эти два сводных значения сложить и вывести в 3-ем индикаторе, никак не выходит...пробую сделать один чарт индикатор из двух датасетов со связью, но выдает ошибку(
Данные надо объединить в одном датасете.
добрый день , подскажите что не так делаю , почему данное поле имеет null значения
Если в формуле где-то попадается null -значение, то и итог null
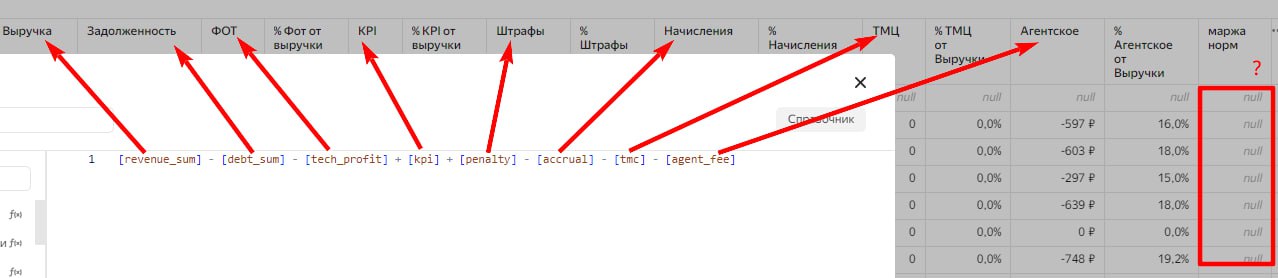
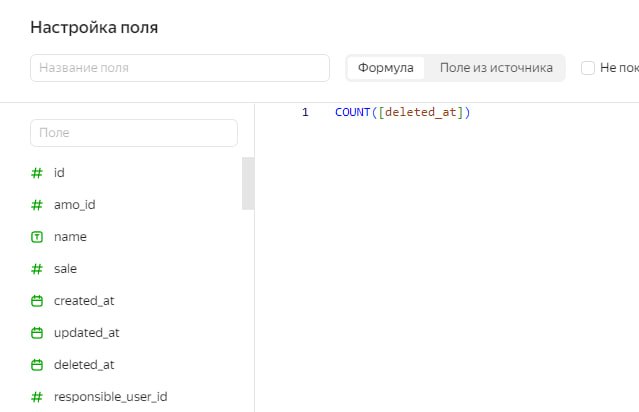
Как получить количество записей, у которых, к примеру, deleted_at == NULL, ну или либо amo_id == 123.
Через count_if в комплекте с isnull)
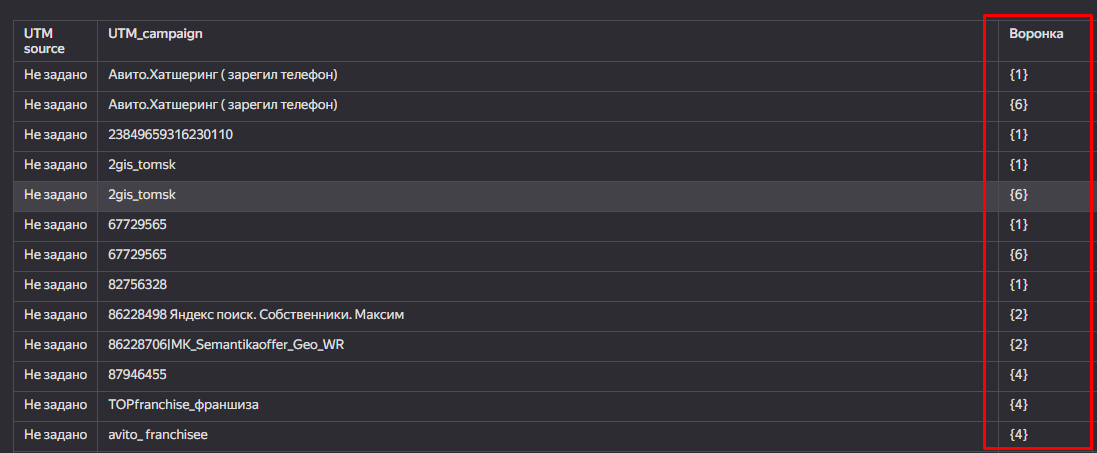
В строке содержатся данные {1}, {2} и т.д.
Как я могу сделать к ним приписки или заменить цифры на "Аренда", "Франжиза" и т.д.
Создать новое вычисляемое поле с IF и/или concat
подскажите,пож-та,как посчитать подобную формулу?
sum(case [значение] when > 0 then 1 else 0 end)
а то пишет ошибку формулы
Вместо case напишите if и уберите when
привет. какой формулой из формата даты даталенса сделать строковый формат "01.01.2023"?
Формулами, по частям вытаскивающими день месяц год, и concat
пытаюсь переименовать значение в столбце (содержатся только 0) через if
синтаксис посмотрела
тип поля числовой
IF
[category_1] = 0
THEN "Health & Household"
ELSE "0"
END
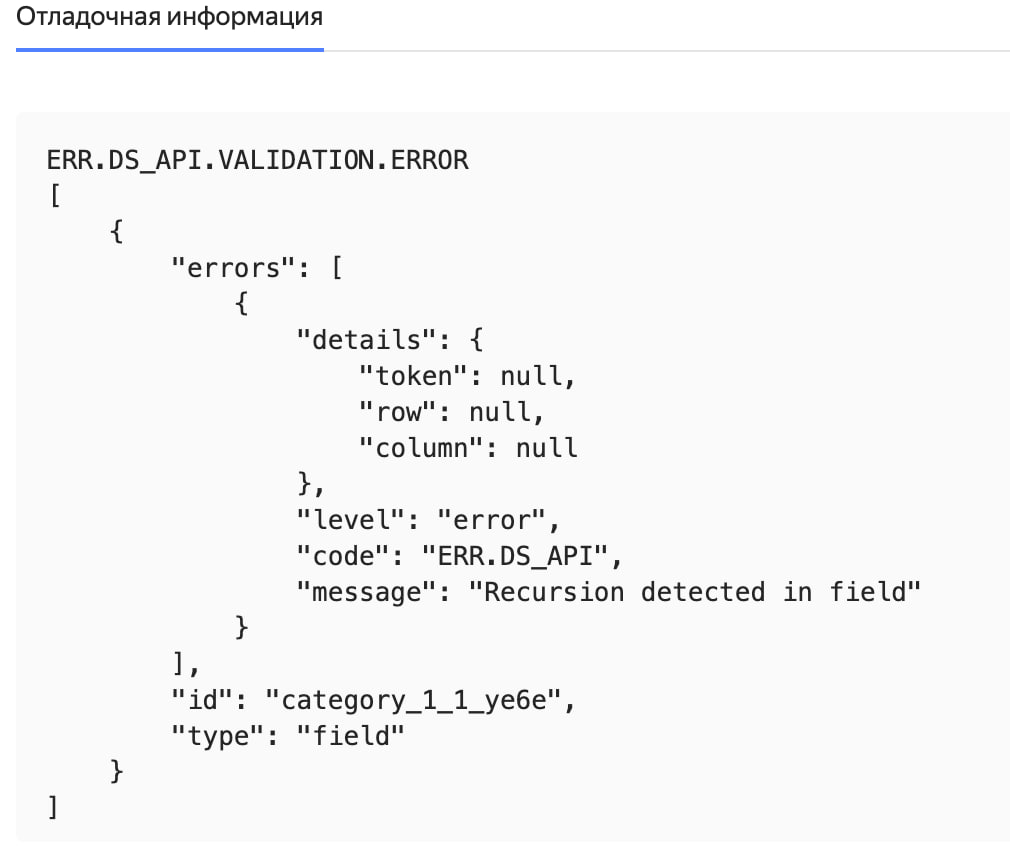
но датасет не проходит валидацию
вы, наверное, в столбец category_1 это делаете? потому что он вам сообщает о рекурсии. а надо в новом
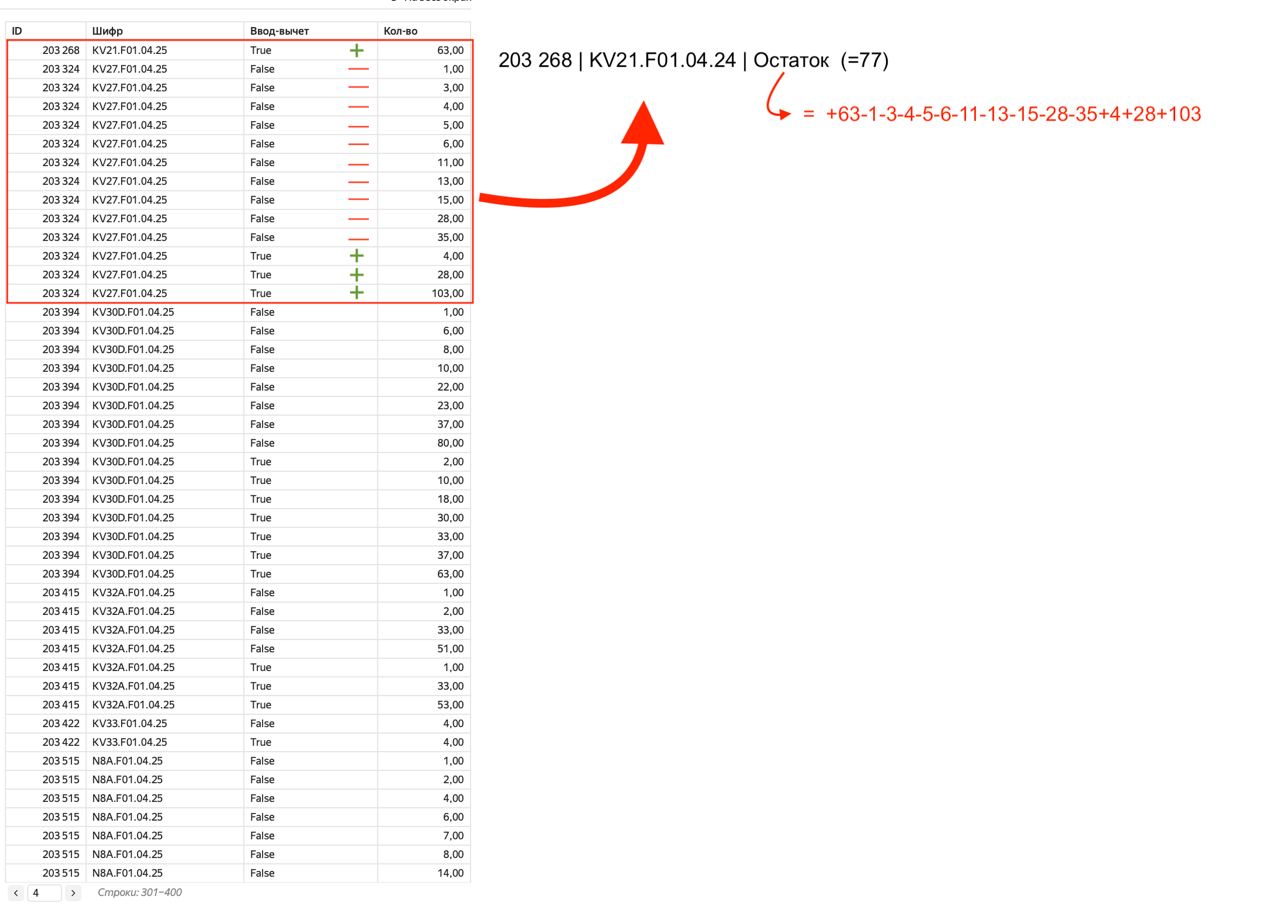
Помогите пожалуйста с формулой.
Через создание сводной таблицы я могу группировать по ID, шифру, но не могу правильно сложить столдбец «Кол-во», мне нужно получить новый стобец «остаток», при его фрмировании нужно учитывать столбец «ввод-вычет» где true это «+» а false это «—»
(на скрине столбец ID неверное значение)
через IF создаете новый столбец
А как привести enum к строкам? условно в таблице значения 1, 2, 5 - нужно что бы показывались слова, стоящие за этими значениями)
Конструкция case when then
Коллеги, а кто-нибудь пробовал данные из одного датасета разделить на данные из другого? В моём случае - это расходы Яндекс Директ нужно разделить на конверсии из Метрики (сгруппированные определённым образом). Может у кого-то аналогичный кейс завалялся?))
Нельзя что-то считать из разных датасетов
Подскажите пожалуйста, не могу сгруппировать данные. У меня есть клиенты с платежами, я хочу получить сумму тарифов (в таблице несколько клиентов с одинаковыми тарифами, на каждый платеж так расписано) и мне нужно сгруппировать сумму по id продажи, чтобы сумма считала не все суммы тарифов для одного клиента, а только суммы одной продажи (дубли группировала). Как правильно в даталенс написать запрос?
нужно сделать LOD выражение SUM([Продажи] FIXED [ID продажи]).
тогда в столбце будет группировка не по тарифам, а так, будто мы построили отчет по ID продаж
Подскажите вообще возможно показать на индикаторе рост в % к пред. году ? Ни в одном примере такого не нашел. Чтобы именно на индикаторе, не на графике или в таблице.
IF [YoY]>0
THEN CONCAT(" +", ROUND([YoY]*100,2), "%")
ELSEIF [YoY]<0
THEN CONCAT(" ", ROUND([YoY]*100,2), "%")
ELSE CONCAT(" ", ROUND([YoY]*100,2), "%")
END
Само поле YoY - это отношение показателя текущего месяца к прошлогоднему
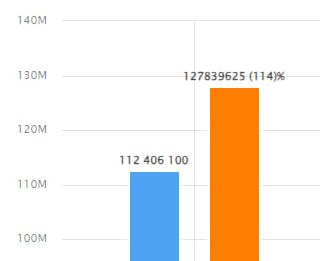
Дано число в строковом представлении. Как разбить его на разряды?
Пример входных данных: 22333444
Пример выходных данных: 22 333 444 В рамках DL, конечно. Входные данные получены, например, через REGEXP_EXTRACT
Синее — число, DL делает разбиение
Оранжевое — строка и разбиения, конечно, нет
SUBSTR(REPLACE(STR([Показатель]), ' ', ''), 1, LEN(REPLACE(STR([Показатель]), ' ', '')) % 3) +
IF(LEN(REPLACE(STR([Показатель]), ' ', '')) % 3 = 0, '', ' ') + SUBSTR(REPLACE(STR([Показатель]), ' ', ''), LEN(REPLACE(STR([Показатель]), ' ', '')) % 3 + 1, 3) +
IF(LEN(REPLACE(STR([Показатель]), ' ', '')) <= 3, '', ' ') + SUBSTR(REPLACE(STR([Показатель]), ' ', ''), LEN(REPLACE(STR([Показатель]), ' ', '')) % 3 + 4, 3) +
IF(LEN(REPLACE(STR([Показатель]), ' ', '')) <= 6, '', ' ')
есть ли пример ф-ии row_number?
Внутри DataLens такой функции нет. Вы может либо добавить её в VIEW в БД и пользоваться VIEW внутри DataLens, либо описывать датасет через SQL внутри DataLens, добавляя данное поле. Подробнее об этом описано в документации.
хочу узнать кол-во дней между столбцем [date] и сегодня
TODAY()-[date]
вот так хранятся данные в [date]
2019-03-06
Round(
(int(today())-int([date]))/86400
,0)
У меня есть таблица, в каждой строке хранится информация о статусе, объекте и объекте рекламы. Мне нужно сделать сводную таблицу, разделив её по статусам. Далее к сводной таблице нужно подключить селектор и фильтровать первые три столбца по полю объект рекламы, а четверты по полю объект. Первую часть задачи я решил, а вот с селектором проблема. Подскажите как я могу это реализовать? Хотя бы направление в котором думать
Подозреваю, что вам нужен befor filter by
Подскажите, может ли быть вот такая запись
If
Поле = 'значение' and поле3 = 'значение'
Then поле2 = 'значение'
Нельзя формулой вносить изменения в существующее уже поле
сейчас есть функция TOPONYM_TO_POLYGON?
Нет. Полигоны придется самостоятельно добавлять.
Подскажите пож-та можно как-то такой запрос написать?
То есть поставить условие, что тип маркета =1 ?
count([Уникальных заявок])/count(count([Уникальных заявок]) TOTAL BEFORE FILTER BY [Название маркета] where markettype = 1 )
Count_if
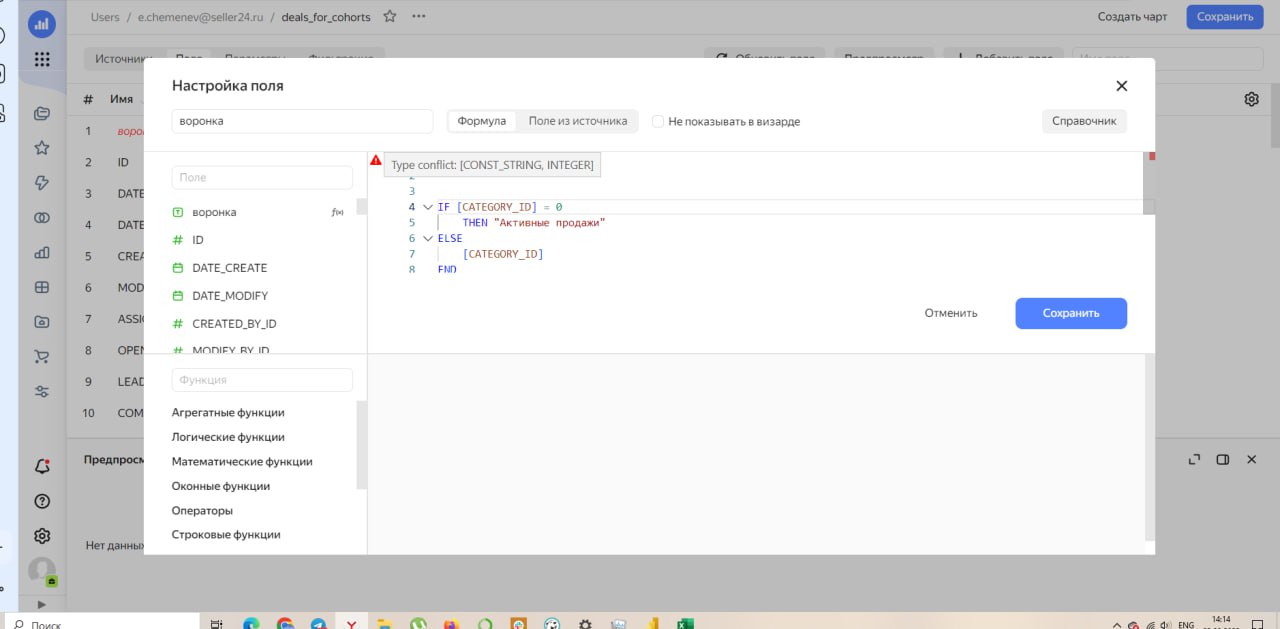
почему то условная конструкция не срабатывает
у вас IF должен всегда возвращать один и тот же тип данных, но в случае then он возвращает строку, а в случае else возвращает число
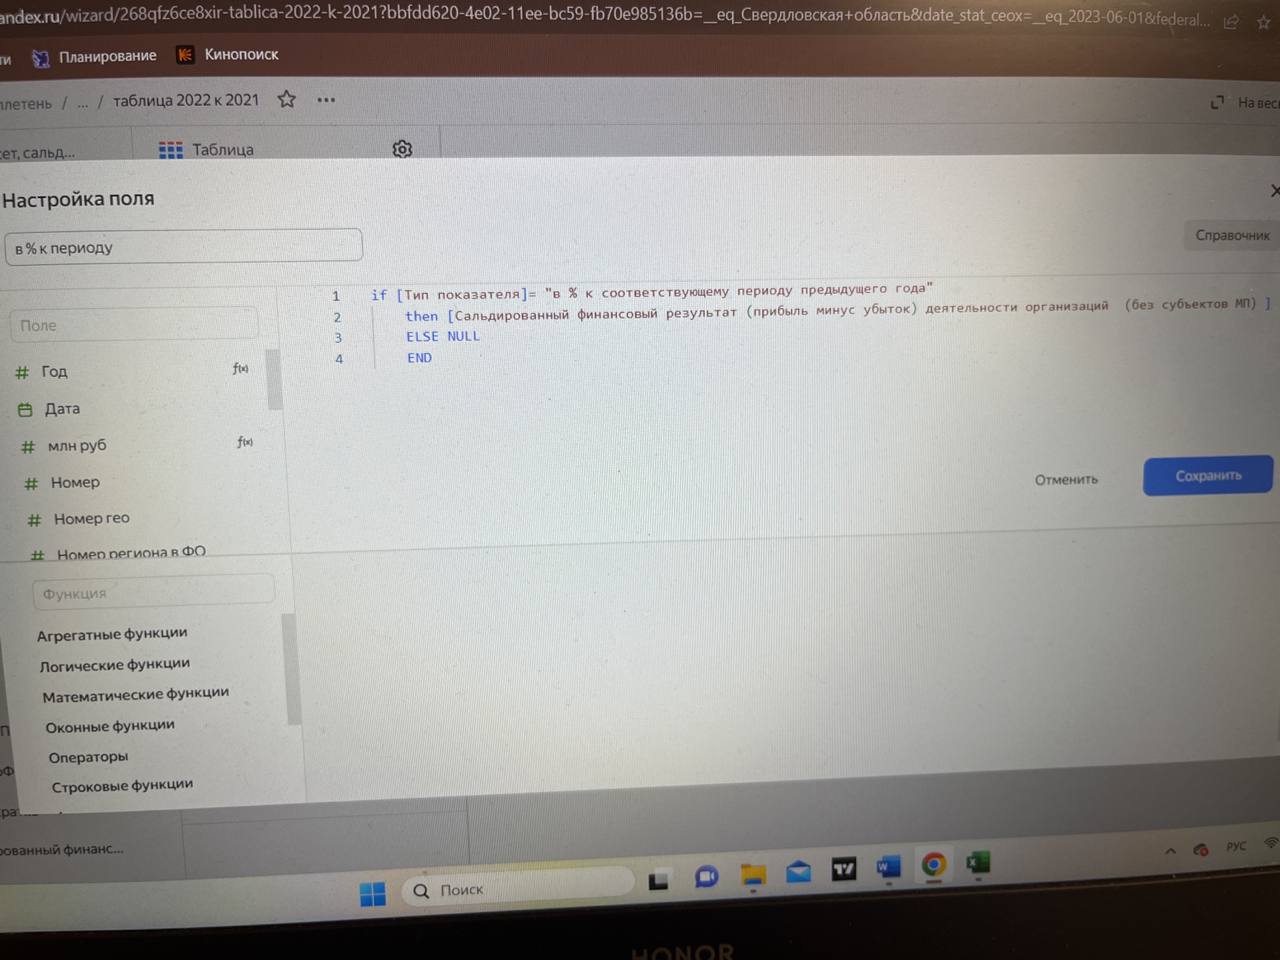
Как в AGO() функции указать не одну дату за прошедший период, а отрезок?
Или какая другая функция может это реализовать?
Хочу просуммировать продажи за 10 дней, но 15 дней назад.
выбираете диапазон для чарта селектором и функция рассчитывает такой же диапазон с заданным сдвигом в справке отдельно указано что два параметра являются константами
какой функцией можно определить моду для ряда чисел?
Пока такой возможности нет
подскажите как строку 1.10.2021 превратить в дату? Я пробовала через DATE_PARSE( value ), но почему-то столбец где строки типа dd.mm.yyyy и d.mm.yyyy на 150 короче после этого
значит такой формат не поддерживается, преобразуйте в базе или через разбиение строки и склейку
Скажите, можно ли логотип компании поместить в чарты?
На дашборде можно. В текстовый элемент вставляется https://datalens.yandex/9fms9uae7ip02?tab=7g
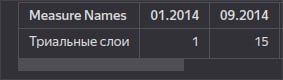
Можно ли как то получить нарастающий итог? т.е в 9.2014 должно стоять 16 (1+15)
RSUM
Подскажите, как правильно посчитать отклонения между значениями месяца?
AGO
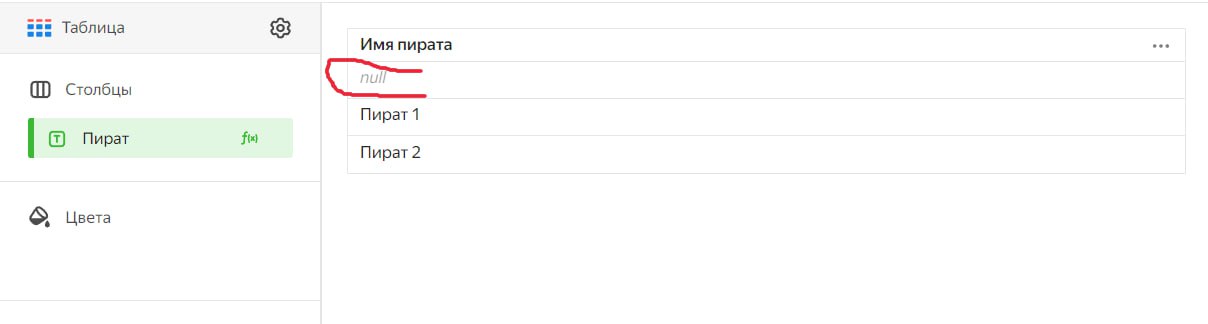
В БД есть таблица юзерам, у которых есть поле "group".
В чарте нужно показывать только юзеров, у которых "group" = "Пират"
Формула " if [group] = 'Пират' then [name] end " работает, но добавляется +1 null строка.
Из-за чего это может быть и как решить это?)
если вам нужны только определенные значения, то их отсекают фильтром или селектором
У меня есть датасет, в котором фиксируются действия action_id, которые совершают пользователи user_id
Подскажите, пожалуйста, как посчитать кол-во user_id у которых count(action_id) > 10
COUNTD_IF(ANY([platform_user_id] INCLUDE [platform_user_id]), COUNT([id] INCLUDE [platform_user_id])>9)
стоит задача посчитать среднее время выполнения проекта, казалось бы, проблем быть не должно, но как это сделать без учета выходных дней, может кто-то сталкивался с подобной проблемой?
подгрузить рабочий календарь
Подскажите, пожалуйста, как построить формулу, чтобы сначала считалось среднее значение за месяц, а потом складывались средние значения за несколько месяцев.
Sum(avg() fixed )
Здравствуйте! Вводные:
- подключена Яндекс Метрика как датасет. Таблица Метрика.Просмотры
- хочу создать поле: результатом которого будет проставление значения 1, если у поля [Адрес страницы] есть вхождение фразы simplecheckout, а если нет, то проставится Null
- пишу код: IF(CONTAINS([Адрес страницы], 'simplecheckout') = TRUE, 1, NULL), не работает. Ошибка: Failed to parse formula: unexpected token
Подскажите — какой код тут может сработать?
Задача — посчитать конверсию по посетителям из тех, кто просмотрел страницу c вхождением урла simplecheckout, в просмотр страницы с другим урлом
функция contains/if не поддерживается метрикой Метрика вообще сильно ограниченное подключение.
как получить первую дату месяца по дате в даталенс?
округляем дату до месяца)datetrunc([Date], "month")
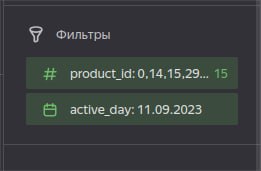
подскажите, можно ли в фильтре поставить автообновляемую дату "сегодня"? Т.е. чтобы каждый день фильтровалось по текущей дате.
вроде получилось IF [active_day] = TODAY() THEN 1 END
Можете подсказать, как считать выручку предыдущего месяца, при этом если месяц неполный, то брать часть предыдущего месяца. Когда использую в таблице AGO по 6 последним мес. - выводится 08.2023 полностью. В текущем периоде выручка за 12 дней сентября, надо август сделать в соседней колонке только за 12 дней, остальные полностью
Добавить sum_if. Еще необходимо учесть, что в прошлом месяце может быть меньше дней.
Подскажите, пожалуйста, возможно в ли в таблицу добавить столбец без привязки к датасету и проставить там значения ячеек самостоятельно?
При этом таблица должна быть привязана к датасету, то есть там будут столбцы подтягиваемые из БД и пользовательские
нет, ДЛ не хранит данные
А есть стандартные решения по отслеживанию текущих показателей продаж относительно плана?
выставляйте и записывайте план в тот же источник, откуда берёте факт.
Либо в датасете строите формулу, которая рассчитывает и выставляет план самостоятельно
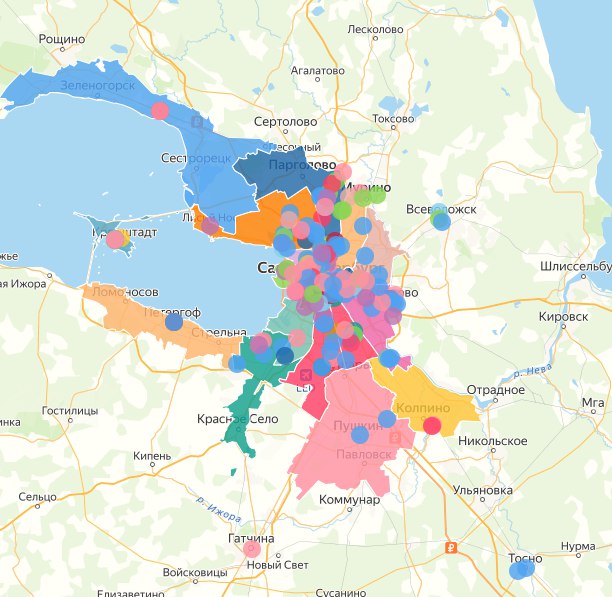
Кто-то сталкивался может уже - вопрос по картам, геополигонам и геоточкам.
Есть файл, сейчас это google sheets, в котором есть адреса клиентов и оказываемые им услуги.
Все адреса сконвертированы в геометки, все нормально отображается на картах.
Также отдельно лежит файл с геополигонами города (для Санкт-Петербурга есть файл с районами города).
На карте все отображается красиво - есть разные районы, есть сверху точки, но они никак не связаны между собой.
Как можно связать геоточки, расположенные в одном файле, с геополигонами, расположенными в другом?
Чтобы сервис понимал, что вот эти точки относятся к этому геополигону, а вот те - уже к другому.
Если это не получится реализовать в DataLens, то как это можно сделать еще?
Предполагаю, что было бы круто иметь отдельно поле, которое выдает принадлежность к геополигону (либо указывает его непосредственно) для каждого клиента
Такое нельзя в DataLens. Но можно это отдельно связать и уже связанные данные загрузить в datalens
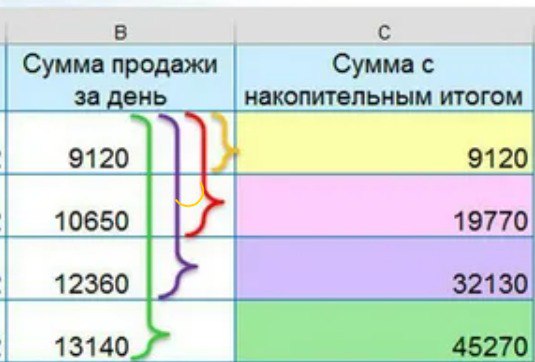
Подскажите как сделать нарастающий итог по выбранному столбцу?
RSUM
я правильно понимаю, что в Yandex Data Lens все вычисляемые поля построены на SQL, т.е. надо SQL подтянуть, чтобы писать свои фильтры и свои столбцы/строки с данными?
Смотря какой уровень вам нужен.
Но понимание основ SQL желательны на всех
Можешь ещё подсказать, как задать проверку на полноту месяца?
Через вычисляемое поле. Например if [date] < datetrunc(today()),’month’) then 1 else 0 end
У меня есть таблица с событиями, каждое из которых может увеличивать счетчик, либо уменьшать его.
Получилось сделать поле “дельта”, но мне нужен график этого счетчика.. то есть для каждого следующего события counter = counter[prev] + delta
Как мне такое можно сделать?
У каждого поля есть ID, который возрастает (не автоинкремент). Можно конечно считать этот счётчик ещё при добавлении событий, но очень не хотелось бы..
Получилось через
[initial_count] + RSUM(SUM([delta]), "asc" ORDER BY [date])
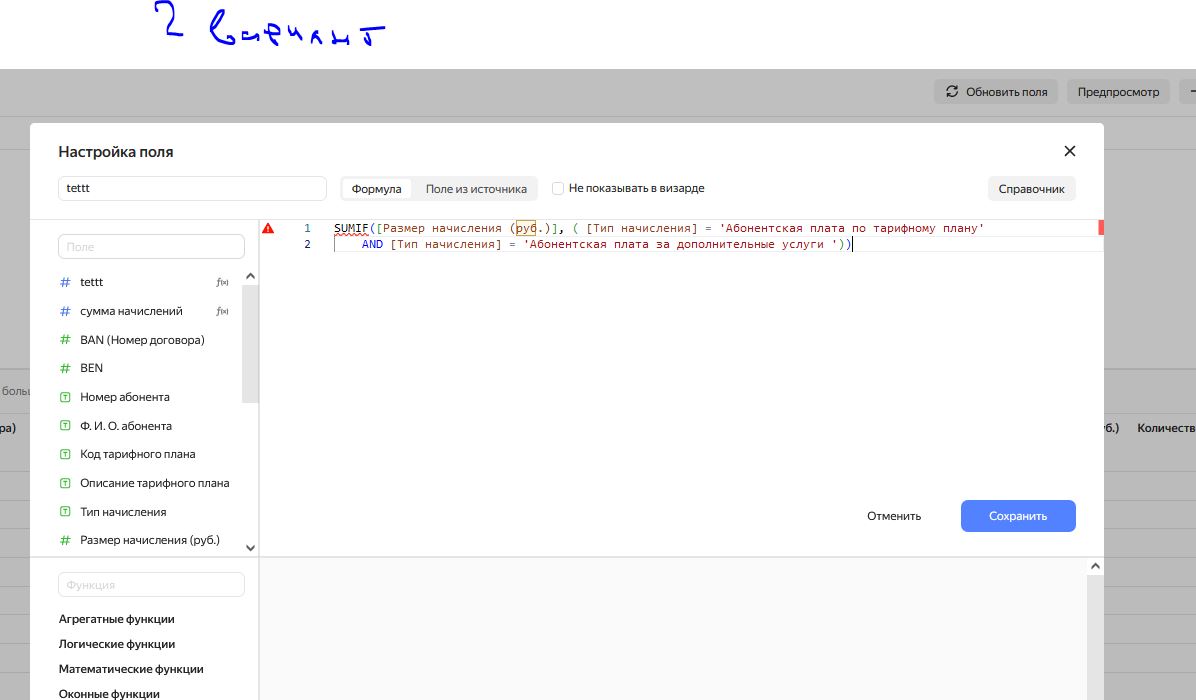
Здравствуйте, почему в варианте с COUNTD_IF всё работает, а просто COUNT_IF нет, не знаете в чём может быть проблема? COUNT_IF([student_id], [refund_type]="standard" and [refund_date]<=[lesson_date]>)
Одна функция имеет 2 аргумента, а другая 1
Здравствуйте. Пытаюсь сделать селектор для выбора показателя, который будет отображаться на диаграмме на дашборде. Ввел параметр value_type (тип строка) который будет передавать название поля из селектора в формулу. В вычисляемом поле написал такой код:
CASE (
[value_type],
"Выручка", [Общая выручка],
"Количество услуг", [Общее количество проданных услуг],
"Количество чеков", [Общее количество чеков],
"Средняя цена услуги", [Средняя цена проданной услуги],
"Средняя выручка", [Средняя выручка],
"Среднее количество услуг", [Среднее количество проданных услуг],
"Среднее количество чеков", [Среднее количество чеков],
'')
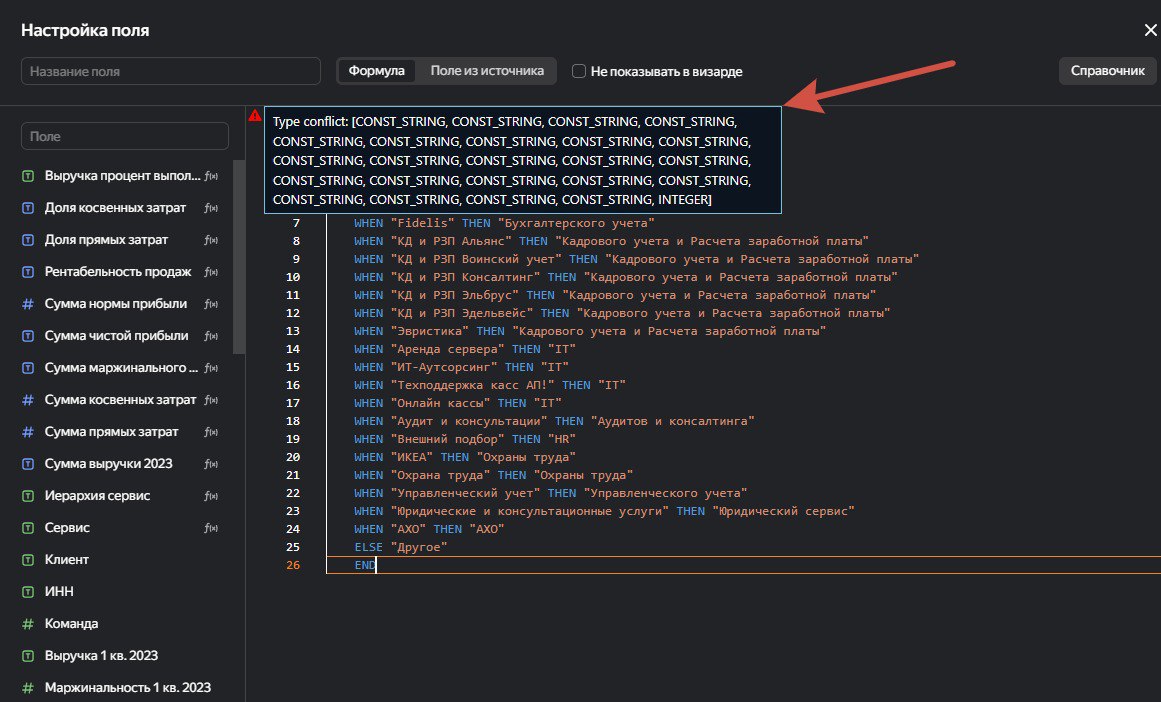
выдает ошибку Type conflict: [CONST_STRING, FLOAT, FLOAT, FLOAT, FLOAT, FLOAT, INTEGER, INTEGER]
при этом измерения получилось запихнуть в подобную конструкцию. Както можно сделать это с показателями?
В формуле по умолчанию была пустая строка (в самом конце), вместо пустой строки нужно поставить ноль...
А можно ли как-то сделать так чтобы RCOUNT учитывал только уникальные значения?
Такой возможности нет.
Реально ли в даталенсе конвертировать region id (из yt) в geopoint (получить объект региона -> вытащить координаты)? Или только подготавливать данные в ыте с координатами сразу?
geopoint просто читает строку [67.66,66.66], больше ничего
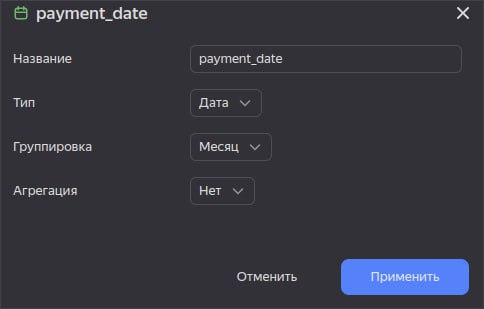
Подскажите, когда делаем группировку по месяцу даты. Это же тоже самое, что WHERE toDate(payment_date) >= '2023-08-01' AND toDate(payment_date) <= '2023-08-31'?
Нет, группировка делает DATETRUNC. Вы можете ознакомиться с итоговым SQL-запросом в Инспекторе чарта. Он доступен через «...» в правом верхнем углу.
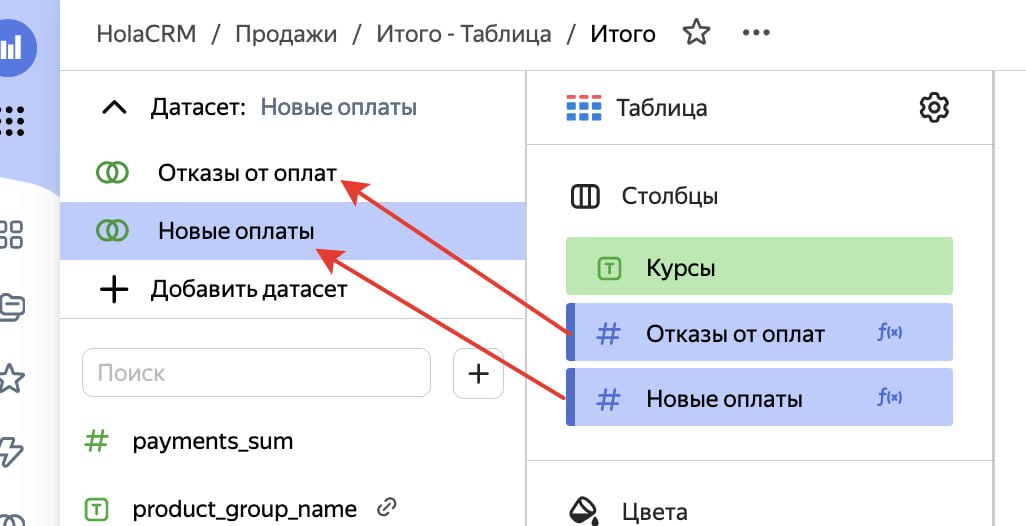
если в одной таблице используется 2 датасета, то можно Показатель из одного датасета поделить на показатель из другого?
Нет
Не могу найти фильтрацию where) мне нужно вывести показатель только тех, объектов, в своднике, где есть продажи. Ну select count(rooms) where status = "продано". и не выходит даже найти это в логических функциях
Это делается селекторами
как можно сделать поле в которое аналитик вводит данные и эти данные подставляются в формулу для вычисления? смотря что вы хотите
если просто некий параметр для расчетов, то, собственно, смотрите раздел параметров в справке и демодашборде, селекторов на основ полей редактирования
если же вам что-то сохранять, то никак
Подскажите, пожалуйста, как работают скобки:
- "2 + (2)" даталенс распознаёт "(2)" как число и возвращает 4
- "2 in (2)" даталенс распознает (2) как массив из одного элемента
Получается, что (2) это не объект и он зависит от операции, которая к нему применяется? В первом случае скобки вам вообще не нужны - обычная арифметическая операция.
Во втором случае вы используете IN, после которого чисто по синтаксису идёт массив в скобках, вот 2 и становится элементом массива
Быть может есть у кого идеи, как вывести количество дней в месяце по дате?
Ввод: 2023-09-27Т11:56:03
Вывод: 30
DAY(DATEADD([date]+месяц, "month") - день)
Есть таблица, в которой участвует показатель суммы продаж за месяц и процентное соотношение к предыдущему месяцу, хочу добавить индикатор, чтобы на него выводилась сумма за последний доступный период c определенным знаком при положительном значении процентного соотношения и с другим знаком, при отрицательном.
В таблице для отображения использую формулу IF [Процент изменения]>0 THEN CONCAT("", " ", ROUND([Сумма продаж], 2)) ELSEIF [Процент изменения]<0 THEN CONCAT("", " ", ROUND([Сумма продаж], 2)) END.
Подскажите, пожалуйста, как это возможно сделать для индикатора?
Оберните весь свой IF в ANY
Есть таблица из 3 столбцов: date_for_report, sum - сумма на дату, previous_sum = AGO(SUM([sum]), [date_for_report], 'month', 1). Подскажите, как мне вывести эти значения в суммарном виде помесячно? Чтобы каждая строка = месяц Нужно сделать обычную таблицу с настройками таблицы "Группировка = вкл."
В первый столбец указываете дату с округлением до месяца
округление делается через datetrunk()
Подскажите пожалуйста почему так нельзя, и почему он воспринимает все что в WHEN как булиан переменные а 0 как Date
Для таких штук используйте IF.
CASE для подстановки значений.
Подскажите, пожалуйста, как посчитать (count) не все значения, а только уникальные?
COUNTD([Value])
Подскажите, как можно задать более красиво:
DATETIME_PARSE(STR([EventDate]) +" "+ STR(HOUR([TimeStart])) + ":00:00")
EventDate - Date
TimeStart - DateTime
Что хочу получить, у TimeStart обрезать минуты и секунды, DATETRUNC не работает, т.к. версия КХ - 20.11.5.18
Если цель - просто обрезать для показа в табличке, то там можно ничего не делать, а просто задать вывод даты в нужном виде. Группировка тоже есть в настройках поля.
Подскажите куда копать:
Подключил гугл таблицу в столбцах продолжительность в формате 190:00:00
ДЛ воспринимает как скроку.
Как сложить два таких столбца с продолжительностью? Это в гугл надо сделать или как о формулой в ДЛ ?
разбить строку на части, части преобразовать в числа и тд можно в гугл таблице
не хочет извлекать из поля координаты почему-то, источник mysql
У этой функции прописаны подходящие источники:
Поддержка источников данных
ClickHouse 21.8, MySQL 8.0.12, Oracle Database 12c (12.1), PostgreSQL 9.3.
Коллеги, подскажите, как собрать конструкцию, аналогичную ARG_MAX на PostgreSQL. Пытаюсь агрегировать по последней записи, не выводя значение в чарт.
Ордер бай и лимит 1
Есть столбец в котором происходит вычитание А из Б.
Вопрос: как сделать так чтоб в этом столбце выводились только отрицательные значения а положительные нет? Вместо положительных можно 0 или оставлять пустым ячейку
С помощью if. То есть if получившееся вычитание<0 then получившееся вычитание<0 else 0
вставить посчитанную таблицу из ексель можно в дашборд?
подключение к гугл-таблице вам в помощь.
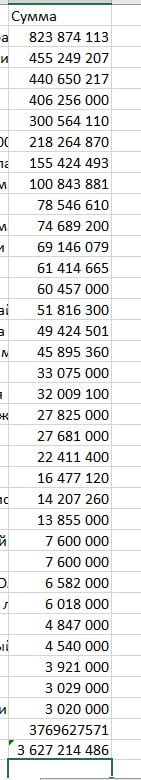
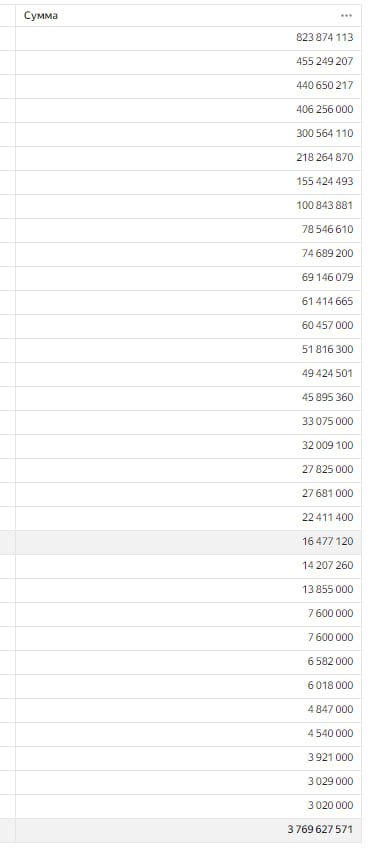
как получается, что при выгрузке чарта, у него в итогах одна сумма, а если считать сумму в ексель, то получается другая?
итоги в ДЛ работают несколько иначе, чем сам показатель.
Короче говоря - у вас показатель скорее всего фильтрует какие-то данные, из-за этого итоги могут отличаться.
Вот ещё кейс: вы считаете количество уникальных пользователей, купивших какой-то конкретный тип техники.
У вас покупатель купил 3 разных типа техники - он посчитается в уникальные покупатели для каждой техники, но в итогах он будет считаться как 1 покупатель, а не 3)
Подскажите, пожалуйста, можно ли с помощью функций datalens получить дату начала текущей недели?
Пробовала с помощью dateadd(today(), "day", -dayofweek(today()), но вижу комментарий что третий аргумент (количество юнитов, которые нужно добавить к первому аргументу) должен быть константой
IF DAYOFWEEK(TODAY()) > 1
THEN DATEADD(TODAY(), 'day', (-1)*DAYOFWEEK(TODAY()) + 1)
ELSE TODAY()
END
как сделать группировку по параметру y в формуле ранк?
RANK_DENSE(SUM(Х]) ORDER BY [У!],"desc")- такая не работает, и не понял по инструкции, как воспользоваться группировкой или сортировкой..
скобочки и сумм
вы порядок сортировки пихаете внутрь функции сум к которой он не применим
почему не работает оператор OR в этому случае, AND работает
потому что так писать не хорошо
а=б OR а=в или a in ()
скажите в чем может быть ошибка?
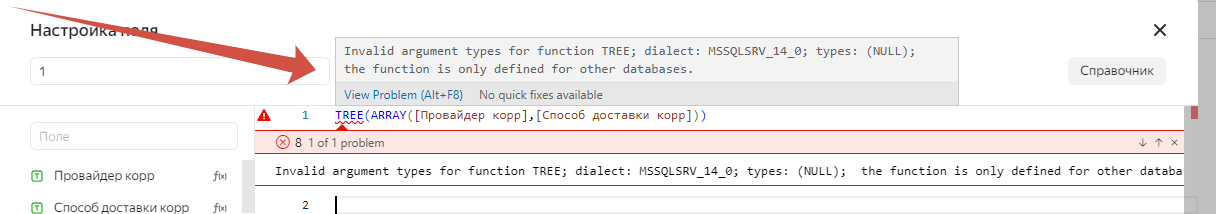
Видимо mssql не знаком с массивами и деревом.
подскажите, пожалуйста, если поле в датасете содержит через запятую несколько логинов сотрудников, то как-то можно разделить логины, чтобы были независимые друг от друга?
возможно, кому-то пригодится, сделал так:
REGEXP_EXTRACT_NTH([logins], "[^,]+[^,]*", 1)
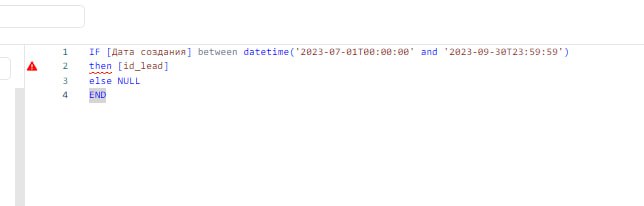
В каком месте поставить datetime?
datetime('.....') and datetime('......')
Может кто-то подсказать, как правильно выкинуть из вычислений последний период?
Столкнулся с такой проблемой - Вычисляю среднее количество зарегистрированных заявок в день/месяц/квартал в зависимости от группировки через параметр и выбор периода в селекторе. Но в вычисления попадают незаконченные периоды, приходится ограничивать диапазон дат через другой селектор.
Может можно как-то решить через формулу?
Пока такая возможность отсутствует.
Конструкция CASE ... WHEN ... THEN не поддерживает несколько условий?
Замените case на if и будет вам счастье
_1
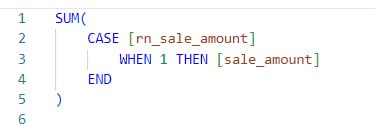
Подскажите, можно ли как то сделать, чтобы один из столбцов не реагировал на селектор? Если в общем то мне нужно в один из столбцов выводить общее кол-во сущностей за все время, а остальные столбцы зависимы от селектора
LOD + BEFORE FILTERED BY
Подскажите, как получить уникальные значения, не их количество, а сами значения.
Есть столбец, в котором нужно взять сумму только уникальных значений
никак
избавиться от ошибки: "Invalid argument types for function ARR_SUM; dialect: POSTGRESQL_9_4; types: (ARRAY_FLOAT); the function is only defined for other databases." возможно?
вот функция arr_sum(CAST_ARR_FLOAT(split(ALL_CONCAT([plan_reach]))))
у вас прямо в тексте ошибки указано, что эта функция предназначена только для других баз данных
подскажите, пожалуйста, что за ошибка в формуле case вылезла?
у вас один из вариантов внутри then возвращает число, а остальные строку
Подскажите - данные в бд изменились, а карта которая цепляется к датасету (а датасет соответственно к бд) отображает старые данные. А так понимаю их можно как то обновить в датасете
если у вас датасет основан на подключении к БД, то чарты при обновлении страницы каждый раз обращаются к БД и забирают свежие данные.
Единственное но - если у вас указано длительное время хранения кэша в настройках подключения
Знающие, подскажите пожалуйста, можно ли создавать вычисляемые поля с переменными из 2х разных датасетов на уровне чарта? Если да, то как?
Например, фактическое значение Х - из датасета с фактом, а плановое значение Y - из датасета с планом и, соответственно, мне надо X/Y, но, кажется, в вычисляемом поле работают только те переменные, чей датасет выбран в редактировании чарта, а поля 2го датасета он не понимает
нет, из двух датасетов нельзя собрать одно поле
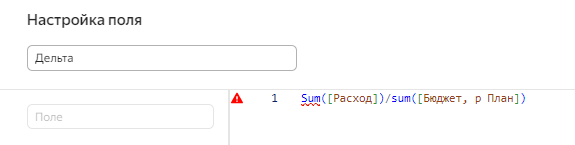
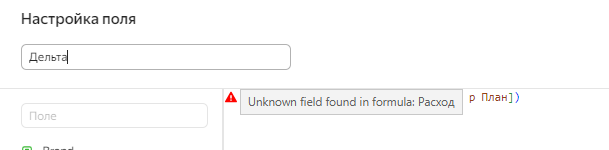
Есть аналог функции AVG_IF для MAX или может кто знает, как такое реализовать?
сделайте IF а по нему MAX )) нашел еще один вариант: создал отдельное булево поле с condition и закинул его в фильтр в чарте.
Подскажите, пожалуйста, есть ли возможность условного форматирования строки (цвет шрифта) в формуле вычисляемого поля ?
Хочу реализовать функционал в индикаторе: если значение меньше порогового значения, то красный эмодзи с красным шрифтом, а если выше - зелёный эмодзи с зелёным шрифтом
Только эмодзи
Добрый день! какую функцию можно использовать, чтобы убрать все до первого пробела и остался Иванов Иван? пример: (111111@gmail.com) Иванов Иван
Сабстринг
подскажите плиз, в даталенс все еще нельзя нормально сделать сравнение кастомных периодов, выбранных в селекторах, в таблицах?
Знаю только как черезql-чарты сделать, но это слишком неудобоно, и через функции типа datetrunc и подобные
Как в Эксель эти 7 дней с теми 18ю поделить друг на друга - нет и вряд ли будет.
Но при сильном желании это можно сделать через запрос с параметрами.
Вывести на двух соседнихьчартах данные из одного датасета с разными селекторами дат - можно давно.
Добрый день! Подскажите какую функцию использовать для переименования значений статусов сделок битрикс 24, в строке Stage ID, источник данных MySQL 5.6?
IF или CASE. Через case проще всего.
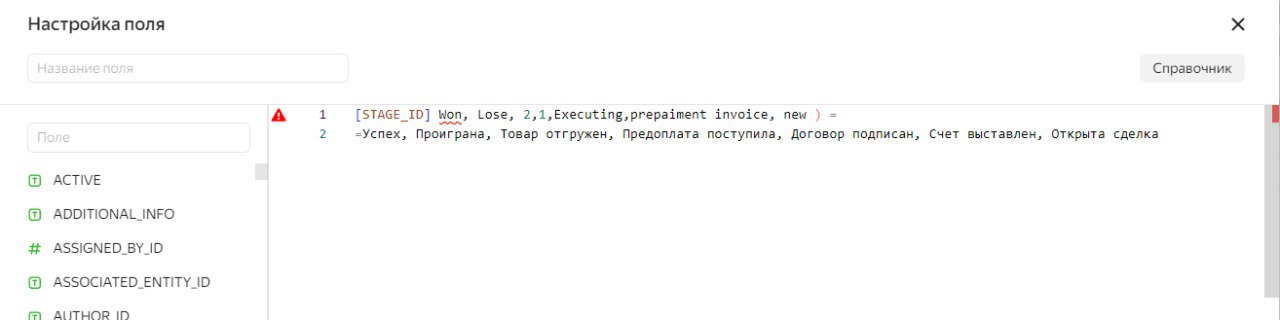
есть аналог функции ? TREE( ARRAY([Продукт - подкатегория],[Продукт - бренд],[Продукт]), работая с бд mysql не работает данная функция. Заранее спасибо.
Нет
Возникла задача сделать вычисляемые поля из разных баз данных. Когда работал с DataStudio с этим проблем не было.
Но работая с DL, такой возможности нет, если я правильно понял раздел в справке.
Вопрос. Можно ли этот вопрос как-то обойти?
Ситуация. Делаю сквозную аналитику, есть расходы директа, есть лиды в битрикс (Куда пробросился номер кампании), есть сделки в битрикс. Как эти данные свести в одну таблицу и рассчитать ROMI, цену клиента и т.д.?
Только сводить всё в один источник (читай "базу данных")
Подскажите, как прописать формулу с COUNTD_IF с перечислением исключающих параметров? Нужно исключить конкретные utm источников
по классике [field] != and [field] != and ...
https://cloud.yandex.ru/docs/datalens/function-ref/COUNTD_IF
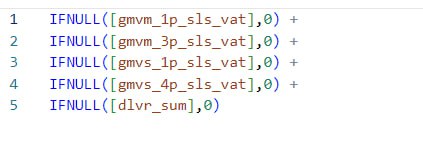
Подскажите пжл, почему в превью не считаются колонки?
как только заменил null на 0, сложил колонки
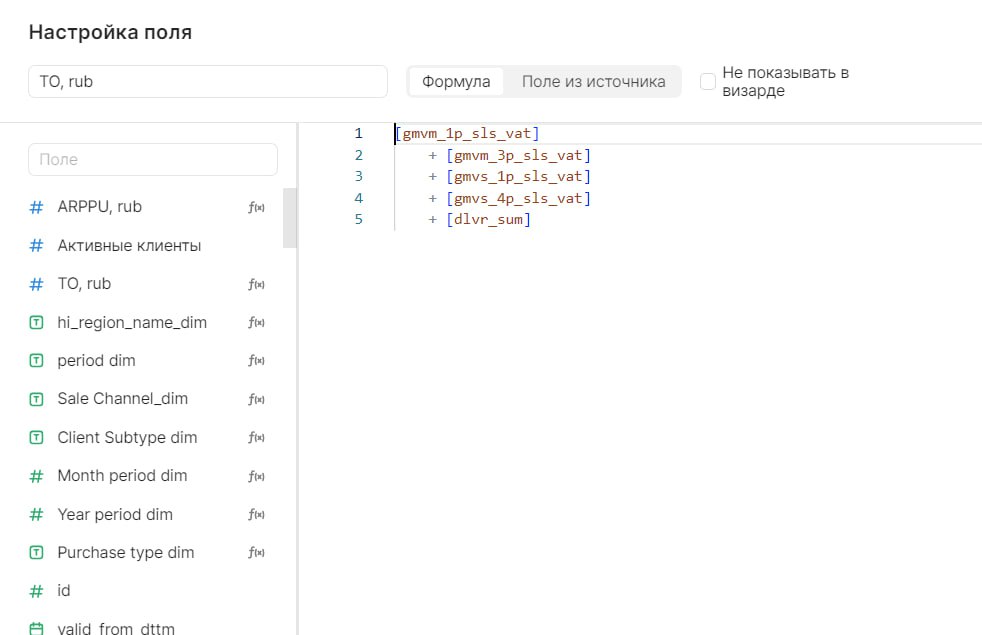
у меня есть значения скорости, у каждого напротив стоит дата, для нескольких вычислений она одинакова. Как сделать формулу, которая выводит среднее всех значений скорости по определённой дате в datalens?
Avg_if
Есть ли функция которая вычисляемое поле переводит в число?
int(), float()
но учтите, если у вас поле, основано на if или case и может возвращать в разных вариантах строку или число - то это плохая идея. но вообще Если вы работаете с числами, то у вас по дефолту результат функции тоже будет число
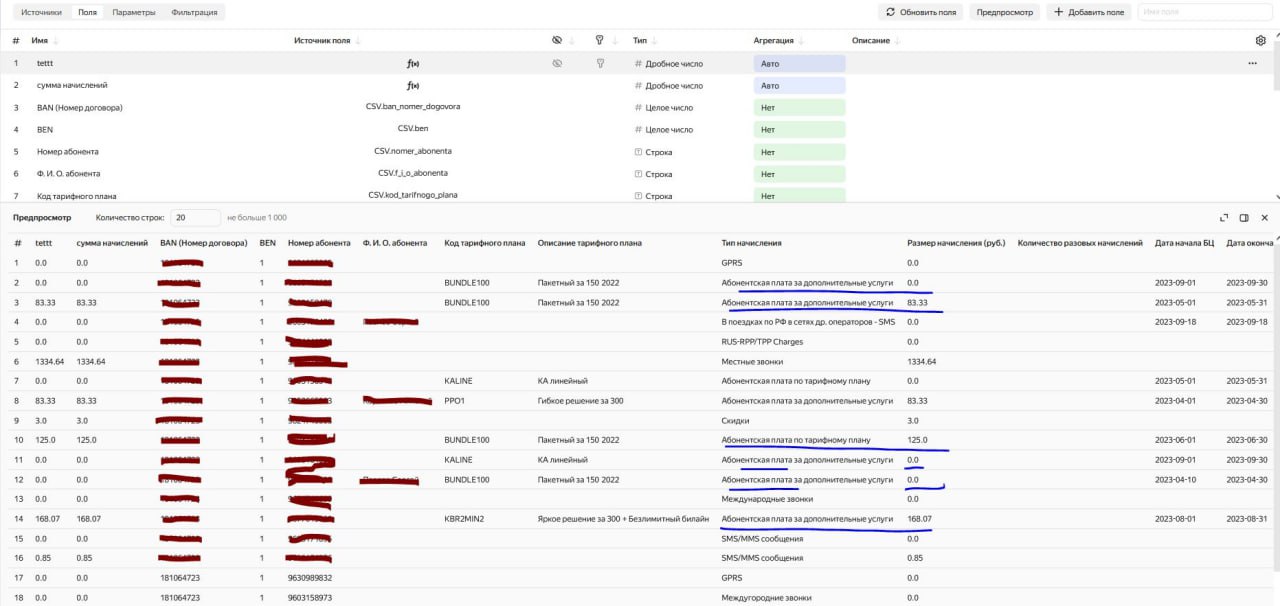
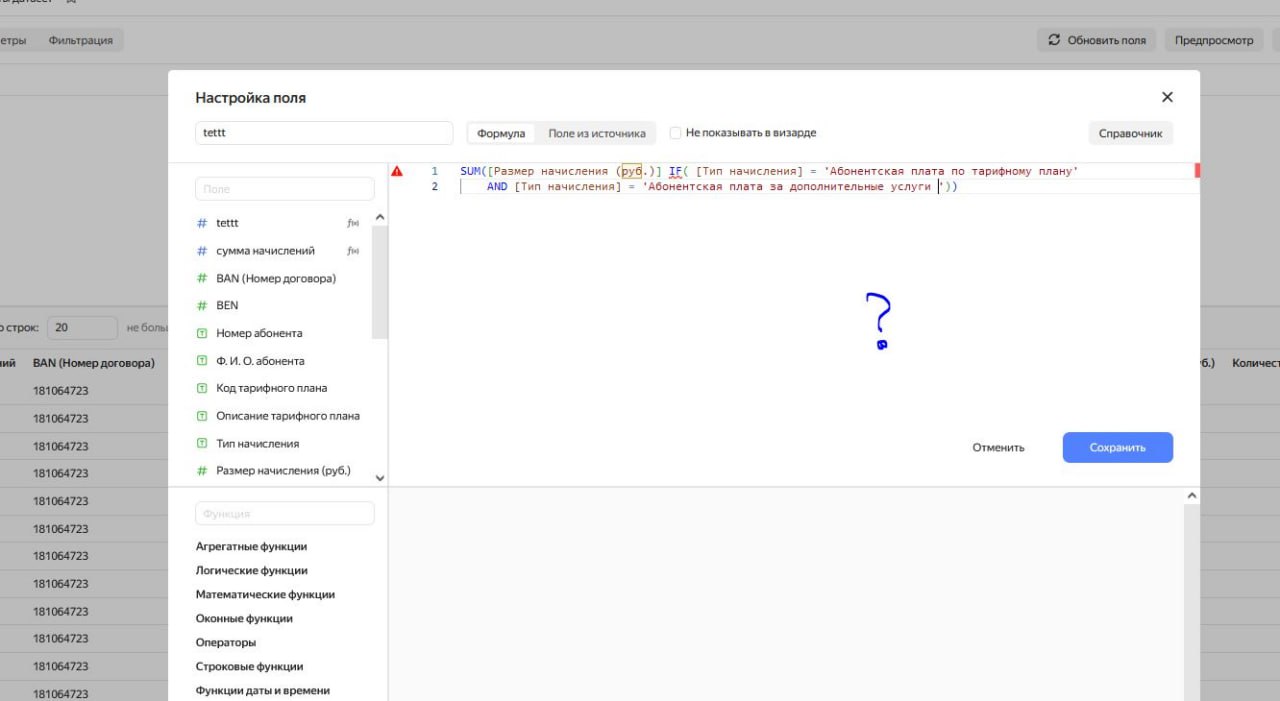
можно ли в конструкции if прописать 2 обязательных условия (относящихся к двум разным полям), не могу найти в документации
AND
Подскажите пожалуйста, как можно посчитать количество строк, которые удовлетворяют определённому требованию. Функция COUNT_IF выдаёт либо 0 либо 1, даже если я добавляю ко всему этому SUM снаружи. Сейчас скину скрины дополнительно
Так sum и не надо добавлять. Просто count_if и всё
А может кто-то подсказать, как посчитать такой параметр:
Дано: 100 заказов
Успешных: 30 заказов
как вывести параметр успешных заказов в %?
23:39
In reply to this message
Пробую так:
[Статус заказа]/COUNT_IF([Статус заказа] = 'Успешно')
но не получается
Count_if(статус = успешно) / sum(count(статус fixed)) Вроде того Fixed даёт посчитать все строки вообще Но lod функция не может быть на верхнем уровне, потому оборачивается ещё во что-то, например тут в sum
визуально график в % повторяет график в штуках
Но есть погрешности в % почему то.
В июле 2022 года
Всего заказов: 2302
Неуспешных: 1600
Успешных: 702
% успешных получается: 30,49%
А на графике показатель: 27,28%
нужно убрать Fixed.
Как получить количество уникальных значений в столбце?
Countd([поле])
подскажите, какую формулу взять для вычисляемого поля, чтобы вычислить сумму отдельных полей в категории ? логика говорит, что-то типа SUM() IF() или SUMIF() или sum() filter_by (). может в синтаксисе что не правильно?
Есть функция SUM_IF В справочнике введите и покажется вам её синтаксис Но мыслите вы верно. Sum_if + and
Друзья, подскажите, пожалуйста, как вычеслить количество уникальных заказов по статусу заказа
Столбик №1
Номера заказов
Столбик №2
Статус заказа (успешно/не успешно) Статус заказа и номер заказа в разных столбах
countd_if([Номер заказа], [Статус]="Успешно")
как-то можно прописать условие, в зависимости от уровня иерархии?
Задача: построить комбинированную диаграмму, на которой столбчатой диаграммой будет показана сумма, а линейной показан прирост к предыдущему периоду. А период иерархией: год -> месяц. То есть, на уровне год прирост к предыдущему году, а на уровне месяц нужно переключать на прирост к предыдущему году.
Есть такая возможность? есть такая возможность.
Читайте про параметры, Datetrunc и функцию AGO
Странный вопрос наверное, но можно ли циклы делать в вычисляемых полях? В справочнике нет ни for, ни while
нельзя
А аналог indexOf есть какой-нибудь? Чтобы в get_item засунуть и получить значение из другого массива под таким же индексом?
Нет
А можно ли задать в пороговых значениях еще показатель, например 4 — это серый цвет?
В градиентах максимум 3 цвета и еще две перпендикулярные прозрачные линии
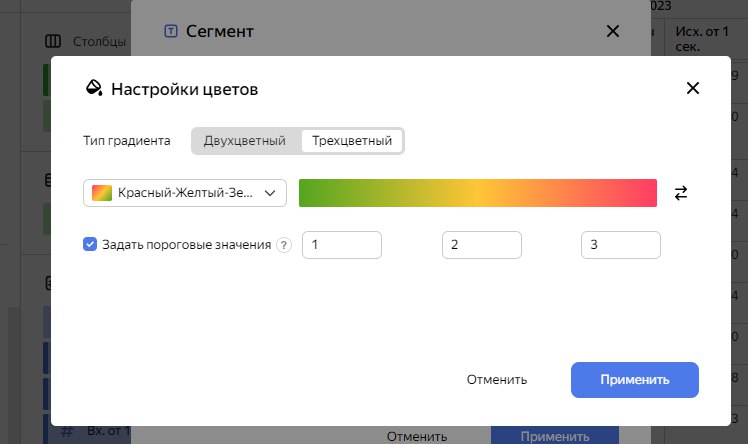
Прочитал предыдущие вопросы/ответы вопрос вроде идентичный, но есть отличие, необходима подсказка:
как получить сумму реализации по 2 артикулам
формула нижеуказанная не сработала, в чем может быть ошибка, напишите если вдруг кто знает
SUM_IF([Реализовано, руб], [Артикул] = 22032522 AND 31665412)
в том что вы нарушаете правила написания условных выражений <=> b and/or a<=>c … и правильные скобочки
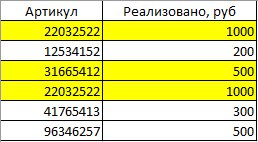
Подскажите, пожалуйста, в чем может быть ошибка при создании иерархии дерева
деревья недоступны для вашего типа подключения деревья доступны для PoestgreSQL и Clickhouse
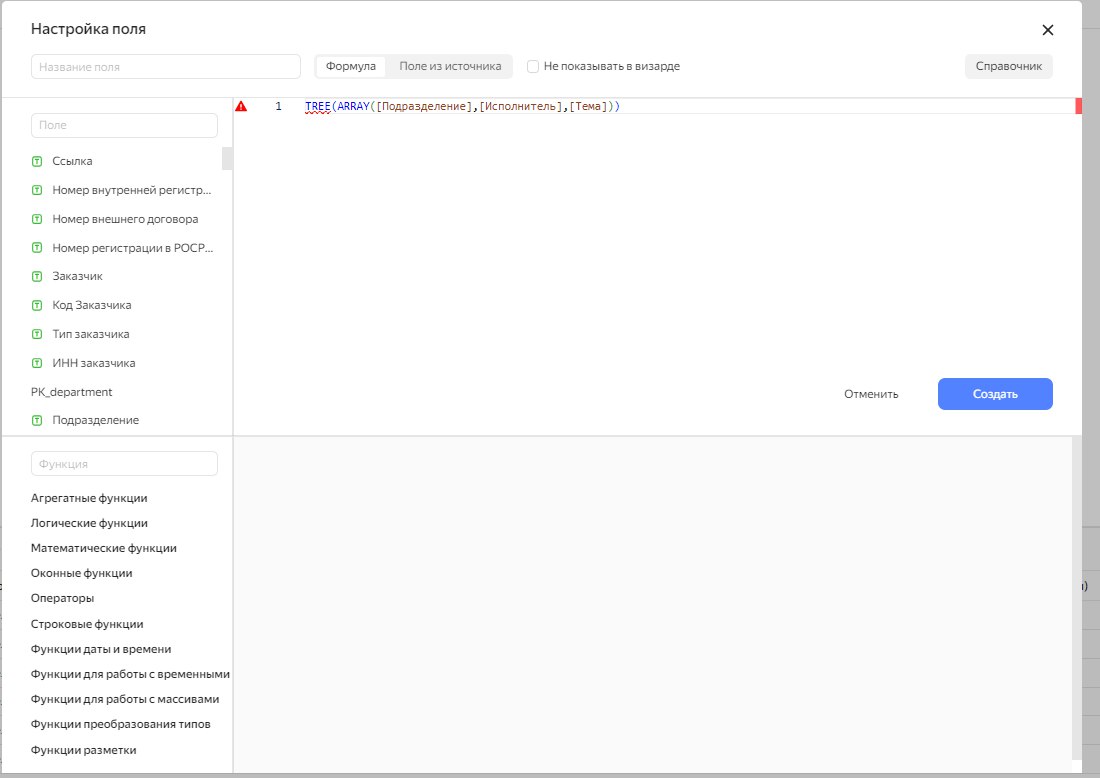
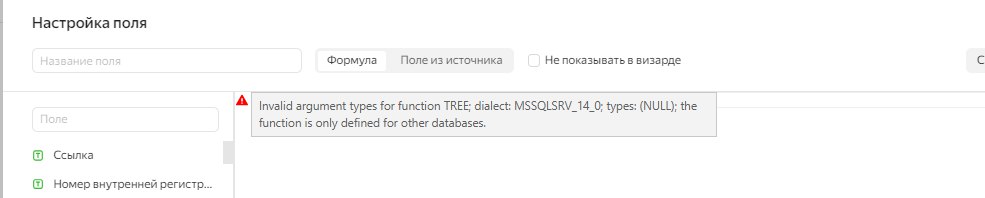
Коллеги подскажите пожалуйста. Уже голову сломал)
Нужно вывести отклонение от цены на сегодняшний день к вчерашнему дню.
В экселе всё просто
Цена сегодня/цена вчера - 1 и всё выводим в процент.
А как в datalens быть? И следом должна идти формула которая сравнивала с ценой на начало месяц или начало года.
(sum(цена)-lag(sum(цена)))/lag(sum(цена))
в поле defaultProductName есть продукты и они содержат название кофе, нужно вычислить выручку от их продажи в той же таблице, что и общая выручка (значение без селектора).
то есть один показатель полный, а другой отфильтрованный. потому что далее найду процент одного от другого.
я так понимаю, что это только в датасете формулу ставить
LOD + BEFORE FILTERED BY
Подскажите, как можно просуммировать столбцы в двух таблицах (с группировкой по userId), если они обе связаны с третьей по userId?
Не могу найти в datalens UNION и получается, что каждая строка из обеих таблиц дублируется несколько раз при пересечении с другой.
К примеру:
Table A (user)
id
1
2
Table B
userId purchaseAmount
1 100
1 150
1 200
2 350
Table C
userId anotherPurchaseAmount
1 250
2 400
Хочется вывести в графике сумму покупок в обеих таблицах по userId
userId sum
1 700
2 750
А вместо этого при join у меня получается такая таблица в даталенсе:
userId purchaseAmount anotherPurchaseAmount
1 100 250
1 150 250
1 200 250
1 350 400
Т.е. дублируются данные
У вас в таблицах B и С должны быть свои идентификаторы заказов. При соединении в зависимости от того как вы делаете это самое соединение у вас эти идентификаторы будут задваиваться. Соответственно для подсчетов вам надо брать лишь одну сумму на каждый идентификатор транзакции, например через Any или max.
Тут не надо понимать в BI, тут надо в реляционной схеме понимать.
А уже в BI просто синтаксис
Нечто вида any([amount]) fixed [tr_id])
Вероятно вопрос не сложный, однако не могу его решить.
Вопрос в следующем, необходимо для построения круговой диаграммы, двум строковымм значениям поставить в соответсвие вычисляемые по формуле данные. Не могу понять как поставить этим строкам рассчитанные мною показатели. Заранее спасибо никак
350 Кто-нибудь может подсказать, можно ли в DataLens подтягивать валютные курсы на каждую из дат? Для того, чтобы в датасете для каждой из дат показатель из нужной валюты переводить в рубли?
в ваш источник данных - пожалуйста.
мб ктото сталкивался.
В чарте значение отличается от дашборда. при одинаковых фильтрах. Куда смотреть?
Причем именно в индикаторе.
Смотреть в инспекторе
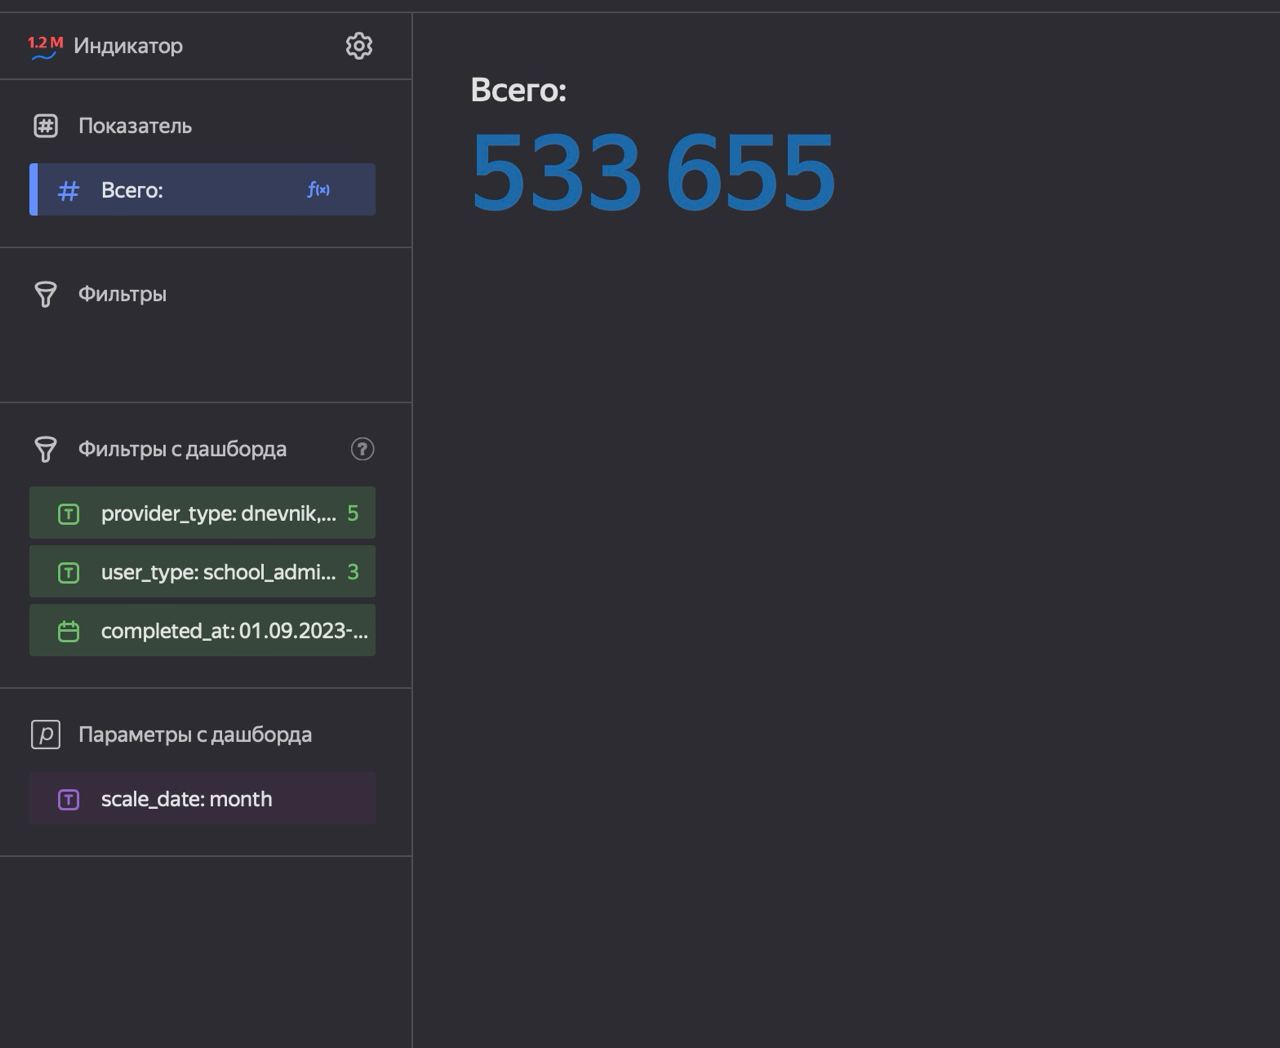
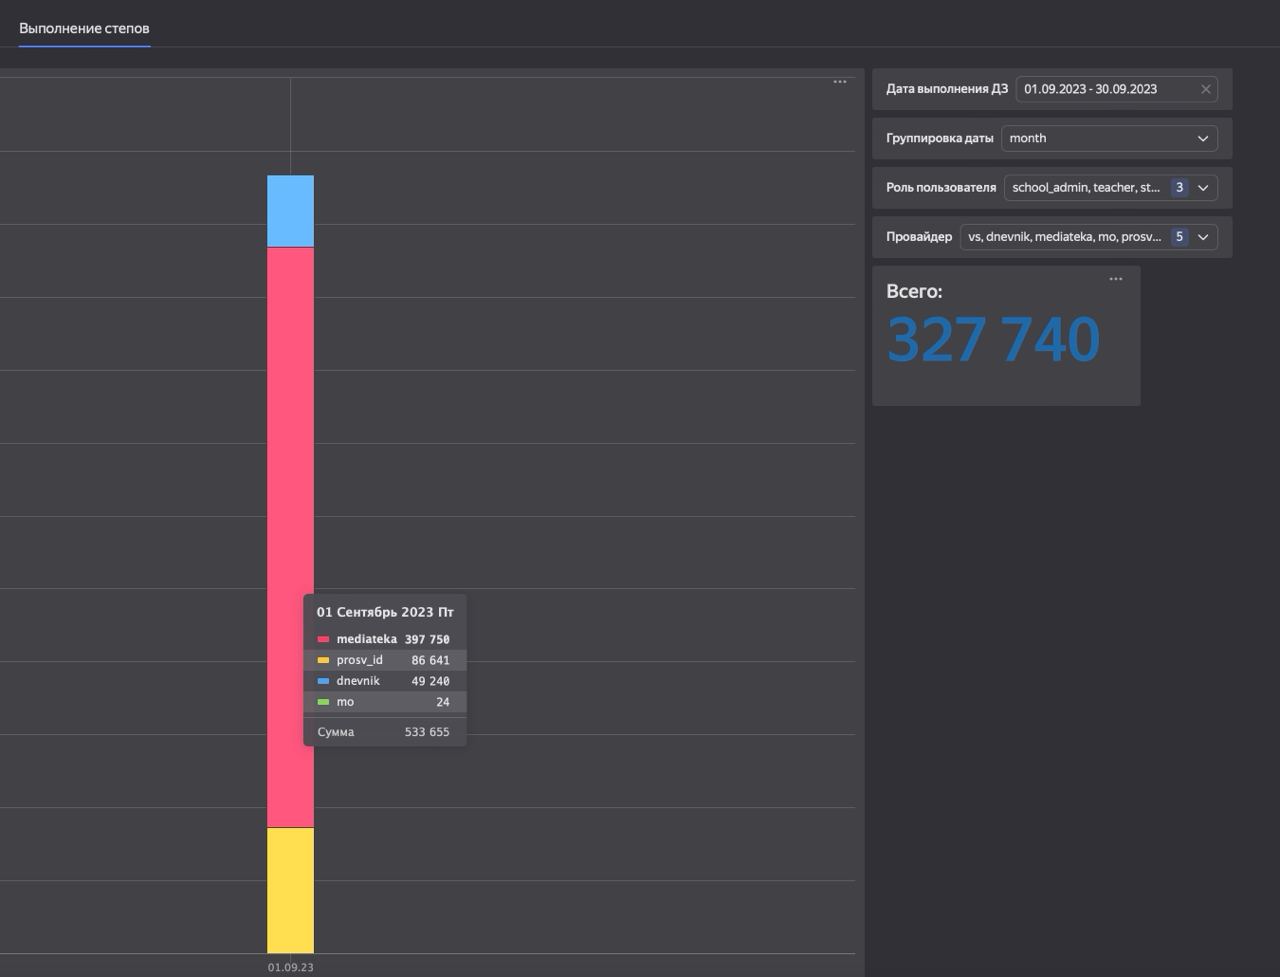
IF (DAYOFWEEK([s.ufSaleDate]) < 3) AND (DATEADD([s.ufSaleDate], 'day', 5) < DAY(TODAY())) AND [Сумма счета] < [cheta.Oppo_chet]
THEN SUM([Сумма для условий поставки])
ELSEIF (DAYOFWEEK([s.ufSaleDate]) BETWEEN 3 and 6) AND (DATEADD([s.ufSaleDate], 'day', 5) < DAY(TODAY())) AND [Сумма счета] < [cheta.Oppo_chet]
THEN SUM([Сумма для условий поставки])
ELSEIF (DAYOFWEEK([s.ufSaleDate]) = 7) (DATEADD([s.ufSaleDate], 'day', 5) < DAY(TODAY())) AND [Сумма счета] < [cheta.Oppo_chet]
THEN SUM([Сумма для условий поставки])
ELSE NULL
END
Ошибка: Failed to parse formula: unexpected token подсвечивается на первом THEN
Подскажите, в чем ошибка :(
Такая ошибка - синтаксис: запятые, скобки и т.п.
Посмотрите скобки, вот эта, например, к чему относится.
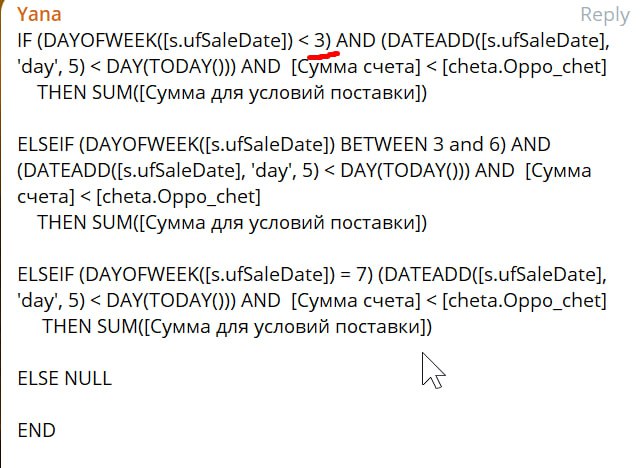
Подскажите, пожалуйста, если сталкивались - можно ли решить проблему ниже внутри datalens (или нужно добавить расчет на уровне исходных данных).
Дано: датасет - список заказов (дата и время, номер, цена ДО скидки, скидка).
Хочу: вывести столбчатую диаграмму с ценой С УЧЕТОМ скидки.
Делаю: добавляю вычисляемое поле с формулой Цена до скидки * (100 - Скидка) / 100
Результат: в превью все корректно показано, на графиках ерунда (отрицательные значения)
Предположение: datalens суммирует для даты все цены, потом все скидки, поэтому скидка получается больше 100%. Не пойму как заставить сначала рассчитать по каждой позиции как в превью, потому же суммировать все значения по дате.
Нужно было обернуть все выражение в SUM: SUM(Цена До * (100 - Скидка)/100)
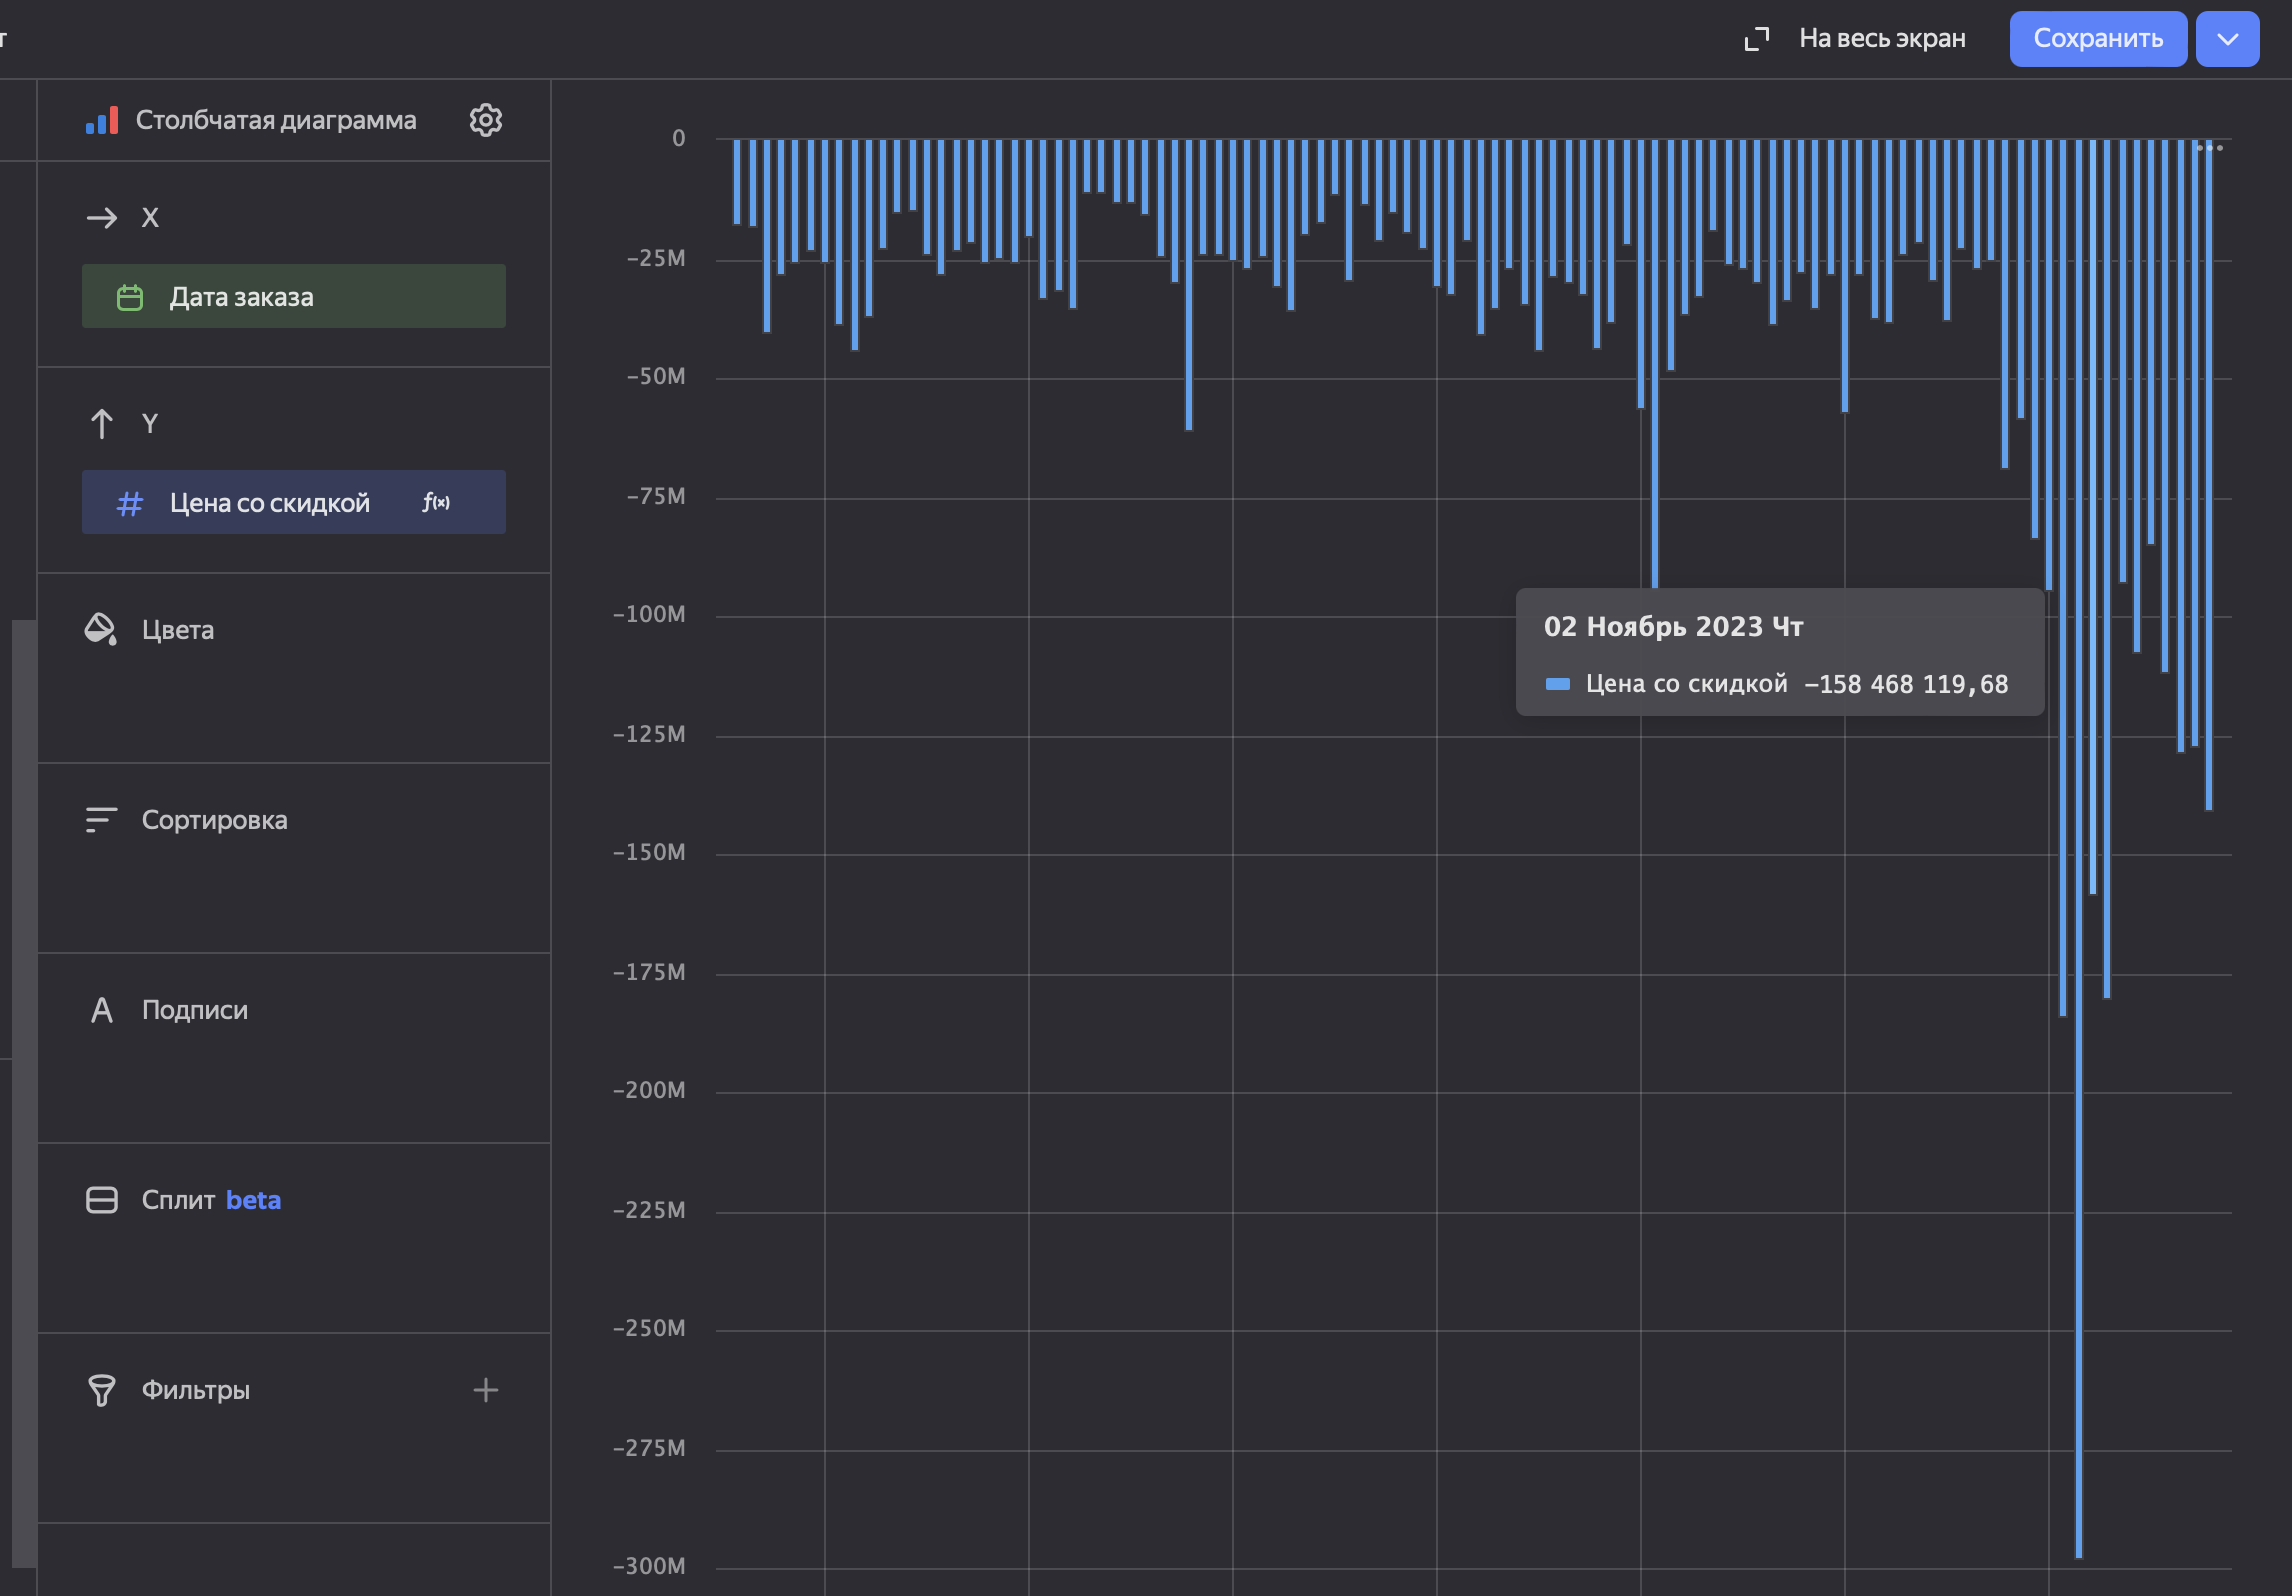

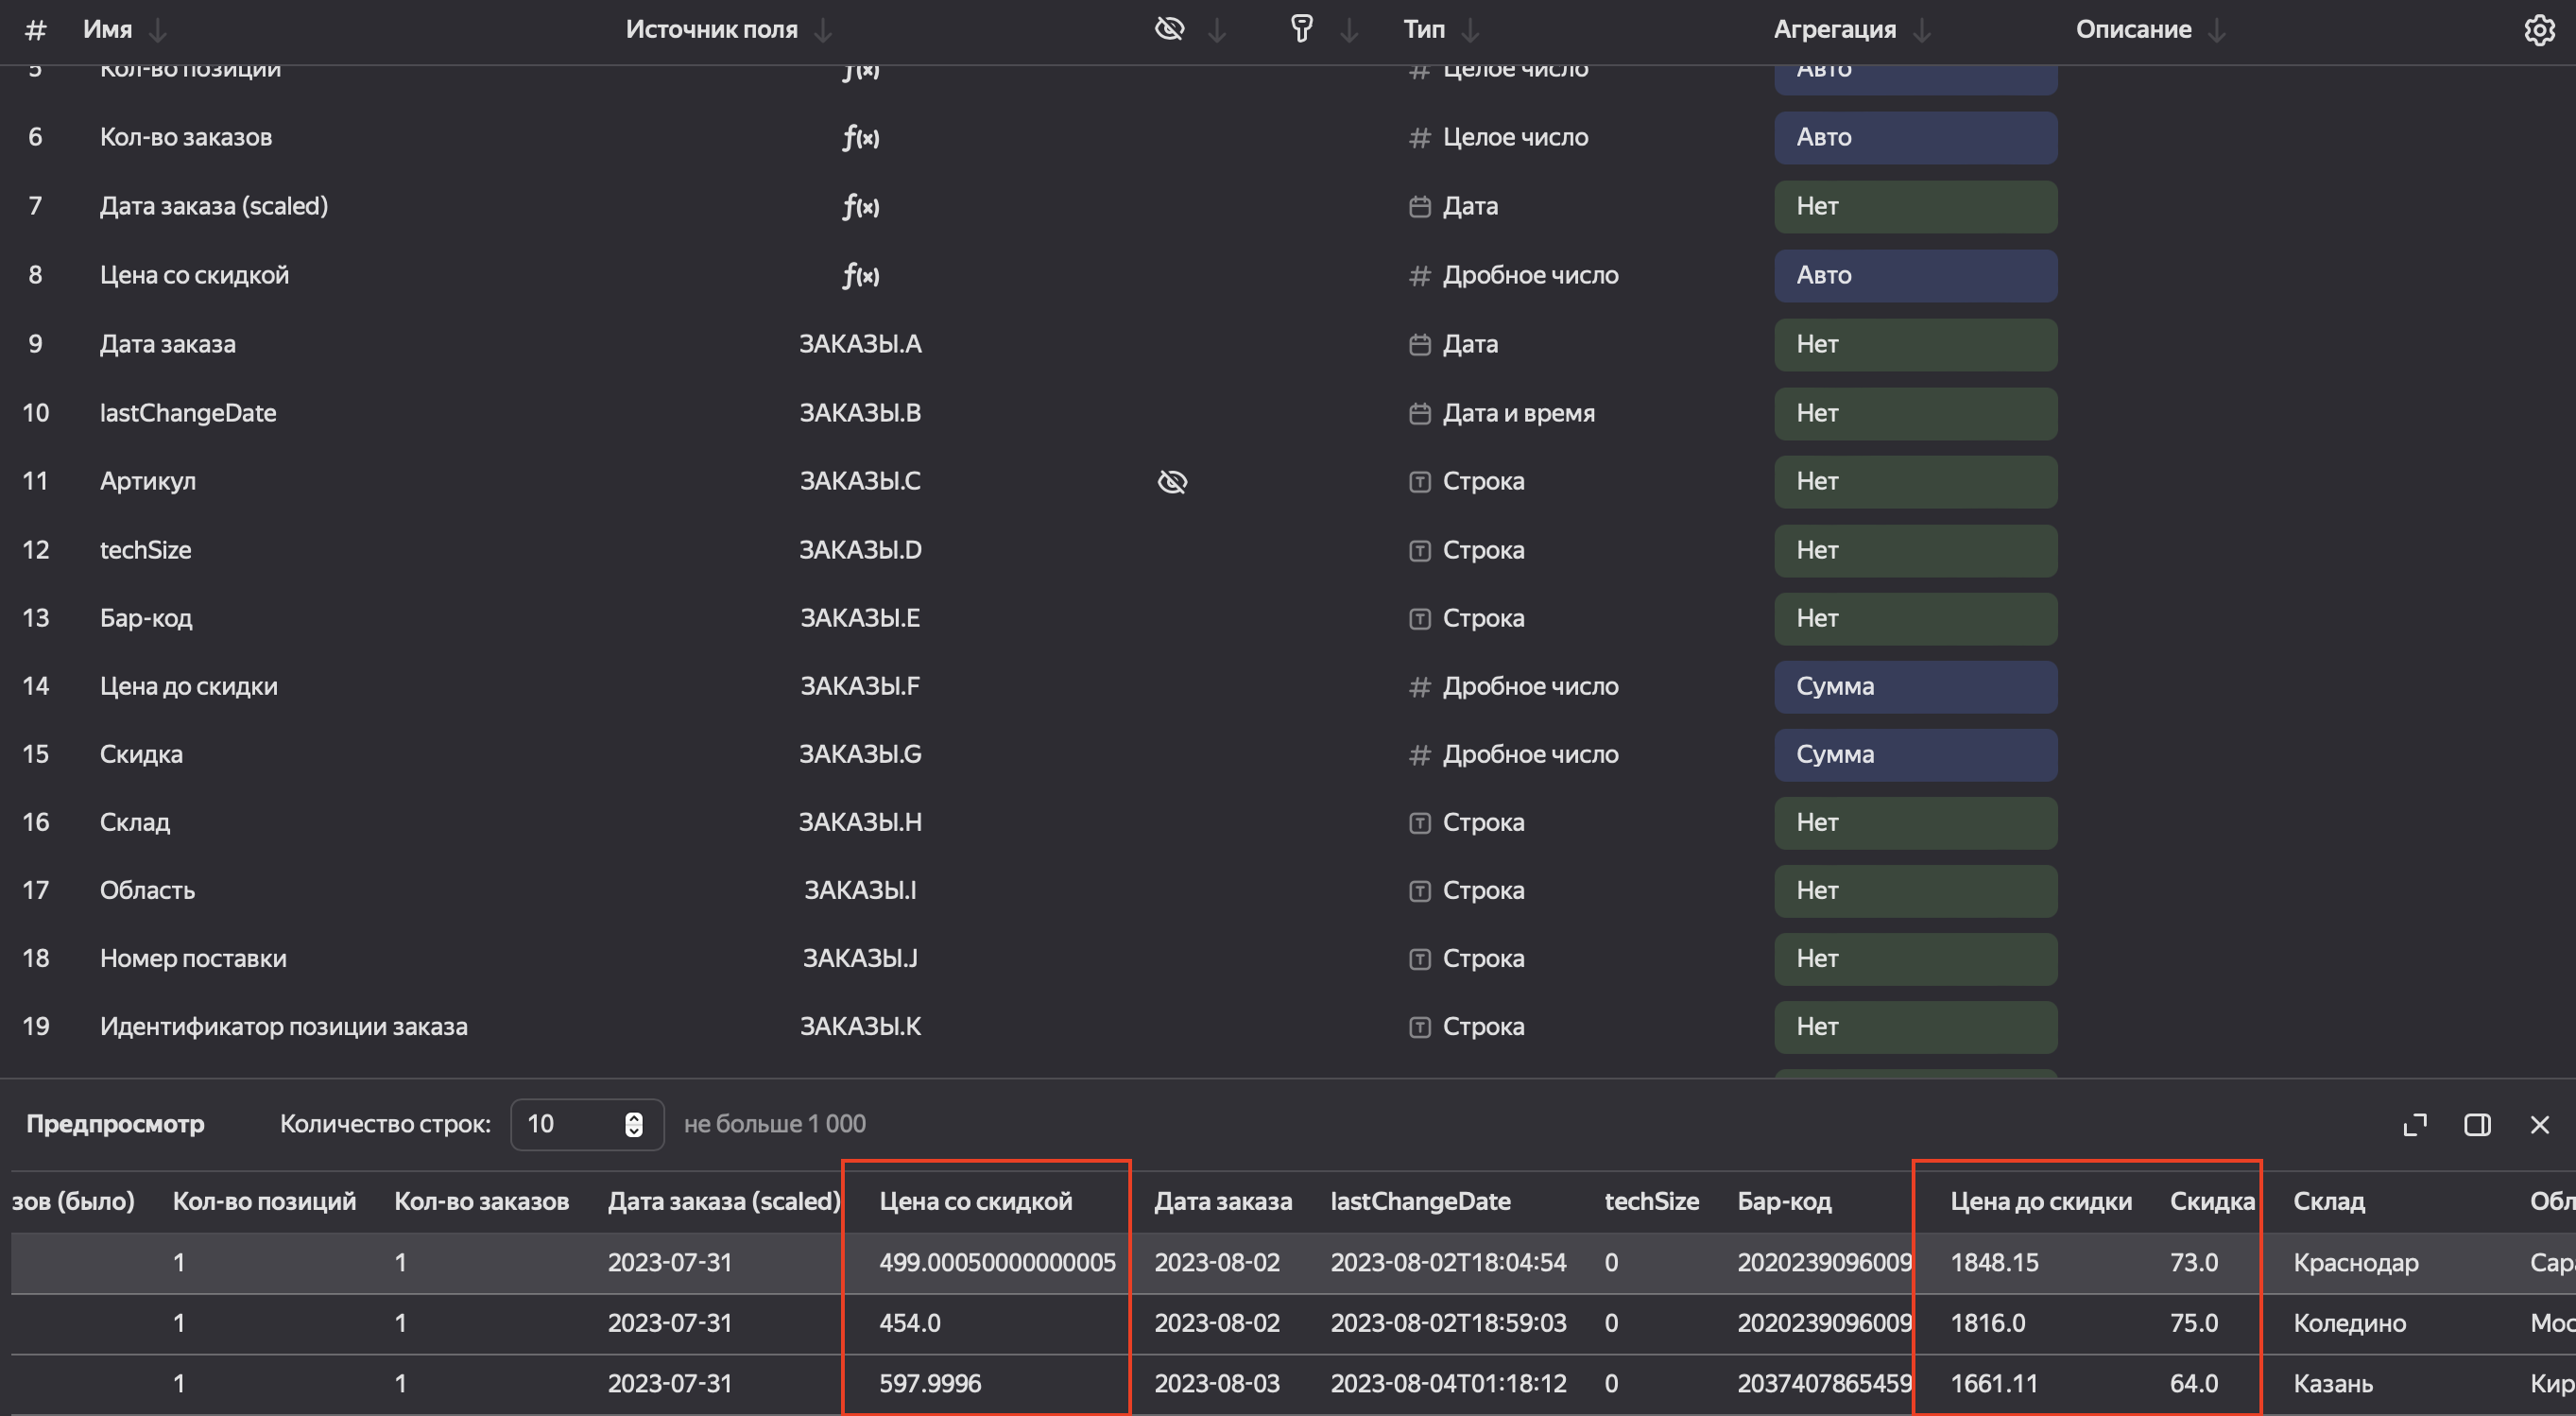
DATETRUNC([d],[scale])
почему то такая формула выдает ошибку, если ставить гранулярность любую кроме дня. даты стримятся из Биг квери.
эта функция для некоторых подключений поддерживает только 2 параметра...например для БД на PostgreSQL... т.е. ты можешь задать скейл, но количество этих скейлов задать нельзя
Подскажите, пожалуйста, решение следующей задачи.
Есть объект с планом выполнения. План выполняется в 2 задания. При выводе таблицы в 4 столбца - расчет Плана верный. При удалении Номера задач план складывается, хотя он один на весь объект - 52. Какой функцией можно воспользоваться для правильного расчета Плана?
Измерения:
Объект
Номер задания
Показатели:
План: SUM_IF([PlanArea],[OperStatus]="done")
Количество заданий: COUNTD([MachineTaskId])
https://t.me/YandexDataLens/28620/70331
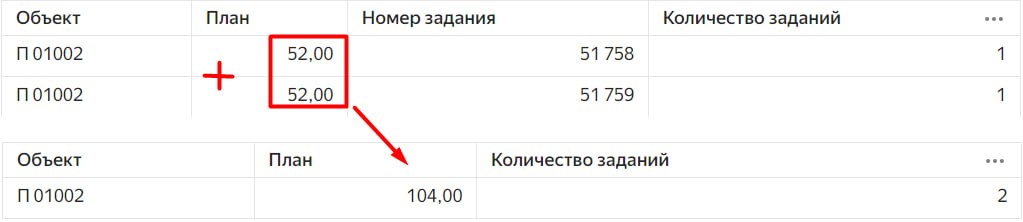
пишу так поле:
IF [c.typeId] = 'PARTNER' THEN ifnull(INT([c.limit_partner])/100, 0)
else NULL
end
агрегирую затем как Сумму (потому что мне нужна сумма лимитов всех компаний, которые заключали сделку в какой-либо день)
такая проблемка, поле c.limit_partner - лимит компании, в таблице у меня группировка идет по Дате, в определенную дату сделок по одной и той же компании может быть несколько, но мне нужно, чтобы, лимит одной и той же компании не суммировался.... Например, в день было совершено 3 сделки, 1 сделка компании А, лимит которой 10 000, и 2 сделки компании Б, лимит которой 15 000, по сути поле выше пишет сумму как 40 000, а правильно должно быть 25 000.
так как у вас либо лимит, либо нулл, то сумма будет null
ну а задваивания убираются с помощью уровней детализации LOD
Подскажите, в даталенсе нельзя складывать в одном индикаторе два значения из разных датасетов? Или я что-то неправильно делаю
Все правильно делаете, нельзя делать вычисления на основе разных датасетов
Подскажите, пожалуйста, можно ли вывести столбец, которое показывало бы значения за вчерашний день?
То есть, в таблице есть строки сгруппированные по месяцам (Январь, Февраль и т.д), в фильтре выбираешь Дату 8 ноября и в этом столбце в строке с месяцем ноябрем просчитывается значение за вчерашний день, остальные строки с другими месяцами пустые
Для начала надо поместить в таблицу данные за сегодня
Подскажите, пожалуйста, как прописать в CASE сразу несколько значений которым нужно присвоить одно и тоже имя? Я пыталась и через IN и через OR и через AND (хотя это не правильно) и через запятую - никак не получается)) Поизучала синтаксис, примера с использованием нескольких значений не нашла. До этого я каждое значение прописывала в WHEN и THEN но это и дольше и больше писанины, хочется более ёмко написать. У меня сейчас вот такая формула и она не высчитывается:
CASE [Марка]
WHEN "geely emgrand" THEN "geely"
WHEN "opel corsa" THEN "opel"
WHEN "lada 2115" AND "lada vesta" AND "lada granta" AND "lada 2114" AND "lada largus" THEN "lada"
WHEN "hyundai solaris" AND "hyundai accent" AND "hyundai sonata" AND "hyundai elantra" THEN "hyundai"
WHEN "toyota camry" AND "toyota bB" AND "toyota vitz" AND "toyota probox" AND "toyota passo" AND "toyota ractis" THEN "toyota"
WHEN "kia rio" AND "kia ceed" AND "kia spectra" AND "kia cerato" AND "Kia K5" THEN "kia"
WHEN "skoda octavia" AND "skoda rapid" THEN "skoda"
WHEN "nissan sentra" AND "nissan wingroad" AND "nissan liberty" AND "nissan tiida" AND "nissan almera" THEN "nissan"
WHEN "renault sandero" AND "renault logan" THEN "renault"
WHEN "lifan cebrium" THEN "lifan"
WHEN "chevrolet cruze" AND "chevrolet niva" AND "chevrolet cobalt" THEN "chevrolet"
WHEN "ravon gentra" AND "ravon r4" THEN "ravon"
WHEN "ford focus" AND "ford fusion" AND "ford galaxy" THEN "ford"
WHEN "volkswagen polo" AND "volkswagen jetta" THEN "volkswagen"
WHEN "honda fit" AND "honda civic" THEN "honda"
WHEN "citroen C5" THEN "citroen"
WHEN "haval jolion" THEN "haval"
WHEN "chery tiggo" THEN "chery"
WHEN "geely coolray" THEN "geely"
WHEN "changan cs35 plus" THEN "changan"
WHEN "jac j7" THEN "jac"
END
Успешный синтаксис для нескольких результатов вот такой:
IF [поле] IN (значение1, значение2) THEN результатA
ELSIF [поле] IN (значение3, значение4, значение5) THEN результатB
ELSIF [поле] = значение6 THEN результатC
END
возможно ли прописать 2 и более геоточки для одного значения? Если да, через какой символ?
нет, массивом нельзя. Две точки - это две записи в вашем источнике данных. Да и по смыслу - это же две точки на карте.
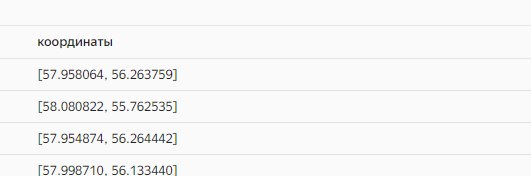
Подскажите, пожалуйста, как реализовать возможность замены в строке любых цифры на символ, скажем "*"?
Есть REGEXP_REPLACE, но работает не на всех источниках, есть еще просто REPLACE
скажите есть ли функция в datalense считающая пропущенные значения?
COUNT_IF(ISNULL([поле]))
Подскажите, пожалуйста, как решить задачку в ДЛ.
Есть таблица CSV с продажами за 4 года.
Требуется построить столбчатую диаграмму с выручкой, прибылью и кол-вом клиентов за 4 года с группировкой по когортам от даты первой покупки.
Через FIRST(MIN([Дата покупки]) WITHIN [Клиент]) Даты первой покупки собраны, но в чарте без добавления клиентов, конечно, не работает.
Отсутствующие поля добавляются через include
оператор RANK может быть задан по нескольким значениям?
RANK(количество сделок, сумма сделок) и на основе этого получить общий RANK?
Нет. Подумайте в сторону RANK для среднего чека (Avg(СуммаСделок/КолвоСделок))
Объединяю несколько полей, условно: CONCAT([Текст1], [Текст2]). Подскажите, пожалуйста, возможно ли выводить [Текст2] с новой строки? P.S. Получаемое поле используется в индикаторе.
Увы, перенос на другую строку не работает
Есть два поле:
- Одно в формате строчки с пробелами.
Из него мне надо удалить пробелы там данные такого формата "1 356,73" где в цифре есть пробел.
Я прокидываю данную функцию:
FLOAT(REGEXP_EXTRACT( (REGEXP_REPLACE([Выручка по всем типам оплат (минус комиссия)]," ", "")), "[0-9]+" ))
После чего - все пробелы убираются но теряется хвост после запятой. Как его не терять?
FLOAT ( REPLACE((REPLACE([Выручка по всем типам оплат (минус комиссия)]," ", "")), ",", "."))
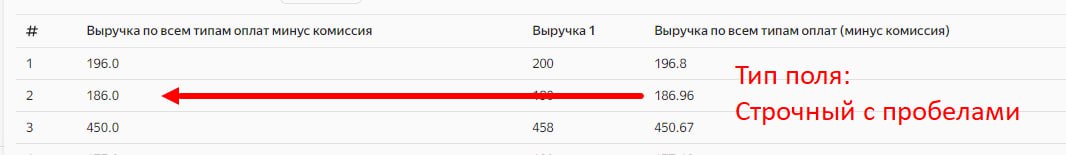
На линейный график можно добавить линию тренда? Как в гугл шитс или экселе?
Можно, используя комбинированную диаграмму (или добавить ещё одни игреком в линейную) и если самому рассчитать тренд Можно. Сделав для этого вычисляемое поле. Можно и в обычном линейном чарте одной из линий. Комби если нужно одно столбцами а тренд линией
Подскажите в чем принципиальное отличие использования if condition == 0 then else от ifnull( 1/0, 0). На примере выдает данные согласно ожидания, но в продакшене влияет ли на работу? И стоит ли использовать первый вариант
Тем, что 0 это ноль, а NULL - ничего.
подскажите, пожалуйста, правильный синтаксис формулы AVG, чтобы при расчете средней зп за месяц, она считала зп по ФИО только 1 раз
Within не только месяц тогда должен быть, но и фио Тогда сначала делаете avg с within по фио и месяцу, а затем внешне avg с within только по месяцу
Подскажите, пожалуйста, возможно ли на индикаторе вывести mom или yoy, если да, то как это рассчитать? при применении функции ago, выплывает ошибка
Необходим GROUP BY в запросе, индикатор такой возможностью не обладает. В качестве альтернативы можете воспользоваться QL-чартом вида «Индикатор».
Подскажите, могу ли я реализовать следующее:
У меня есть датасет, в котором есть два поля:
1. ID
2. Город
У ID может встречаться несколько городов.
Мне нужно получить таблицу вида:
1. ID
2. Города - где через запятую будут перечисляться города, принадлежащие данному ID
Для этого подходит функция grouparray в БД ClickHouse. Воспользоваться ей можно при помощи QL-чарта или SQL в датасете.
На скрине у меня стоит фильтр. Он работает. так как число 182 корректно. Но если я этот индикатор помещаю в дашборд, то как будто фильтр перестаёт работать и показывает уже не 182, а другое число, которое соответствует неотфильтрованному подсчету
Селектор на дашборде значит есть, а он перекрывает действие внутреннего фильтра.
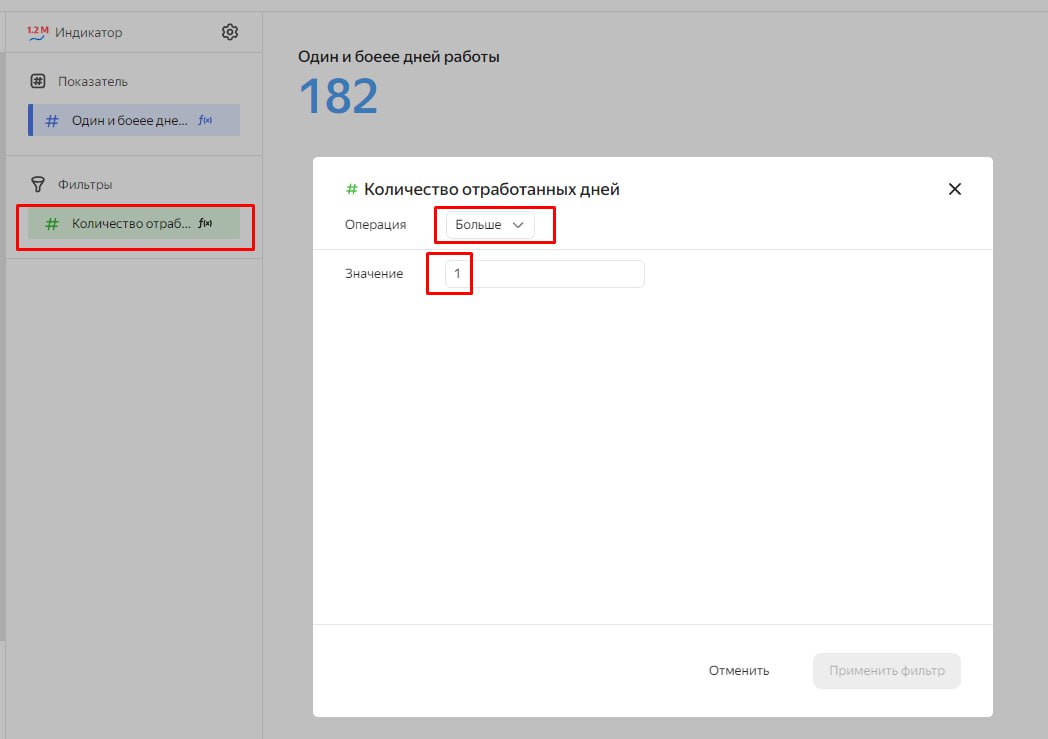
У меня таблица такого вида. Могу ли я добавить столбец в который буду прописывать числа для каждого филиала и потом на их основе считать что-то другое?
Нет
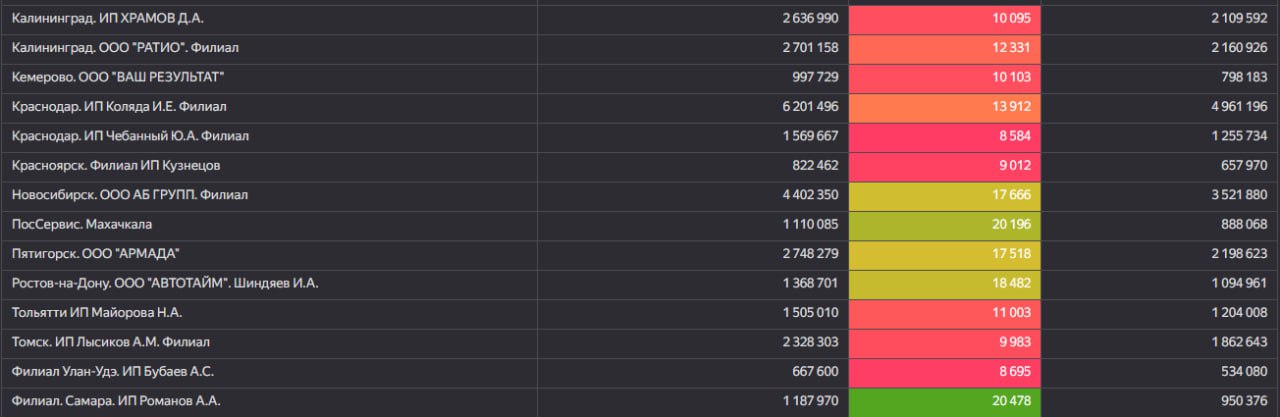
В дл есть аналог функции array join как в кликхаусе?
она есть в КХ - этого достаточно
почему выдает такую ошибку? в фильтрах стоит знаменатель не равно нулю
Фильтр тут не поможет, в формуле непосредственно делайте проверку на ноль If знаменатель=0 then 0 else деление end
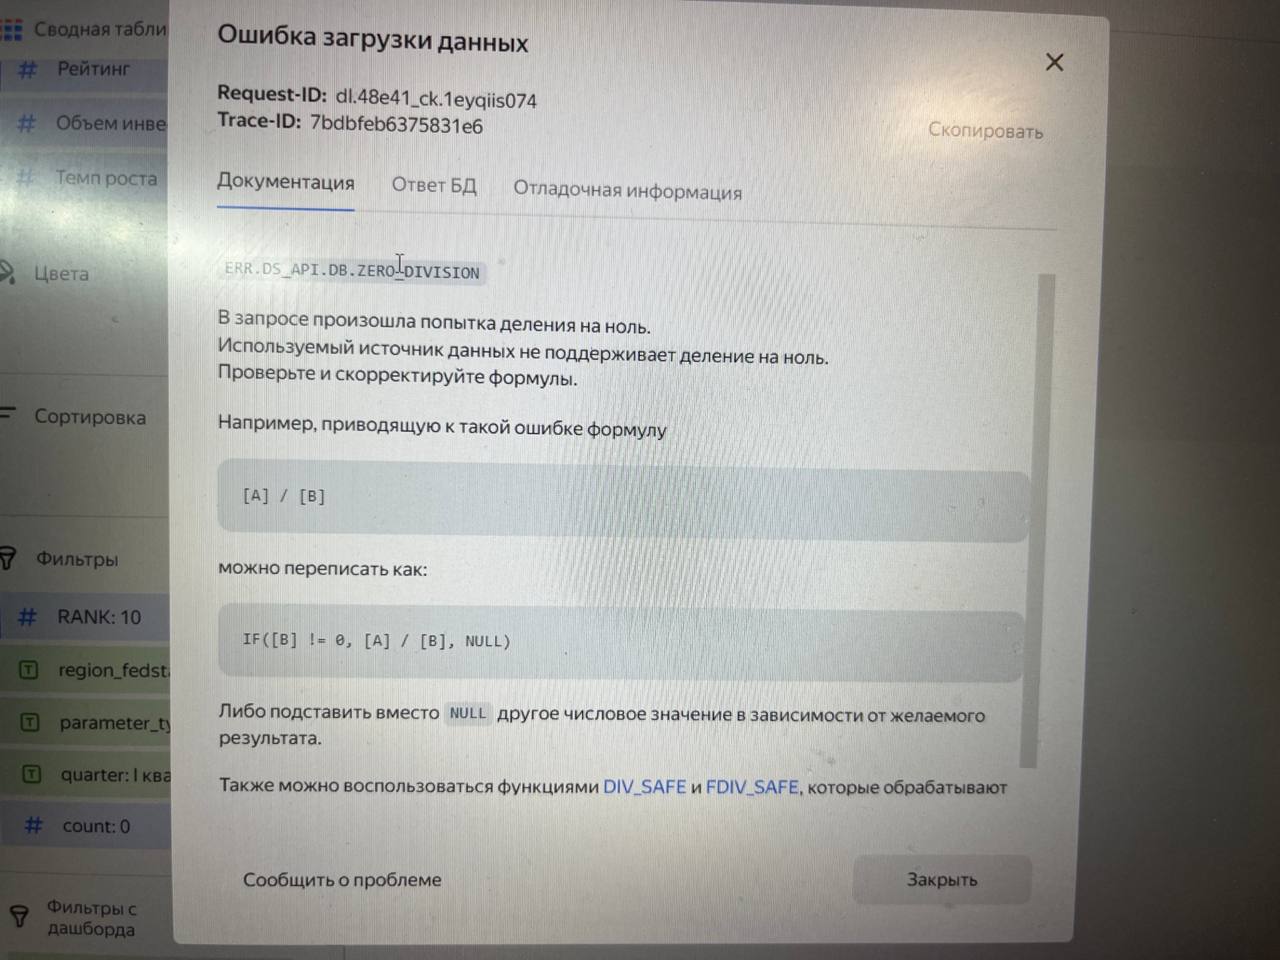
Прошу извинить, если этот вопрос обсуждался ранее, а мне он не попался, но можно ли решить "внутри" ДЛ проблему, когда суммарное значение подитога для нескольких строк, содержащих значение некоторого расчетного показателя, не совпадает с суммой отдельных значений показателя по каждой строке?
Поясню на примере. Пусть у нас есть датасет, содержащий результаты продуктовых экспериментов в виде записей о покупках(sales) тестовой группы (tg=1) и контрольной группы (tg=0), причем как в период эксперимента (period=1), так и в период до начала теста (period=0)
По итогам теста вычисляется метрика прироста продаж по формуле:
sum_if(sales, tg=1 and period=1)-sum_if(sales, tg=1 and period=0)*sum_if(sales, tg=0 and period=1)/sum_if(sales, tg=0 and period=0)
Так вот, если сделать таблицу из нескольких строк вида ид_теста+прирост с подведением подитога, то последний будет существенно отличаться от суммы приростов по каждому тесту по отдельности.
Можно ли как-то "синхронизировать" суммарный подитог по вычисляемому показателю с условием с суммой отдельных значений этого же показателя? https://t.me/YandexDataLens/28629/72147
Никто не сталкивался с задачей создания поля, в котором бы выводился номер недели внутри
подскажите пжл рассчитываю некоторый показатель. Хочу получить таблицу по месяцам 1)с этим показателем (все ок) 2)с этим показателем за предыдущий месяц (не получается, неправильно прописал формулу?), 3)разница (не получается)
функция lag
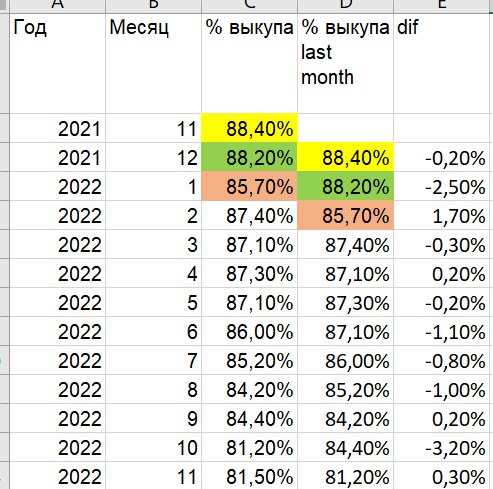
Подскажите, пожалуйста, хочу сделать индикатор, показывающий магазин - лидер по выручке за период. Какую формулу использовать? Как найти максимум понятно, а как название магазина добавить?
Воспользуйтесь функцией ARG_MAX. Подробнее об этом вы можете прочитать в документации.
подскажите пожалуйста как сделать поле которое будет вычислять дату, когда было показано максимальное значение.
IF [max_vel] = MAX([max_vel])
THEN
[date]
END
Пробовал так, находит на уровне датасета, когда я пытаюсь добавить это поле в чарт, Получаю ошибку:
" "message": "Inconsistent aggregation among operands" "
DataLens формирует SQL-запросы, и в SQL сравнивать строки с агрегатами нельзя — WHEN a = MAX(b) не работает. Воспользуйтесь функцией ARG_MAX, если её поддерживает источник.
а можно сделать так, чтобы lag или другая функция показывала предыдущее значение по тому же региону? Чтобы в дальнейшем добавить rank
задать соответствующую сортировку
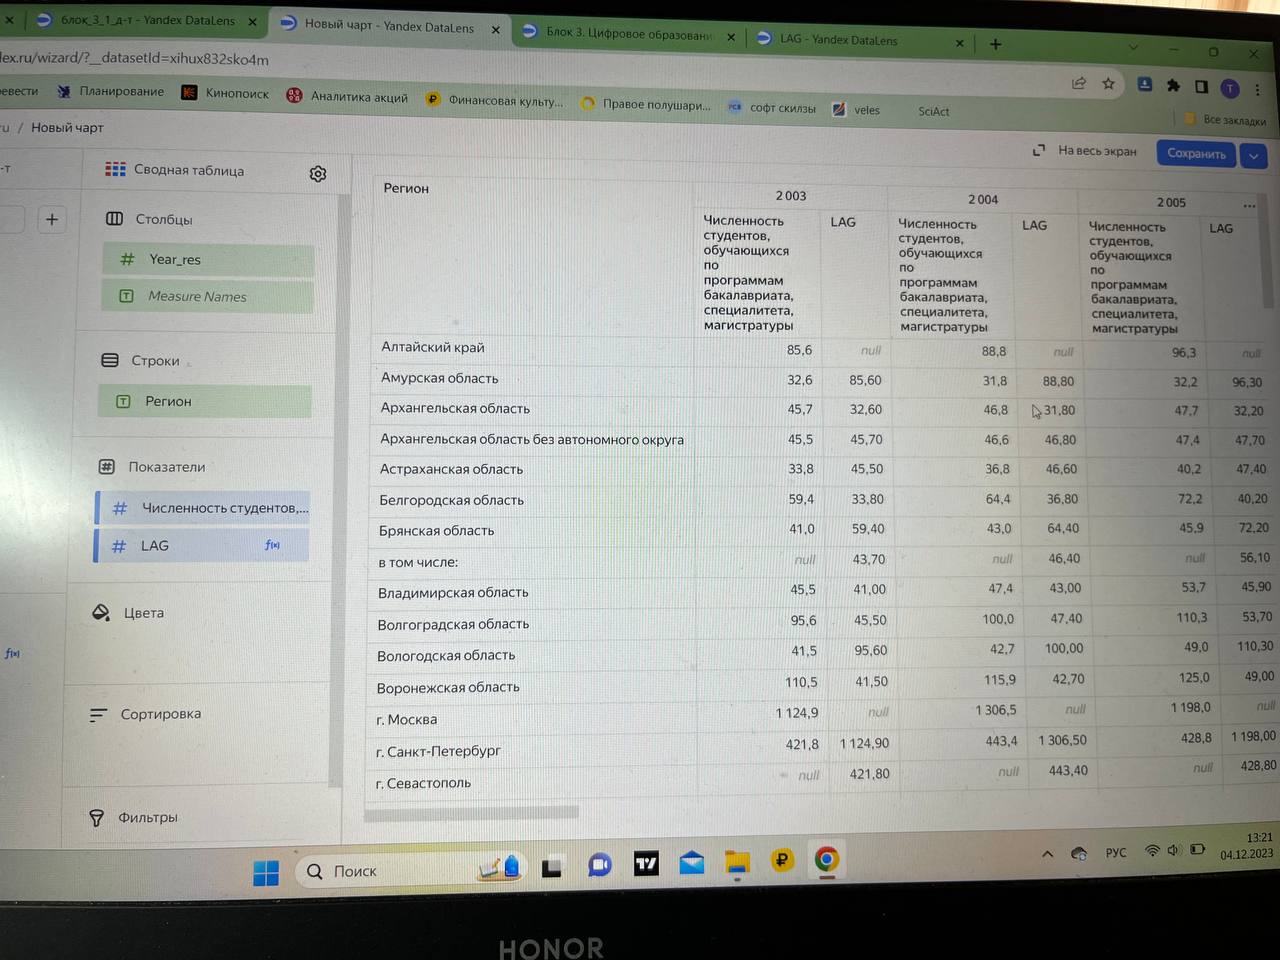
подскажите пожалуйста как вывести показатель стоимость лида если данные по лидам и затратам из разных дата-сетов
Нужно объединить данные на уровне источника (не в DataLens) и собрать один датасет(в DataLens)
Итак, исходники: таблица, где есть отдельно артикулы и отдельно штрихкода. Мне нужно чтобы в чарте в сводной таблице возвращалось подсчитанное кол-во строк используя эти две переменные. Аналог экселевской счетеслимн.
Полезно формулировать визуализации, используя термины SQL, чем Excel. Если вам удастся сформировать подходящий SQL-запрос — построить визуализацию не составит труда.
COUNT_IF([visitID_ym],[isNewUser_ym]=1) у меня здесь ошибки?
count_if нужен только 1 аргумент, то есть так:
COUNT_IF([isNewUser_ym]=1)
а как могу задать считать [visitID_ym] cучетом [isNewUser_ym]=1
if count_if([Статус сделки]="закрыто и нереализовано")=0 then 0 else count_if([Статус сделки]="В РАБОТЕ")/count_if([Статус сделки]="закрыто и нереализовано") end
сделал сортировку, все стало как нужно, но откуда берутся значения в 2003 году, если данных по 2002 году нету?
lag возвращает значение не из предыдущего года, а из предыдущей строки
если у вас
2002
2004
2005
то DataLens 2004 вернет из 2002
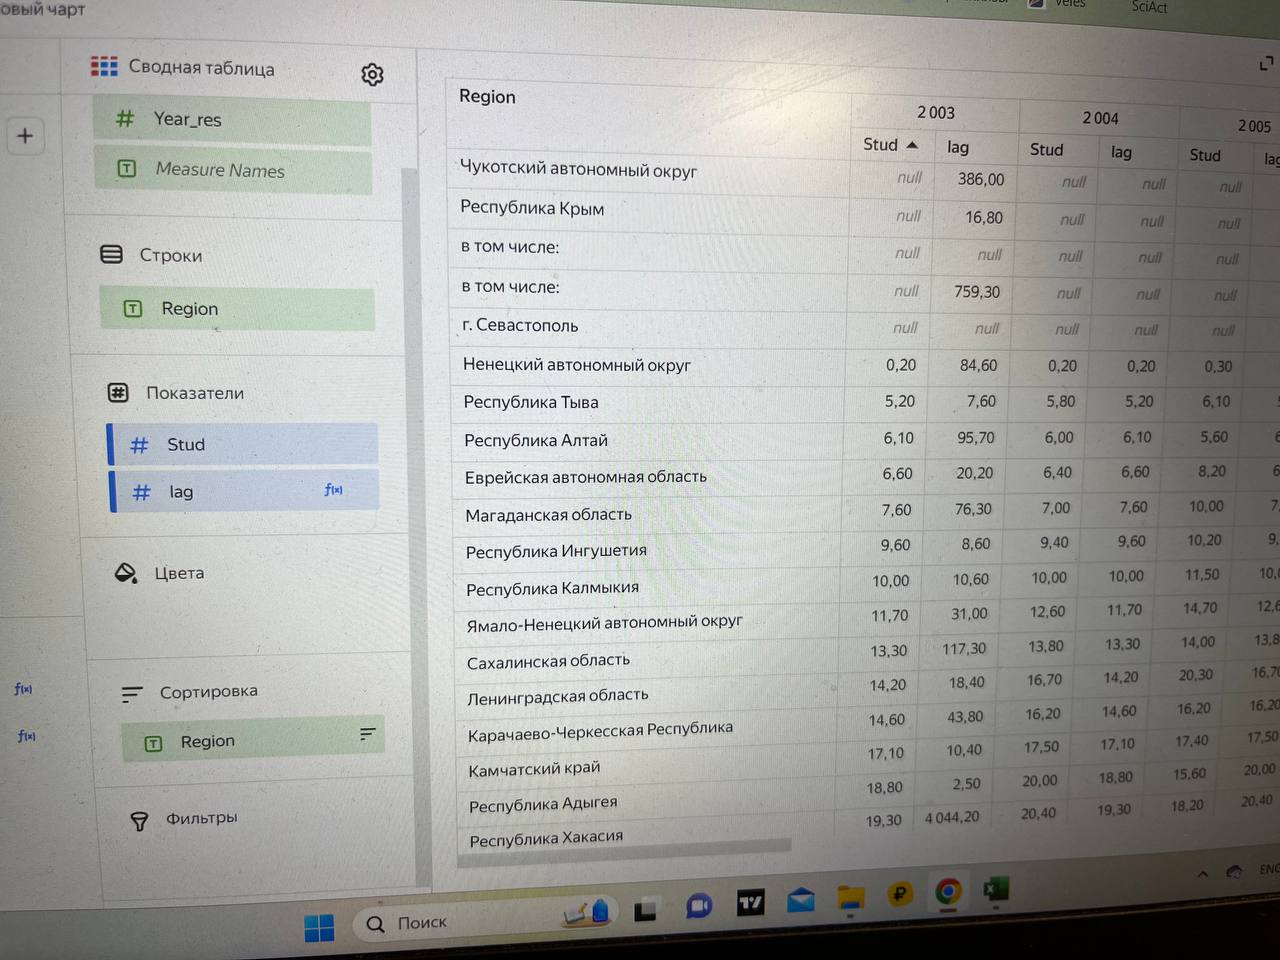
Подскажи какой функцией мужно просуммировать значения по уникальному ID?) Чёт не могу сообразить SUM_IF([revenue], ?[id]) Для Линейного чарта
Может id перенести в цвета, а ревенью просто просуммировать? Еще можно добавить в фильтр, если интересует конкретный.
Подскажи какой функцией мужно просуммировать значения по уникальному ID?) Чёт не могу сообразить SUM_IF([revenue], ?[id])
SUM(ANY([revenue] INCLUDE [id])
как написать формулу через if что если в название текста есть то есть содержит Поло то это Поло если Шапка то это Шапка группа
Есть функция ICONTAINS, можно с ней сочетать IF
Пытаюсь использовать функцию ARRAY к датасету, подключенному к YandexQuery для создания иерархии, как в примере
Но получаю ошибку:
Invalid argument types for function ARRAY; dialect: YQ; types: (INTEGER, INTEGER); the function is only defined for other databases.
Не подскажет кто, в чем проблема?
в том что с query она не работает
А можно ли как-то в формуле обращаться к значению из конкретного столбца и строки? если можно то, где почитать про синтаксис, как это пишется?
В доках описания понятия вычисляемого поля и доступных функций. в реляционной модели не существует конкретной строки
ну например к значению из предыдущей строки можно как-то обратиться?
Нет, у (несуществующих) строк нет порядка. Можно сделать специальные номера в источнике, если надо.
Y = X / SUM(X) всего, Z = X / SUM(X) в рамках таблицы Что нужно поставить, чтобы так считалось? интересует именно как сделать, чтобы не выходила сумма за рамки таблицы?
sum(x total) попробуйте
Так не подскажите, как вытащить порядковый номер дня из даты? Нашел только это, это оно?
Day
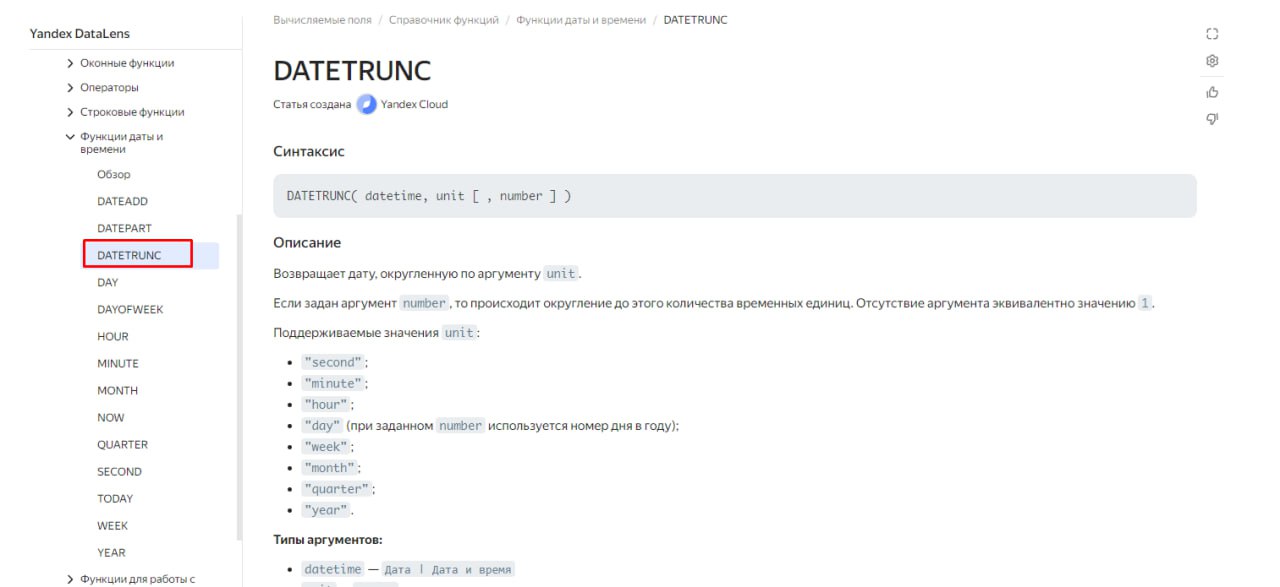
Подскажи какой функцией мужно просуммировать значения по уникальному ID?) Чёт не могу сообразить SUM_IF([revenue], ?[id])
Да, можно создавать фильтры в чартах и селекторы в дашбордах.
если в одном чарте несколько мер, у каждой из которых свой фильтр?
Фильтры работают через and
Допустим 2 меры с фильтрами по разным значениям одного расчетного столбца. Как это можно реализовать?
Путем создания дубликата столбца. Но фильтры работают через and.
Подскажите, что не так ? COUNT([Номер на складе (1)], (IF([Статус склада (1)] = 'да'))
Используйте count_if
COUNT_IF(статус склада=да)

Здравствуйте, почему он данные принимает за строку?
Потому что разделителем разрядов в текстовых файлах должны быть "точка", а не запятая.
В таком случае считается, что формат данных не соответствует числовому и воспринимает его на текст...
Вроде так вероятно, там где пусто, там пустые строки
_1
У меня есть несколько строк с одинаковым order_id и одинаковым order_price в них. Я хочу сгруппировать по order_id, чтобы брать order_price только один раз. Как это можно сделать?
Получилось вот так: AVG(AVG([order_price] INCLUDE [order_id]))
как можно найти нарастающий итог 1 значение суммировалась со следующим и т.д? сейчас стоит формула
Нар_итог =rsum([Доля%]TOTAL)
Там по идее еще одна сумма пропущена Rsum(sum([dolya%]) total)
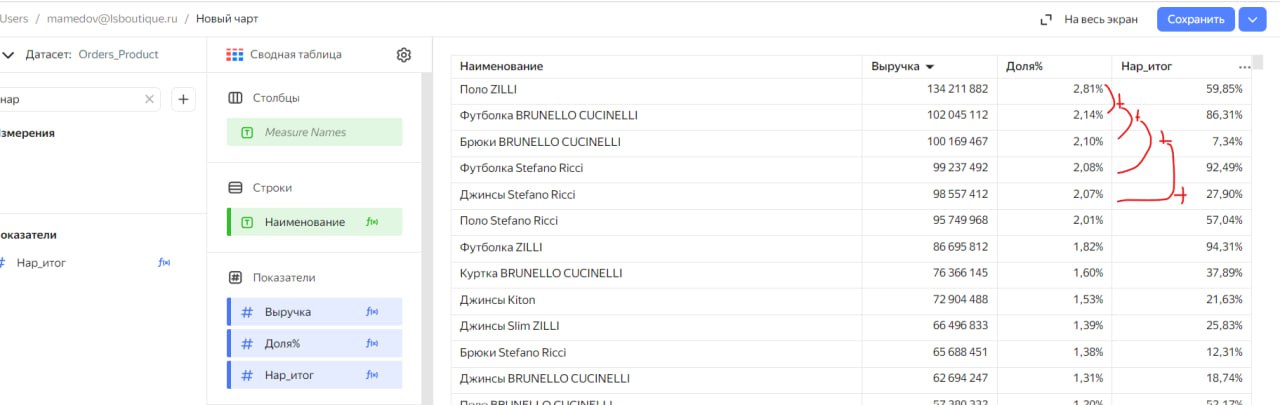
Подскажите, можно ли в поле задать условие "если селектор "активен", тогда..."
Т.е. проверить, выбрано что-то в селекторе на дашборде, если да, то одно действие, если он пустой - другое
нет
Добрый день, подскажите пожалуйста можно ли вывести такое поле
Есть база даных mysql и там есть столбец статус
Я хочу вывести поле которое считает конкретный статус (количество) Как это сделать ?
count_if()
Есть выручка по месяцам. Хочу выводить выручку по прошлому месяцу рядом с выручкой по текущему месяцу, в соседних столбцах.
Создаю поле с формулой AGO(SUM([Выручка]), [Месяц], "month")
Но столбец пустой. Еще интересно что в чарте (таблица) работает. А в самом датасете нет
Смотрите инспектор. У вас там банально могут быть фильтры. Табличный делайте не с нуля, а из линейного чарта.
Ну и в крайнем случае - в поддержку
Есть задача, не могу понять как решить:
Есть вот такой график с группировкой по периоду и группе
В показателях - конверсия
Надо сделать график с группировкой только по периоду и в показателях вывести разницу между конверсиями групп
Подскажите, как рассчитать разницу конверсий
считайте конверсию по АГ и ЦГ разными метриками, т.е. ограничение по АГ/ЦГ встраивайте в сами формулы.
А потом просто считайте разницу этих конверсий
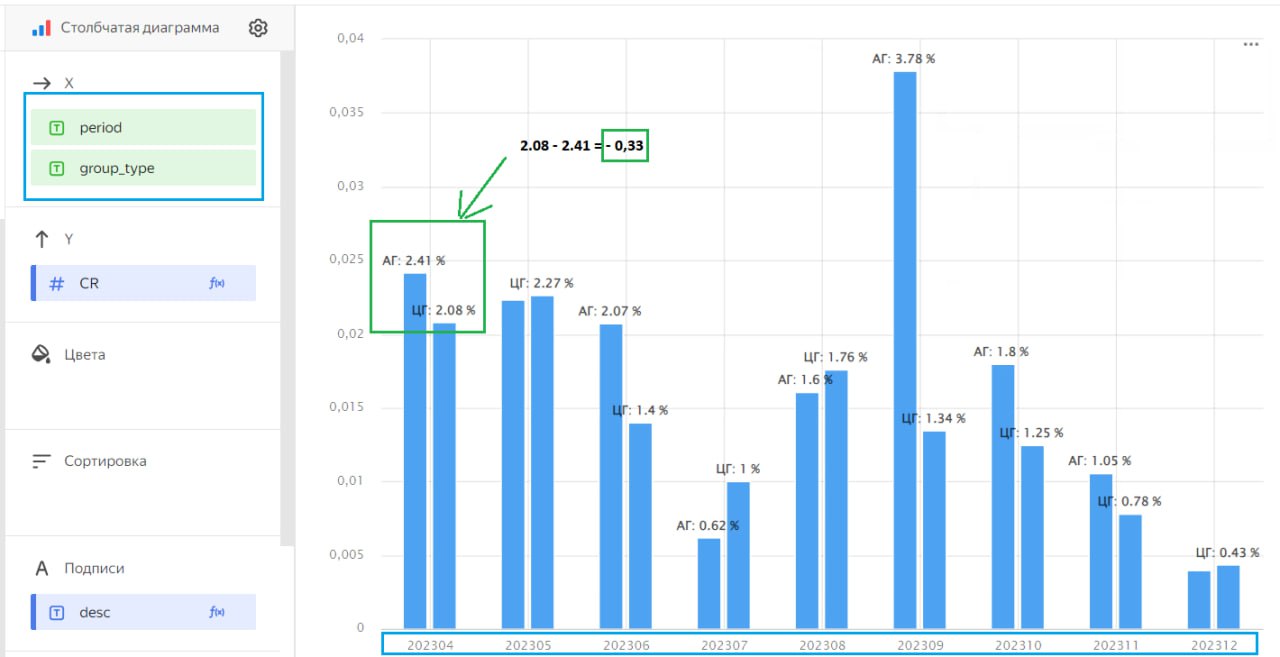
где отрабатывают вычисляемые поля? Влияет ли на скорость загрузки дашборда с вычисляемыми полями мощность устройства с которого просматривается дашборд?
вычисляемые поля становятся элементами фразы SELECT
то есть SELECT a, b, a+b as c, a/c as d ...
соответственно занимается этим всем ваша СУБД
Но, если вы напихаете кучу полей в табличный чарт, то займется ими уже и ДЛ (подготовка элементов веб страницы) и пользовательский комп (отрисовка в браузере)
подскажите пожалуйста, никак не могу разобраться. У меня в YDB даты хранятся как int64. Например 1702639217586. Пробовал функции преобразования, например DATETIME([date]). Не работате. Как в ленсе мне преобразовать их в дату?
сделал так DATETIME([date] / 1000). Странно конечно, если кастовать в запросах при работе с ядб через сдк, проблем не возникало.
Коллеги, подскажите, пожалуйста. В строке значение к примеру Авито, Циан, Яндекс, Дополнительные площадки . Список разделяется запятой и пробелом перед следующим элементом. Как высчитывать количество строк, где содержится, например Циан?
count_if([Значение] like "%Циан%")
Добрый день!
Не подскажете есть ли какой аналог в DL для функции toStartOfMonth()?
datetrunc
А есть какой нибудь аналог countd для суммы?
Нужно посчитать сумму уникальных значений по полю
Группировка
Каким образом можно какое-то агрегированное значение (сумма/квантиль и т.д.) сделать фиксированным, чтобы к нему можно было обращаться просто как к числу с фиксированным значением. Чтобы оно не рассчитывалось по строкам. То-есть сравнивать какие-то другие значения с этим числом конкретным. Надеюсь, что понятно описал ). Например то или иное отклонение от среднего чека...
FIXED
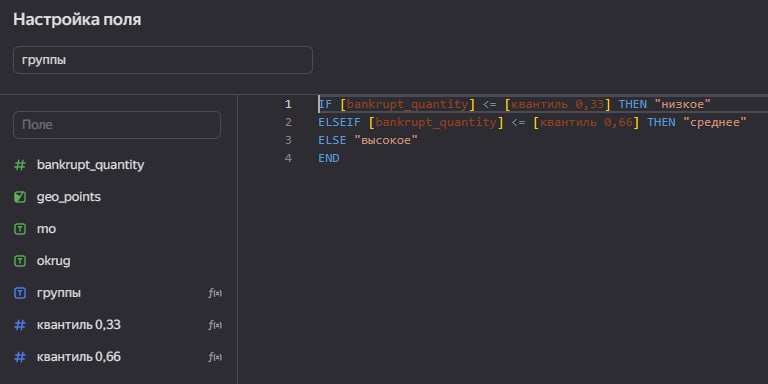
как посчитать долю от общего числа для каждого тарифа? считал через
COUNTD_IF([user_uuid],CONTAINS([slug],'pro'))/COUNTD([user_uuid])
Countd(user uuid) / countd(user uuid fixed)
А использование параметров возможно только с подключением БД?
Нет
Есть столбец в котором есть отрицательные и положительные значения. Как отдельно посчитать положительные и отдельно отрицательные?
Полагаю, Sum_if ну или count_if если надо количество значений
У меня есть показатель, который выводит мне строку. Но эта строка может быть длинной и из-за неё растягивается весь столбец.
Можно ли как-то формулой сделать так, чтобы эта строка переносилась по количеству символов или по пробелам?
Условно говоря, чтобы оно выглядело в дашборде не так
Иванов Иван Иванович
а так:
Иванов
Иван
Иванович
Перенос включается, если ширину столба установить в px Но тогда и все остальные надо ограничивать.
Есть ли формула, чтобы фильтровать строки по кол-ву символов? Это нужно для отсечения ненужных строк (мусорные значения типа "-", "нет" и тому подобное)
Есть функция len, которая возвращает длину строки
Хочу видеть количество клиентов в процентах (сумма 100%), но количество клиентов считается через coundt, формула coundt/coundt total не срабатывает в отличие от sum или count
Разумеется, если один юзер может быть в нескольких категориях да еще и с более, чем одной покупкой
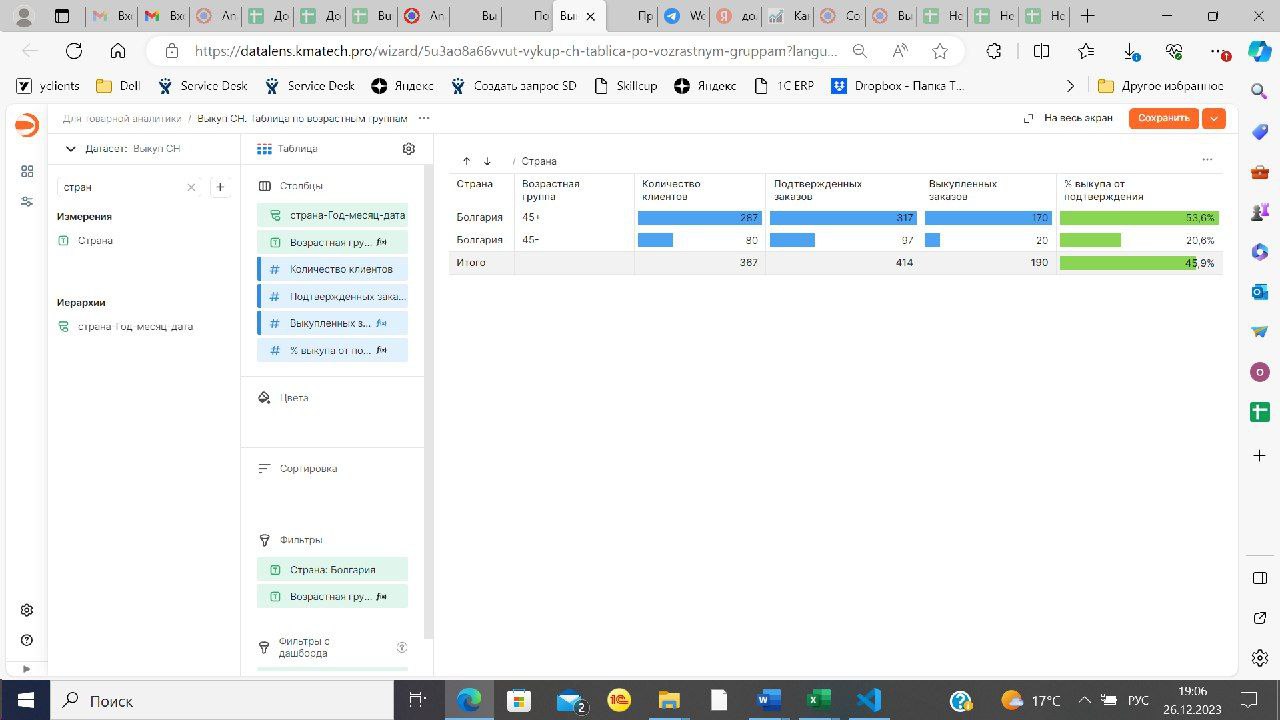
Если чарте два дата сета . Можно формулу написать так чтоб один столб был из одного а другой из второго ?
Нет
давайте подробнее опишу задачу. может сможете направить на путь истинный
у меня есть дата сет со стоком (то что есть в наличии прямо сейчас) по разным атрибутам в разрезе едениц,
во втором дата сете данные с такими же атрибутами, но продажи и добавляется дата продажи.
не нужно взять продажи за последнюю неделю и посмотреть отношение от стока так чтоб пользователь мог в фильтрах менять атрибуты
Витрину в бд надо собрать.
подскажите ещё как создать cr от общего числа пользователей на странице к выполненной цели. Т.е. нужно количество целевых визитов/ количество визитов на какой то странице или нескольких страницах
смотрите что такое total и fixed
Я понимаю что это не эквиваленты, но из-за опыта работы 1 месяц, возможно не додумался сразу задать вопрос правильно: можно ли сделать расчитанную мной строку эквивалентом строки из источника?)
для начала ответьте зачем у вас там LOD
когда вы делаете конкатенацию с ифами она работает в рамках одной строки
LOD работает в рамках группы строк
Как сделать нарастающий итог в DataLens?
Для нарастающего итога обычно используют оконные функции RSUM или MSUM. Важно учитывать уровень агрегации и порядок сортировки, иначе DataLens может вернуть ошибку или некорректный результат.
Почему RSUM с IF и BEFORE FILTER BY может не работать?
Часто причина в порядке вычислений и типах данных. BEFORE FILTER BY лучше применять внутри оконной функции, а для IF явно задавать результат по умолчанию.
Что значит ошибка Inconsistent aggregation among operands?
Ошибка возникает, когда в одной формуле смешаны агрегированные и неагрегированные выражения. Нужно привести части формулы к одному уровню агрегации или вынести расчет в отдельное поле.
Вопрос: Как обработать деление на ноль в вычисляемом поле?
Ответ: Обычно используют IF или CASE: если знаменатель равен нулю, вернуть 0 или NULL, иначе выполнить деление. Конкретная формула зависит от источника данных.
Вопрос: Почему формулы DataLens не работают с Яндекс Метрикой?
Ответ: У прямых подключений к Метрике и AppMetrica есть ограничения по поддерживаемым операциям и типам данных. В сложных случаях расчет лучше перенести в SQL-запрос, представление или подготовленный датасет.
- FAQ по DataLens: подключения к источникам и ролевые модели
- FAQ по DataLens: функции даты, времени, агрегации и оконные функции
- FAQ по DataLens: геоаналитика, сортировка и фильтрация
- FAQ по DataLens: чарты и дашборды