

Потенциал Elasticsearch: глубокое погружение в эффективность поиска
В современном мире цифровых технологий все большее значение приобретают мощные и эффективные возможности поиска. В связи с постоянным ростом объема данных перед организациями встает сложная задача обработки и извлечения ценных сведений из огромных массивов данных. С этой задачей лучше всего справляется Elasticsearch, революционная поисковая и аналитическая система с открытым исходным кодом.
Основные принципы Elasticsearch
По своей сути Elasticsearch предназначен для управления большими объемами данных и обеспечения функций поиска и аналитики в режиме, близком к реальному времени. Эта технология, созданная несколько лет назад компанией Elasticsearch N.V., которая сейчас входит в состав холдинга Elastic, со временем получила широкое признание публики благодаря своей исключительной адаптивности и масштабируемости.
Почему именно Elasticsearch?
1. Высокая масштабируемость
Elasticsearch отличается тем, что обеспечивает быстрый поиск по обширным массивам данных. Его распределенная архитектура облегчает горизонтальное масштабирование, позволяя без проблем интегрировать в кластер дополнительные узлы для поддержания оптимальной производительности по мере увеличения объема данных.
2. Всесторонний полнотекстовый поиск
Основная сила Elasticsearch заключается в его способности выполнять высокоскоростной полнотекстовый поиск. Его универсальный и мощный синтаксис позволяет использовать различные варианты поиска, от простого поиска по ключевым словам до сложных запросов.
3. Аналитика данных в режиме реального времени
В условиях стремительно развивающегося бизнеса способность анализировать данные в режиме реального времени имеет первостепенное значение. Elasticsearch поддерживает индексирование в реальном времени, что позволяет извлекать информацию из данных по мере их поступления.
4. Документы JSON без схем
Elasticsearch хранит данные в документах JSON, что способствует гибкости и отсутствию схем. Это позволяет индексировать данные без предопределенной схемы, облегчая адаптацию к постоянно изменяющимся структурам данных.
5. Многопользовательская система
Elasticsearch поддерживает многопользовательский режим работы. Эта возможность позволяет разным пользователям или приложениям использовать один и тот же кластер Elasticsearch, обеспечивая при этом изоляцию данных.
6. Сильный язык запросов
Elasticsearch Query DSL (Domain-Specific Language) предлагает мощные и выразительные средства для построения запросов. Такая гибкость позволяет пользователям разрабатывать сложные запросы, отвечающие конкретным требованиям, и удовлетворяющие различным сценариям поиска.
7. Визуализация данных с Kibana
Работая в паре с Kibana, надежным инструментом визуализации данных, Elasticsearch образует стек ELK (Elasticsearch, Logstash, Kibana). Все вместе они представляют комплексные решения для поиска, анализа и визуализации данных.

Сферы применения
1. Корпоративный поиск
Elasticsearch силен в реализации функций поиска в корпоративных приложениях, упрощая доступ пользователей к необходимой информации.
2. Анализ журналов и данных о событиях
Благодаря своей способности быстро анализировать и визуализировать данные журналов и событий Elasticsearch отлично справляется с обработкой большого количества журналов в режиме реального времени.
3. Поиск для нужд e-commerce
В сфере электронной коммерции Elasticsearch управляет поисковыми системами, обеспечивая пользователям быстрый и точный результат при навигации по обширным каталогам товаров.
4. Управление информацией и событиями в области безопасности (SIEM)
Являясь основой SIEM-решений, Elasticsearch позволяет организациям тщательно изучать данные безопасности, выявлять аномалии и эффективно реагировать на инциденты, связанные с обеспечением безопасности.
5. Геопространственный поиск
Elasticsearch незаменим в приложениях, требующих функций поиска по местоположению, таких как картографические и геолокационные сервисы.
Ключевые концептыf Elasticsearch
Понимание всех этих ключевых понятий критически важно для эффективного использования Elasticsearch для управления и поиска больших массивов данных в распределенной среде.
Кластер
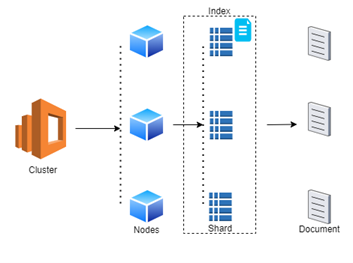
Кластер в Elasticsearch - это набор из одного или нескольких узлов (серверов), которые работают вместе для хранения данных и обеспечения распределенных возможностей поиска. Узлы внутри кластера взаимодействуют и совместно используют данные и рабочую нагрузку.
Узел
Узел - это отдельный экземпляр Elasticsearch, работающий на сервере в кластере. Каждый узел хранит часть данных и вносит вклад в вычислительную мощность и возможности кластера. Узлы можно добавлять или удалять.
Индекс
Индекс - это коллекция документов, имеющих схожую структуру. Это самый высокий уровень организации данных в Elasticsearch. Например, у Вас может быть индекс для хранения журналов, индекс для хранения пользовательских данных и так далее.
Документ
Документ - это базовая единица информации, которую можно хранить в Elasticsearch. Он представлен в формате JSON и содержит одно или несколько полей, каждое из которых имеет свое значение. Документы хранятся в индексах.
Шард
Индексы Elasticsearch делятся на более мелкие единицы, называемые шардами. Шардинг - это процесс разбиения индекса на более мелкие и управляемые части. Каждый шард может быть размещен на отдельном узле, что позволяет выполнять параллельную обработку и повышать производительность.
Реплика
Elasticsearch позволяет создавать реплики шардов для обеспечения отказоустойчивости и повышения производительности поиска. Реплики представляют собой копии основных шардов и могут использоваться в случае выхода из строя узла, содержащего основной шард. Реплики также позволяют выполнять параллельные операции поиска.
Индекс (еще раз)
Индекс - это логическое пространство имен, которое сопоставляется с одним или несколькими первичными хранилищами и нулем или несколькими копиями хранилищ. По сути, это коллекция документов, имеющих схожую структуру. Каждый документ в индексе представляет собой объект JSON с полями и значениями.
Сопоставление
Сопоставление определяет, как хранятся и индексируются документы и их поля. Оно включает в себя информацию о типе данных каждого поля, о том, как оно должно анализироваться для поиска, и другие специфические настройки. Сопоставления имеют решающее значение для определения схемы индекса.
Query DSL (Domain-Specific Language)
Elasticsearch предоставляет мощный и гибкий язык запросов, который позволяет пользователям создавать сложные запросы для получения конкретных данных. Query DSL позволяет пользователям выражать запросы в JSON-подобном синтаксисе, что облегчает составление сложных поисковых запросов.
Анализатор
Анализаторы отвечают за обработку и преобразование текста в процессе индексирования. Они состоят из токенизатора и одного или нескольких фильтров. Токенизаторы разбивают текст на термины, а фильтры изменяют или удаляют эти термины. Анализаторы играют важную роль в выполнении полнотекстового поиска Elasticsearch.
Агрегации
Агрегации в Elasticsearch позволяют пользователям выполнять анализ данных и вычисления в своих наборах данных. Агрегации могут включать такие операции, как сумма, среднее, минимальное, максимальное и другие. Они позволяют получить более глубокое представление о данных, чем просто результаты поиска.
Kibana
Хотя Kibana не является основной концепцией Elasticsearch, она часто используется вместе с Elasticsearch. Kibana - это инструмент визуализации данных с открытым исходным кодом, который позволяет пользователям взаимодействовать с данными Elasticsearch, создавать дашборды и выполнять различные аналитические операции..
Что еще полезно знать о поиске
Elasticsearch - это надежная и многофункциональная платформа, обладающая дополнительными ключевыми концепциями и функциями. Давайте рассмотрим некоторые из них подробнее:
Инвертированный индекс
Для быстрого поиска терминов в документах Elasticsearch использует инвертированный индекс. Этот метод индексирования связывает каждый термин со списком содержащих его документов, что способствует быстрому полнотекстовому поиску.
Токенизация
Разбиение текста на отдельные термины или лексемы называется токенизацией. Elasticsearch использует анализаторы во время индексирования для токенизации и обработки текста, обеспечивая эффективный и точный полнотекстовый поиск.
Динамическое сопоставление
Упрощая процесс индексирования, Elasticsearch автономно определяет и сопоставляет типы данных на основе содержимого документов. Такое динамическое сопоставление оказывается полезным для пользователей, работающих с изменяющимися или динамическими данными.
Массовый API
Улучшая индексирование больших объемов данных, Elasticsearch Bulk API позволяет отправлять пакеты документов одним запросом, заметно повышая производительность индексирования по сравнению с отдельными запросами.
Фильтрация и контекст запроса
Запросы Elasticsearch делятся на контекст фильтра и контекст запроса. Контекст фильтра применяет условия, способствующие получению итогового результата, не влияя на порядок, в то время как контекст запроса влияет и на результат, и на порядок.
Межкластерный поиск
Межкластерный поиск Elasticsearch, позволяющий вести поиск сразу в нескольких кластерах, очень полезен для организаций с распределенными данными, охватывающими различные географические точки или бизнес-подразделения.
Безопасность
Благодаря контролю доступа на основе ролей (RBAC) Elasticsearch позволяет администраторам регулировать доступ к индексам и функциям, обеспечивая безопасность конфиденциальных данных и их целостность.
Моментальный снимок и восстановление после сбоев
Функции моментального снимка и восстановления Elasticsearch позволяют пользователям создавать снимки индексов в определенные моменты времени, что играет важную роль в резервном копировании, восстановлении и миграции данных из кластера в кластер.
Интеграция ML
Благодаря интеграции функций машинного обучения Elasticsearch может обнаруживать аномалии, предсказывать тенденции и предлагать глубокое понимание поведения данных, что особенно полезно в сценариях анализа журналов и обнаружения аномалий.
Оценка релевантности поиска
Elasticsearch рассчитывает оценку релевантности для каждого документа на основе запроса и различных факторов. Этот механизм оценки, учитывающий такие факторы, как частота терминов и популярность документов, гарантирует, что результаты поиска будут ранжированы по релевантности.
Percolator
Функция Percolator позволяет пользователям регистрировать запросы и определять, какие из них соответствуют определенному документу. Идеально подходит для сценариев, ориентированных на точное определение документов, соответствующих заранее заданным запросам, и представляет собой альтернативу традиционным методам поиска.
Индексы Elasticsearch
Схема
Термин «схема» используется не так, как в традиционных реляционных базах данных. Вместо этого Elasticsearch использует отображения для определения того, как индексируются и хранятся поля в документах. Сопоставление - это схема организации и поиска данных в индексе.
Вот пример того, как с помощью Curl можно легко определить простое отображение для индекса «race_cars»:
curl -X PUT "http://localhost:9200/race_cars" -H 'Content-Type: application/json' -d '{
  "mappings": {
    "properties": {
      "car_name": {
        "type": "text"
      },
      "manufacturer": {
        "type": "text"
      },
      "top_speed": {
        "type": "integer",
        "fields": {
          "keyword": {
            "type": "keyword"
          },
          "analyzed_speed": {
            "type": "text",
            "analyzer": "standard"
          }
        }
      }
    }
  }
}'
- race_cars - имя индекса.
- Свойства определяют поля в документах.
- Каждое поле, например, car_name, manufacturerи top_speed, определяется типом данных. Elasticsearch поддерживает различные типы данных, включая text для полнотекстового поиска, integer для целых чисел и другие.
- Мы добавили подполе analyzed_speed типа text со стандартным анализатором. Это подполе можно использовать для полнотекстового поиска по полю top_speed.
- Кроме того, в Elasticsearch есть подполе типа keyword. Это обычная практика - иметь неанализируемое подполе ключевого слова для точного соответствия.
Это сопоставление гарантирует, что Elasticsearch поймет, как индексировать и запрашивать каждое поле. Например, указание «type»: «text» для полей car_name и manufacturer означает, что эти поля будут рассматриваться как доступные для полнотекстового поиска.
Сопоставления также могут включать дополнительные параметры и конфигурации, такие как анализаторы для текстовых полей, которые управляют тем, как текст токенизируется и индексируется.
Важно отметить, что Elasticsearch может автоматически генерировать сопоставления на основе полученных данных. Однако предоставление явных сопоставлений позволяет более точно контролировать процесс индексирования и обеспечивает согласованность интерпретации данных.
Передача данных в Elasticsearch с помощью Curl
Чтобы проиндексировать данные в Elasticsearch с помощью Curl или RESTful-клиента, обычно используется HTTP-запрос PUT или POST с нужной конечной точкой и полезной нагрузкой в формате JSON. Вот простой пример использования Curl для индексации документа в индекс с именем «race_cars».
curl -X PUT "http://localhost:9200/race_cars/_doc/1" -H 'Content-Type: application/json' -d '{
  "car_name": "Ferrari",
  "manufacturer": "Ferrari S.p.A.",
  "top_speed": 211
}'

curl -X PUT "http://localhost:9200/race_cars/_doc/2" -H 'Content-Type: application/json' -d '{
  "car_name": "Porsche",
  "manufacturer": "Porsche AG",
  "top_speed": 205
}'

curl -X PUT "http://localhost:9200/race_cars/_doc/3" -H 'Content-Type: application/json' -d '{
  "car_name": "McLaren",
  "manufacturer": "McLaren Automotive",
  "top_speed": 218
}'
- http://localhost:9200 - URL-адрес Elasticsearch по умолчанию.
- race_cars - имя индекса.
- - _doc/1 указывает тип и идентификатор документа.
- Полезная нагрузка JSON содержит данные документа.
Поиск данных в Elasticsearch
Для поиска данных в Elasticsearch используется HTTP GET-запрос к конечной точке поиска. Вот базовый пример для поиска всех документов в индексе «race_cars». Вы можете настроить запрос с помощью параметров для фильтрации, сортировки и агрегирования данных.
curl -X GET "http://localhost:9200/race_cars/_search"
Поиск данных
Токенизация - важнейший аспект полнотекстового поиска в Elasticsearch. Она предполагает разбиение текста на отдельные термины, которые затем индексируются. Рассмотрим пример, в котором мы хотим найти гоночные автомобили по их атрибутам, таким как «car_name» и «manufacturer».
curl -X GET "http://localhost:9200/race_cars/_search" -H 'Content-Type: application/json' -d '{
  "query": {
    "match": {
      "car_name": "Ferrari"
    }
  }
}'
Для того, чтобы найти документы, в которых поле «car_name» содержит «Ferrari» мы используем простой запрос. Процесс токенизации Elasticsearch гарантирует, что поиск не чувствителен к регистру, и может адаптироваться к вариациям термина.
Теперь вы можете искать гоночные автомобили по диапазону скоростей. Например, чтобы найти автомобили с максимальной скоростью от 200 до 210 км/ч.
curl -X GET "http://localhost:9200/race_cars/_search" -H 'Content-Type: application/json' -d '{
  "query": {
    "range": {
      "top_speed": {
        "gte": 200,
        "lte": 210
      }
    }
  }
}'
В приведенном выше примере для фильтрации документов по полю top_speed в пределах указанного диапазона используется соответствующий запрос. Параметр gte означает «больше или равно», а lte - «меньше или равно». Настройте эти значения в соответствии с тем, что Вы хотите получить на выходе.
Анализаторы в Elasticsearch
Анализаторы являются ключевыми компонентами Elasticsearch, играющими важную роль в токенизации и обработке текста на этапах индексирования и поиска. Elasticsearch предлагает множество встроенных анализаторов, каждый из которых предназначен для решения конкретных задач. Вот некоторые часто используемые анализаторы:
Стандартный анализатор
Используется по умолчанию и применяет алгоритм сегментации текста Unicode для разбиения текста на термины.
Анализатор свободного пространства
Сегментирует текст на термины при появлении пробельных символов. Этот анализатор полезен, когда важно сохранить исходные структурные элементы текста.
Простой анализатор
Разделяя текст на термины, основанные на небуквенных символах, этот анализатор также преобразует текст в строчные буквы.
Английский анализатор
Специально разработан для текстов на английском языке.
Анализатор ключевых слов
Этот анализатор индексирует все содержимое поля как один термин, что оказывается полезным в сценариях, требующих точного соответствия.
Пользовательский анализатор
Elasticsearch позволяет пользователям определять собственные анализаторы, что дает им возможность задавать токенизаторы и фильтры в соответствии с конкретными требованиями. Такая гибкость обеспечивает адаптацию к уникальным условиям использования.
Запросы и фильтры в Elasticsearch
Elasticsearch предоставляет богатый набор запросов и фильтров для получения и фильтрации данных. Вот несколько распространенных запросов, которые мы используем:
Запрос на сопоставление
Поиск определенного текста в одном или нескольких полях. Анализирует текст запроса и содержимое поля и находит соответствующие запросу документы.
{
  "query": {
    "match": {
      "field_name": "search_text"
    }
  }
}
Запрос на термины
Сопоставляет документы, содержащие определенный термин, указанный в поле поиска. Чувствителен к регистру.
{
  "query": {
    "term": {
      "field_name": "exact_term"
    }
  }
}
Запрос на ранжирование
Фильтрует документы на основе заданного диапазона значений числового поля или поля даты.
{
  "query": {
    "range": {
      "numeric_field": {
        "gte": 10,
        "lte": 100
      }
    }
  }
}
Bool Query
Комбинирует несколько запросов, ориентируясь на логические операции (AND, OR, NOT).
{
  "query": {
    "bool": {
      "must": [
        { "match": { "field1": "value1" }},
        { "range": { "field2": { "gte": 10 }}}
      ],
      "must_not": [
        { "term": { "field3": "value3" }}
      ]
    }
  }
}
Wildcard Query
Позволяет подбирать термины на основе подстановочных знаков. Полезно для частичного сопоставления.
{
  "query": {
    "wildcard": {
      "field_name": "prefix*"
    }
  }
}
Нечеткий запрос
Сопоставляет похожие термины. Полезно для обработки опечаток и незначительных вариаций.
{
  "query": {
    "fuzzy": {
      "field_name": {
        "value": "similar_text",
        "fuzziness": 2
      }
    }
  }
}
Агрегации
Агрегации в Elasticsearch - это мощная функция, которая позволяет выполнять анализ данных и вычисления в наборе данных. Их можно сравнить с предложениями SQL GROUP BY, но с гораздо большей гибкостью и возможностями. Агрегации помогают получить значимые сведения из ваших данных путем обобщения, группировки и вычисления различных показателей.
Агрегация терминов
Агрегация терминов используется для группировки данных на основе значений определенного поля. Это сродни предложению GROUP BY в SQL. Ниже будет выведено 10 лучших названий автомобилей и количество документов для каждого из них.
{
  "aggs": {
    "car_names": {
      "terms": {
        "field": "car_name.keyword",
        "size": 10
      }
    }
  }
}
Агрегация max
Агрегация max используется для поиска максимального значения числового поля в группе. В нашем случае возвращается максимальная скорость.
{
  "aggs": {
    "max_speed": {
      "max": {
        "field": "top_speed"
      }
    }
  }
}
Агрегация min
Агрегация min похожа на max, но позволяет найти минимальное значение в группе. В этом случае будет возвращена минимальная скорость.
{
  "aggs": {
    "min_speed": {
      "min": {
        "field": "top_speed"
      }
    }
  }
}
Aгрегация аvg
Агрегация avg вычисляет среднее значение числового поля в группе. Это вернет среднее значение максимальной скорости.
{
  "aggs": {
    "avg_speed": {
      "avg": {
        "field": "top_speed"
      }
    }
  }
}
Агрегация sum
Агрегация sum вычисляет сумму числовых значений в группе. Это вернет общую сумму максимальных скоростей по всем документам.
{
  "aggs": {
    "total_speed": {
      "sum": {
        "field": "top_speed"
      }
    }
  }
}
Вложенная агрегация
Агрегации могут быть вложенными. В этом случае они подходят для выполнения многоуровневого анализа. Например, Вы можете использовать агрегацию терминов для группировки по одному полю, а затем применить другую агрегацию в каждой группе. Это позволит получить среднюю скорость для каждого имени автомобиля.
{
  "aggs": {
    "car_names": {
      "terms": {
        "field": "car_name.keyword"
      },
      "aggs": {
        "avg_speed": {
          "avg": {
            "field": "top_speed"
          }
        }
      }
    }
  }
}
Найдем автомобиль с максимальной скоростью
Вы можете использовать агрегацию Max непосредственно по полю «top_speed для того», чтобы найти автомобиль с наибольшей максимальной скоростью. Мы используем агрегацию терминов по полю «car_name.keyword» для группировки по названиям автомобилей.
- Параметр order гарантирует, что результаты будут упорядочены по максимальной скорости в порядке убывания.
- Параметр size ограничивает результаты только одним автомобилем, который имеет наибольшую максимальную скорость.
- В рамках агрегации мы используем агрегацию max для поля «top_speed» для того, чтобы найти максимальную скорость.
{
  "aggs": {
    "max_speed_car": {
      "terms": {
        "field": "car_name.keyword",
        "order": {
          "top_speed": "desc"
        },
        "size": 1
      },
      "aggs": {
        "top_speed": {
          "max": {
            "field": "top_speed"
          }
        }
      }
    }
  }
}
В результате вы получите автомобиль с наибольшей максимальной скоростью на основе данных Вашего индекса. Этот подход предполагает, что максимальная скорость является определяющим фактором для определения «самого быстрого» автомобиля. Если у Вас есть дополнительные критерии или контекст, скорректируйте запрос.
API_cat
Чтобы проверить состояние кластера и узлов Elasticsearch, Вы можете использовать конечные точки API _cat. API _cat предоставляет краткое представление информации о кластере и узлах.
Состояние кластера
Нижеприведенная команда извлекает информацию о состоянии кластера, включая имя кластера, статус, количество узлов, количество первичных и реплицированных шардов, а также другие важные сведения. Параметр ?v необязателен, но добавляет заголовки столбцов для достижения лучшей читабельности.
curl -X GET "http://localhost:9200/_cat/health?v"
Состояние узла
Эта команда получает информацию обо всех узлах кластера, включая имена узлов, их роли (мастер, данные и т. д.), IP-адреса, использование кучи и т. д. Параметр ?v необязателен, но добавляет заголовки столбцов для достижения лучшей читабельности.
Чтобы получить подробную информацию о конкретном узле, мы можем использовать:
curl -X GET "http://localhost:9200/_cat/nodes/node_id?v"
Замените node_id на актуальный ID узла, который Вас интересует.
Объяснение статуса состояния
Когда Вы проверяете состояние кластера, Вы видите его статус (например, «зеленый», «желтый» или «красный»). Значение статусов:
- Зеленый: Все первичные и копирующие шарды активны.
- Желтый: Все первичные шарды активны, но некоторые или все шарды-реплики не выделены.
- Красный: Некоторые или все первичные шарды не активны.
Результаты проверки состояния включают информацию о состоянии кластера, его статусе, количестве узлов, количестве шардов и другие важные данные.
epoch      timestamp cluster       status node.total node.data shards pri relo init unassign pending_tasks max_task_wait_time active_shards_percent
1647369991 15:46:31  elasticsearch green           1         1      2   1    0    0        0             0                  -                100.0%
Заключение
Elasticsearch - это универсальный и мощный инструмент для поиска и аналитики, подходящий для самых разных приложений.
Понимание ключевых концепций, эффективное индексирование данных и использование таких функций, как агрегация, способствуют использованию возможностей Elasticsearch по максимуму.
Регулярный мониторинг состояния кластера и узлов очень важен для поддержания стабильной и работы Elasticsearch.
Гибкость и масштабируемость Elasticsearch делают его незаменимым инструментом в области поиска и анализа данных, позволяя разработчикам и организациям извлекать из своих данных критически важные сведения.


