

Интеграция Apache Hudi и Apache Flink для новых Data Lake
Apache Hudi - это фреймворк озера данных с открытым исходным кодом, разработанный компанией Uber. В январе 2019 года он прошел апробацию в Apache Incubator, а в мае 2020 года стал проектом высшего уровня Apache. В настоящее время это один из самых популярных фреймворков, разработанных специально для озер данных.
1. Причины разделения
С момента своего появления и по сегодняшний день Hudi использует Spark в качестве движка для обработки данных. Если пользователи хотят использовать Hudi в качестве фреймворка для озер данных, они должны внедрить Spark в технологические стеки своих платформ. Несколько лет назад было принято использовать Spark в качестве движка для обработки больших данных. Он может выполнять пакетную обработку, стимулировать микропотоковую обработку и объединять потоковую и пакетную обработку для решения широкого спектра задач. Однако с развитием технологии больших данных в последние годы в обиход пользователей постепенно вошел Flink, который также является движком для обработки Big Data. Он занял определенную нишу на рынке вычислительных движков, поэтому монополии в движках для обработки больших данных больше не существует. В сообществах, на форумах и других платформах технологий обработки Big Data появились и быстро распространились требования о поддержке Flink в Hudi. Поэтому очень важно обеспечить поддержку Flink в Hudi, а отвязка Hudi от Spark является необходимым условием для интеграции Flink.
В области больших данных все зрелые и жизнеспособные фреймворки отличаются элегантным дизайном. Все они могут быть интегрированы с другими фреймворками и опираются на возможности друг друга. Поэтому отделение Hudi от Spark - это способ превратить Hudi в независимый от движка фреймворк озера данных. Несомненно, это открывает больше возможностей для интеграции Hudi с другими компонентами, позволяя Hudi быстрее интегрироваться в экосистему Big Data.
2. Сложности разделения
Использование Spark API в Hudi так же распространено, как и использование List в повседневной разработке. Spark RDD используется в качестве основной структуры данных, будь то чтение данных из источника или запись данных в таблицу. Даже самые обычные инструментальные классы могут быть реализованы через Spark API. Hudi - это фреймворк озера данных общего назначения, реализованный на Spark.
Flink - это основной движок, интегрируемый после разделения. Основная абстракция Flink сильно отличается от абстракции Spark. Spark считает, что данные ограничены, и его основной абстракцией является ограниченный набор данных. По сути, Flink рассматривает данные как сам поток. Основная абстракция DataStream выполняет над данными различные операции. Кроме того, Hudi необходимо одновременно оперировать несколькими устойчивыми распределенными наборами данных (RDD) в разных точках. Также необходимо объединять результаты обработки одного RDD с другим RDD для совместной обработки. Различия в абстракциях и повторное использование промежуточных результатов в процессе реализации затрудняют использование Hudi унифицированного API для развязывания абстракций. Таким образом, сложно одновременно работать и с RDD, и с DataStream.
3. Принципы разделения
Теоретически, Hudi использует Spark в качестве вычислительного движка для распределенных вычислений Spark и богатых возможностей операторов RDD. Помимо возможности распределенных вычислений, RDD в Hudi является скорее абстракцией структуры данных и по сути представляет собой ограниченный набор данных. Поэтому можно заменить RDD на List, но производительность в этом случае может снизиться. Мы можем сохранить настройку ограниченного набора данных в качестве базовой операционной единицы, чтобы обеспечить производительность и стабильность Hudi Spark. API для основной операции в Hudi не изменился. RDD извлекается в качестве общего, и реализация движка Spark по-прежнему использует RDD. Другие движки используют List или другие наборы данных.
Принципы разделения:
1) Унификация дженериков: JavaRDD, JavaRDD и JavaRDD, используемые в Spark API, заменены унифицированными дженериками, такими как I, K и O.
2) Удалить Spark: Все API на уровне абстракции не должны иметь отношения к Spark. Если речь идет о конкретных операциях, которые сложно реализовать на уровне абстракции, перепишите их в виде абстрактных методов и введите подклассы Spark.
Например, метод JavaSparkContext#map() используется во многих местах в Hudi. Удаление Spark означает, что JavaSparkContext должен быть скрыт. Для решения этой проблемы мы ввели метод HoodieEngineContext#map(). Этот метод скрывает детали реализации объекта map для удаления Spark в слое абстракции.
3) Слой абстракции минимизирует изменения для того, чтобы обеспечить производительность Hudi.
4) Замените JavaSparkContext на абстрактный класс HoodieEngineContext для обеспечения контекста среды выполнения.

4. Интеграционные проекты Flink
По сути, операции записи в Hudi - это пакетная обработка. Непрерывный режим работы DeltaStreamer реализуется с помощью циклической пакетной обработки. Чтобы использовать унифицированные API, Hudi накапливает пакет данных во время интеграции с Flink, обрабатывает их и отправляет. В данном случае для накопления данных для Flink используется List.
Пакетный сбор реализован с помощью временного окна. Однако когда в окне нет входных данных, то нет и выходных. Таким образом, Sink трудно определить, была ли обработана одна и та же партия данных. Благодаря механизму контрольных точек Flink для накопления партий, данные между каждыми двумя барьерами являются партией. Когда в подзадаче нет данных, она использует данные имитатора результата. Таким образом, после того как каждая подзадача получит данные о результате, пакет данных можно считать обработанным в Sink. Затем можно выполнить операцию фиксации.
Направленный ациклический граф (DAG) приведен ниже:
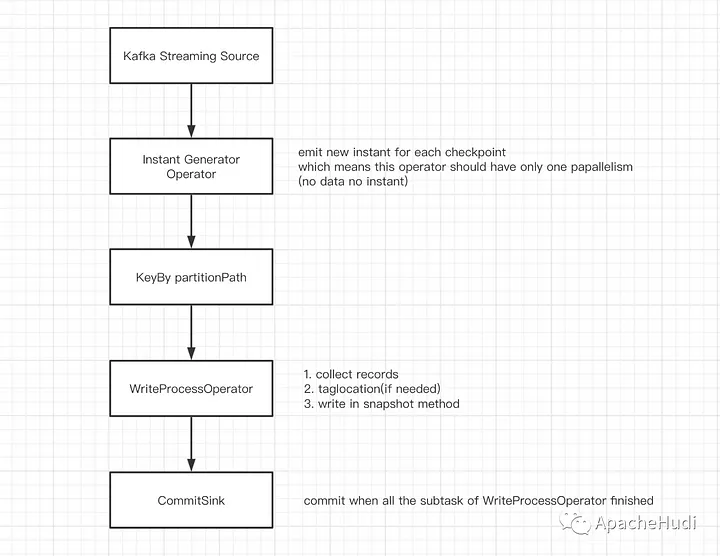
- Источник получает данные Kafka и преобразует их в данные List.
- InstantGeneratorOperator генерирует глобально уникальный инстанс. Если последний момент не завершен или в текущем пакете нет данных, новый инстанс не создается.
- KeyBy partitionPath разделяет разделы на основе partitionPath так, чтобы избежать записи в один и тот же раздел несколькими подзадачами.
- WriteProcessOperator выполняет операции записи. Если в текущем разделе нет данных, он отправляет пустые данные результатов в нисходящий поток.
- CommitSink получает результаты вычислений от вышестоящих задач. После получения результатов параллельных вычислений он считает, что все вышестоящие подзадачи завершены, и выполняет операцию фиксации.
Примечание: InstantGeneratorOperator и WriteProcessOperator - это пользовательские операторы Flink. Первый проверяет статус последнего инстанса в случае блокировки внутреннего процесса (поэтому существует только один инстанс в состоянии «inflight» или «requested»). WriteProcessOperator выполняет операции записи, которые запускаются в контрольной точке.
5. Примеры
1) HoodieTable
/**
  * Abstract implementation of a HoodieTable.  *  * @param <T> Sub type of HoodieRecordPayload  * @param <I> Type of inputs  * @param <K> Type of keys  * @param <O> Type of outputs  */ public abstract class HoodieTable<T extends HoodieRecordPayload, I, K, O> implements Serializable {  protected final HoodieWriteConfig config;   protected final HoodieTableMetaClient metaClient;   protected final HoodieIndex<T, I, K, O> index;  public abstract HoodieWriteMetadata<O> upsert(HoodieEngineContext context, String instantTime,       I records);  public abstract HoodieWriteMetadata<O> insert(HoodieEngineContext context, String instantTime,       I records);  public abstract HoodieWriteMetadata<O> bulkInsert(HoodieEngineContext context, String instantTime,       I records, Option<BulkInsertPartitioner<I>> bulkInsertPartitioner);  ...... }
HoodieTable - это одна из основных абстракций Hudi, которая определяет операции insert, upsert, bulkInsert, поддерживаемые таблицей. В качестве примера рассмотрим операцию upsert. Входные данные изменяются с JavaRDD inputRdds на I. Во время выполнения JavaSparkContext jsc заменяется на HoodieEngineContext.
Из аннотаций класса видно, что T, I, K и O представляют тип данных загрузки, тип входных данных, тип первичного ключа и тип выходных данных операций Hudi соответственно. Эти дженерики будут работать через весь слой абстракции.
2) HoodieEngineContext
/**
  * Base class contains the context information needed by the engine at runtime. It will be extended by different  * engine implementation if needed.  */ public abstract class HoodieEngineContext {  public abstract <I, O> List<O> map(List<I> data, SerializableFunction<I, O> func, int parallelism);  public abstract <I, O> List<O> flatMap(List<I> data, SerializableFunction<I, Stream<O>> func, int parallelism);  public abstract <I> void foreach(List<I> data, SerializableConsumer<I> consumer, int parallelism);  ...... }
HoodieEngineContext выступает в роли JavaSparkContext, который предоставляет всю информацию, которую может предоставить JavaSparkContext, но также инкапсулирует методы map, flatMap, foreach и многие другие. Он также скрывает подробные реализации многих методов, включая JavaSparkContext#map(), JavaSparkContext#flatMap() и JavaSparkContext#foreach().
Для примера возьмем метод map. Ниже приведена реализация данного метода для HoodieSparkEngineContext в Spark:
@Override
   public <I, O> List<O> map(List<I> data, SerializableFunction<I, O> func, int parallelism) {     return javaSparkContext.parallelize(data, parallelism).map(func::apply).collect();   }
В движке, управляющем List, различные методы должны принимать во внимание вопросы безопасности потоков и использовать parallel() с осторожностью. Возможная реализация приведена ниже:
@Override
   public <I, O> List<O> map(List<I> data, SerializableFunction<I, O> func, int parallelism) {     return data.stream().parallel().map(func::apply).collect(Collectors.toList());   }
Примечание: Исключения, возникающие в функции map, могут быть решены путем упаковки функции SerializableFunction func.
Это краткое введение в SerializableFunction:
@FunctionalInterface
 public interface SerializableFunction<I, O> extends Serializable {   O apply(I v1) throws Exception; }
Этот метод является вариантом метода java.util.function.Function. В отличие от java.util.function.Function, SerializableFunction может быть сериализована и бросает исключения. Функция введена потому, что входные параметры, которые может получить функция JavaSparkContext#map(), должны быть сериализуемыми.
6. Статус-кво и последующие действия
6.1 Сроки выполнения работ
В апреле 2020 года Ян Хуа (@vinoyang) и Ван Сянху (@wangxianghu) из T3 Travel разработали и доработали схему развязки вместе с Ли Шаофэном (@leesf) из Alibaba и другими партнерами.
В апреле 2020 года Ван Сяньху завершил внутреннее внедрение кодирования и провел предварительную проверку, придя к выводу, что данная схема осуществима.
В июле 2020 года Ван Сяньху представил сообществу HUDI-1089 проектную реализацию и версию Spark, основанную на новой абстракции.
26 сентября 2020 года SF Technology опубликовала протокол встречи Apache Flink в Шэньчжэне, посвященной обсуждению расширенной версии внутренних ветвей T3. Благодаря этому событию SF стала первым предприятием в отрасли, использующим Flink для записи данных в Hudi в режиме онлайн.
2 октября 2020 года HUDI-1089 был объединен с основной веткой Hudi, что ознаменовало завершение разделения Hudi-Spark.
6.2 Планы на будущее
1) Продвижение интеграции Hudi и Flink
Мы хотим как можно скорее представить сообществу интеграцию Flink и Hudi. Первоначально могут поддерживаться только источники данных Kafka.
2) Оптимизация производительности
Потенциальные проблемы производительности Flink не учитывались в процессе разделения для того, чтобы обеспечить стабильность и производительность Hudi-Spark.
3) Разработка пакетов сторонних производителей для Flink-Connector-Hudi
Привяжите Hudi-Flink к пакету стороннего разработчика. Пользователи могут читать любые источники данных в приложении Flink, кодируя и используя этот сторонний пакет для записи данных в Hudi.


