

Кейс оптимизации запросов в Greenplum: как мы ускорили расчёт количества чеков в 9 раз
В этой статье мы разберём реальный кейс оптимизации ресурсоёмкого запроса, с которым столкнулись в рамках проекта для одного крупного ритейлера. Вы узнаете о практических методах ускорения запросов, типичных ошибках и рисках, а также о том, как правильно подходить к оптимизации в MPP-системах.
Greenplum — это распределённая СУБД с массово-параллельной архитектурой (MPP), построенная на основе PostgreSQL. Она идеально подходит для хранения и обработки больших объёмов данных, но требует глубокого понимания её архитектуры для эффективной работы. Одна из самых ресурсоёмких операций в таких системах — это вычисление COUNT(DISTINCT), особенно при работе с большими таблицами и сложными группировками.
Наш клиент столкнулся с необходимостью рассчитывать количество чеков в разрезе групп магазинов и товаров за определённый период. Исходные данные хранились в распределённой таблице fct_receipts объёмом в терабайты. Таблица была партицирована по дате и распределена по полю receipt_id.
fct_receipts (receipt_id-идентификатор чека, receipt_dttm-дата+время чека, calendar_dk-числовое представление даты чека например20240101, store_id-идентификатор магазина, plu_id-идентификатор товара)
Были поставлены следующие задачи:
- Рассчитать количество чеков по группам магазинов и товаров.
- Обеспечить возможность агрегации на разных уровнях (например, только по магазинам).
- Уложиться в приемлемое время выполнения (запрос выполнялся около минуты, что было признано недостаточным для интерактивной аналитики).

Исходный запрос выглядел следующим образом:
INSERT INTOreceipts_cnt_baskets_draftSELECTsest.store_group_id, COALESCE(sepl.plu_group_id,0::INT4)ASplu_group_id,COUNT(DISTINCTfcre.receipt_id)AScnt_basketsFROMfct_receiptsASfcreINNERJOINselected_storesASsestUSING (store_id)INNERJOINselected_pluASseplUSING (plu_id)WHERE 1 = 1 ANDfcre.receipt_dttm >= '2023-08-01 00:00:00'::TIMESTAMP ANDfcre.receipt_dttm < '2023-09-01 00:00:00'::TIMESTAMP GROUP BYGROUPING SETS ((store_group_id, plu_group_id), (store_group_id ));
Ключевая проблема заключалась в перекосе данных и неэффективном использовании кластера.
Анализ плана запроса показал, что основная проблема заключалась в перераспределении данных (Redistribute Motion) по ключу группировки (store_group_id, plu_group_id). Из-за неравномерного распределения групп магазинов и товаров (например, одна группа включала 22 287 магазинов, а другая — всего 14) возникал значительный перекос данных. На один сегмент кластера приходилось в 9 раз больше данных, чем на другие, что приводило к замедлению выполнения запроса.
План запроса, построенный оптимизатором GPORCA:
EXPLAIN ANALYZEINSERT INTOreceipts_cnt_basketsSELECTsest.store_group_id, COALESCE(sepl.plu_group_id,0::INT4)ASplu_group_id,COUNT(DISTINCTfcre.receipt_id)AScnt_baskets-- 1 Часть запроса FROMfct_receiptsASfcreINNERJOINselected_storesASsestUSING (store_id)INNERJOINselected_pluASseplUSING (plu_id)WHERE 1 = 1 ANDfcre.receipt_dttm >= '2023-08-01 00:00:00'::TIMESTAMP ANDfcre.receipt_dttm < '2023-09-01 00:00:00'::TIMESTAMP -- 2 часть запроса GROUP BYGROUPING SETS ((store_group_id, plu_group_id), (store_group_id ));
Упрощенный план запроса:
1Частьплана(Получениеданных)Итого:Данныеподготовленыилежатнакаждомсегментепоключураспределенияfct_receiptsShared Scan (share slice:id4:0)3)Соединениястаблицами-параметрами(JOINлокальный)->HashJoinHash Cond: (fct_receipts.plu_id =selected_plu.plu_id)->HashJoinHash Cond: (fct_receipts.store_id =selected_stores.store_id)2)Выборка1партициисогласноусловиюподатам->Partition Selector for fct_receiptsPartitions selected:1 1)Хэшированиетаблицпараметров->Hash->Seq Scanonselected_stores->Hash->Seq Scanonselected_plu
2Часть плана-расчетCOUNT(DISTINCTreceipt_id)Объединение результатов->AppendКлюч группировки (store_group_id)3)COUNT(receipt_id)->HashAggregateGroupKey: share0_ref2.store_group_id 2)DISTINCTключ группировки+receipt_id->HashAggregateGroupKey: share0_ref2.store_group_id, share0_ref2.receipt_id 1) Перераспределение данных по ключу группировки->Redistribute MotionHash Key: share0_ref2.store_group_idСчитывание данных из1части плана->Shared Scan (share slice:id1:0)Ключ группировки (store_group_id, plu_group_id)3)COUNT(receipt_id)->HashAggregateGroupKey: share0_ref3.store_group_id, share0_ref3.plu_group_id 2)DISTINCTключ группировки+receipt_id->HashAggregateGroupKey: share0_ref3.store_group_id, share0_ref3.plu_group_id, share0_ref3.receipt_id 1) Перераспределение данных по ключу группировки->Redistribute MotionHash Key: share0_ref3.store_group_id, share0_ref3.plu_group_idСчитывание данных из1части плана->Shared Scan (share slice:id2:0)
Судя по плану запроса, расчёт количества чеков выполняется в 3 шага:
- Перераспределение данных по ключу группировки.
- DISTINCT ключ группировки + receipt_id.
- COUNT(receipt_id).
Переданные в запрос группы товаров и группы магазинов явно не равномерны. После перераспределения данных (шаг 1) на 1 или нескольких сегментах может оказаться слишком много данных, что означает то, что некоторые сегменты будут перегружены, и выполнение запроса будет означать обработку данных на этих сегментах.
Чтобы посмотреть, сколько строк пришло на сегмент, можно включить SET gp_enable_explain_allstat = ON; передEXPLAIN ANALYZE. Тогда в плане появится доп. информация под каждым узлом:
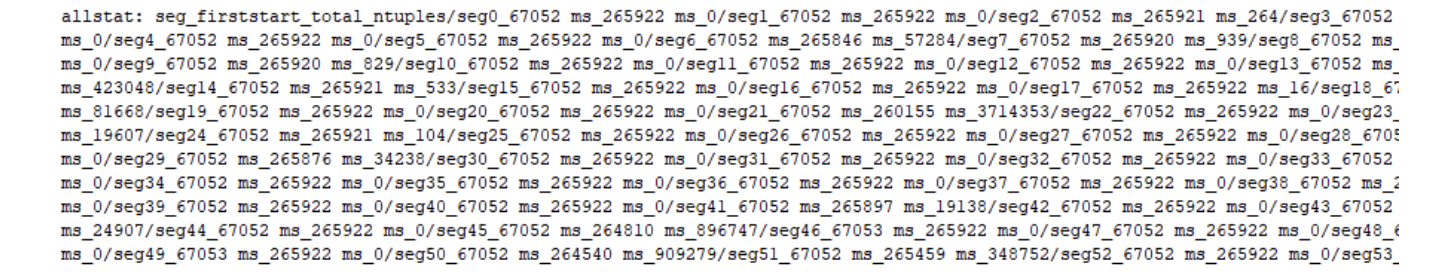
Путём парсинга можно получить список сегментов ( приведена только его часть):
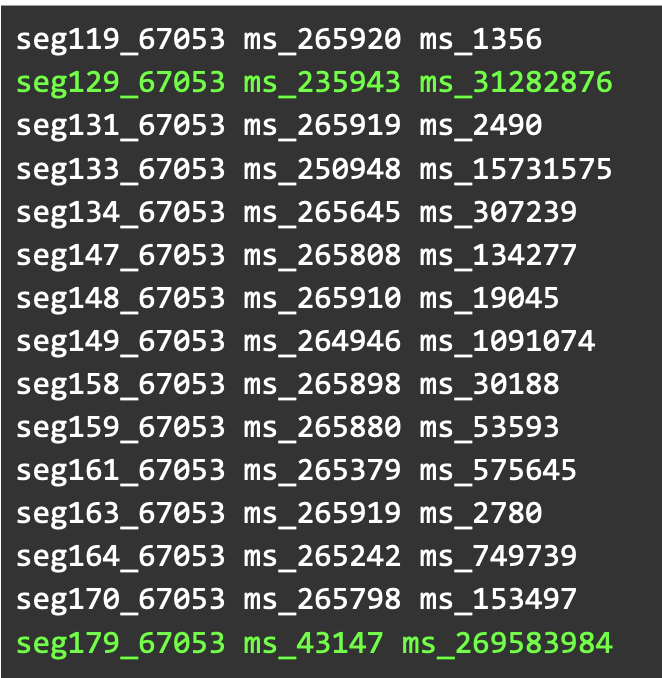
Ключ группировки распределился по 58 сегментам, виден явный перекос на одном из сегментов.
Вышеуказанный запрос выполняется около 1 минуты на периоде 1 месяц (в зависимости от нагрузки на кластере).
Риски и ошибки, которые мы выявили:
- Неравномерное распределение ключей группировки ведёт к неэффективной загрузке сегментов;
- Использование COUNT(DISTINCT) в распределённых системах без дополнительной оптимизации часто вызывает узкие места;
- Отсутствие учёта аддитивности метрик по времени приводило к избыточному перераспределению данных.
Решение 1: Использование параметра optimizer_force_multistage_agg
Мы применили параметр, который заставляет оптимизатор GPORCA выбирать многоступенчатый план агрегации. Это позволило добавить дополнительный этап перераспределения данных по ключу группировки + receipt_id, что значительно уменьшило перекос.
Включение параметра на уровне сессии:
SET optimizer_force_multistage_agg = on;
Включаем параметр SET optimizer_force_multistage_agg = on и приказываем оптимизатору выбирать двухэтапный агрегированный план.
План на примере ключа группировки (store_group_id, plu_group_id):
Ключгруппировки(year_granularity, store_group_id, plu_group_id)4)COUNT(receipt_id)->HashAggregateGroupKey: share0_ref3.store_group_id, share0_ref3.plu_group_id 3)Перераспределениеданныхпоключугруппировки->Redistribute MotionHash Key: share0_ref3.store_group_id, share0_ref3.plu_group_id 2)DISTINCTключгруппировки+receipt_id->HashAggregateGroupKey: share0_ref3.store_group_id, share0_ref3.plu_group_id, share0_ref3.receipt_id 1)Перераспределениеданныхпоключугруппировки+receipt_id, receipt_id->Redistribute MotionHash Key: share0_ref3.store_group_id, share0_ref3.plu_group_id, share0_ref3.receipt_id, share0_ref3.receipt_id ->Shared Scan (share slice:id3:0)
В данном случае расчёт количества чеков выполняется в четыре шага:
- Перераспределение по ключу группировки + receipt_id (уменьшает перекос, так как количество уникальных значений receipt_id слишком велико);
- DISTINCT по ключу группировки + receipt_id (уменьшает количество данных для следующего оператора перераспределения);
- Перераспределение по ключу группировки.
- COUNT(receipt_id).
После этого запрос стал выполняться в 3,5–4,5 раза быстрее. Однако мы не рекомендуем включать этот параметр глобально, так как это может негативно сказаться на других запросах. Важно использовать его точечно и только после тщательного тестирования.
Решение 2: Алгоритмическая оптимизация — расширение ключа группировки
Мы воспользовались свойством аддитивности метрики «количество чеков» по времени. Добавив поле calendar_dk (день) в ключ группировки, мы увеличили количество ключей в 30 раз, что обеспечило более равномерное распределение данных по сегментам.
Оптимизированный запрос:
INSERT INTOreceipts_cnt_basketsWITH draftAS(SELECTsest.store_group_id, fcre.calendar_dk, COALESCE(sepl.plu_group_id,0::INT4)ASplu_group_id,COUNT(DISTINCTfcre.receipt_id)AScnt_basketsFROMfct_receiptsASfcreINNERJOINselected_storesASsestUSING (store_id)INNERJOINselected_pluASseplUSING (plu_id)WHERE 1 = 1 ANDfcre.receipt_dttm >= '2023-08-01 00:00:00'::TIMESTAMP ANDfcre.receipt_dttm <= '2023-09-01 00:00:00'::TIMESTAMP GROUP BYGROUPING SETS ((store_group_id, calendar_dk, plu_group_id), (store_group_id, calendar_dk )))SELECTstore_group_id, plu_group_id, SUM(cnt_baskets)FROMdraftGROUP BYstore_group_id, plu_group_id;
Для данного запроса оптимизатор выбрал план, как и в начале статьи (на примере ключа группировки (store_group_id, calendar_dk, plu_group_id)):
3)COUNT(receipt_id)->HashAggregateGroupKey: share1_ref3.store_group_id, share1_ref3.calendar_dk, share1_ref3.plu_group_id 2)DISTINCTключгруппировки+receipt_id->HashAggregateGroupKey: share1_ref3.store_group_id,share1_ref3.calendar_dk, share1_ref3.plu_group_id, share1_ref3.receipt_id 1)Перераспределениеданныхпоключугруппировки->Redistribute MotionHash Key: share1_ref3.store_group_id, share1_ref3.calendar_dk, share1_ref3.plu_group_id ->Shared Scan (share slice:id2:1)
Этот подход позволил ускорить запрос в 7–9 раз по сравнению с исходным вариантом. Кроме того, он снизил нагрузку на сеть кластера, так как объем перераспределяемых данных сократился.
С учетом всего выше сказанного можно сделать следующие выводы:
Во-первых, всегда анализируйте природу данных. Понимание аддитивности метрик и распределения ключей поможет выбрать оптимальную стратегию оптимизации.
Во-вторых, старайтесь диагностировать перекосы данных с помощью инструментов вроде gp_enable_explain_allstat - это позволит выявить узкие места в работе кластера.
В – третьих, используйте многоступенчатую агрегацию через параметр optimizer_force_multistage_agg для запросов с COUNT(DISTINCT), но делайте это осторожно и только для конкретных запросов.
В – четвертых, расширяйте ключи группировки за счёт аддитивных по времени полей. Это простое, но эффективное решение для борьбы с перекосами.
И, наконец, в – пятых, избегайте глобального изменения параметров оптимизатора без предварительного тестирования на всех критичных запросах.


