

Выбор технологий хранения: warehousing, lakehouse
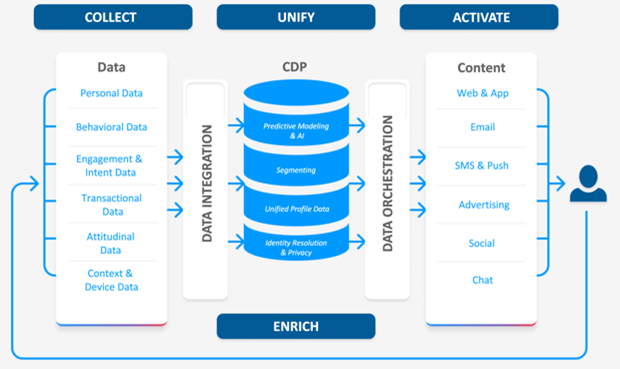
Выбор технологий хранения данных — один из критических шагов на пути построения качественного Customer Data Platform (CDP) и эффективного использования BI и DWH. В контексте CDP задача не ограничивается сбором и хранением данных из CRM и веб-аналитики. Цель — обеспечить единое «хранилище» данных о клиентах, которое поддерживает быстрые BI-отчеты, сегментацию, моделирование и персонализацию в режиме, близком к реальному времени. Это требует продуманной архитектуры хранения: какие данные хранить, в каком формате, как их структурировать, как обеспечивать консистентность и безопасность, какие операции доступны для аналитики и как минимизировать стоимость владения.
Существуют две ключевые концепции, которые часто соперничают или дополняют друг друга в рамках CDP: warehousing и lakehouse. Традиционный data warehouse (DW) — это системно организованное хранилище для структурированных данных с хорошо продуманной схемой, строгой транзакционной целостностью и ориентированностью на быстрые агрегации. Data lake — это хранилище больших объемов полуструктурированных и неструктурированных данных, обычно в формате сырого «как есть» и с меньшими ограничениями по схеме. Lakehouse — более современная концепция, которая объединяет преимущества DW и Data Lake: масштабируемость и гибкость lake с возможностью поддерживать транзакции, схему, управление метаданными и оптимизацию запросов. В процессе реализации CDP часто приходится решать задачи: как перейти от централизованного DW к lakehouse-ориентированной архитектуре без потери качества данных, как обеспечить ACID-правила при работе с большими данными на объектном хранилище, какие форматы и каталоги данных выбрать, какие инструменты использовать для ETL/ELT, мониторинга качества и безопасности.
Данная глава предназначена для новичков в команде: объясняет ключевые понятия, сравнивает подходы, приводит примеры реальных технологических наборов (как открытых проектов, так и российских решений), а также обсуждает риски и ограничения внедрения. В конце вы найдете FAQ, который поможет быстро вспомнить основные моменты и ответить на частые вопросы, возникающие при выборе между warehousing и lakehouse в рамках CDP.
Определение и основные понятия
- Data Warehouse (DW) — это целенаправленно структурированное хранилище данных, оптимизированное под выполнение аналитических запросов. В DW данные обычно проходят ETL-процесс: извлечение из источников, преобразование и загрузка в схемы, ориентированные на бизнес-процессы (например, табличные схемы типа звездной или снежинки). Главные характеристики DW: консистентность, схемность, предсказуемые задержки и производительность для агрегаций, поддержка транзакций на уровне операций записи и чтения.
- Data Lake — это хранилище больших объемов данных различного типа: структурированных, полуструктурированных и неструктурированных. В ленточном представлении lake ориентирован на хранение «как есть», с минимальной обработкой на этапе загрузки. В lake данные часто хранятся в формате Parquet, ORC или Avro и извлекаются/аналитируются позднее. Главные характеристики Data Lake: масштабируемость, гибкость форматов, дешевый хранение больших объемов, отсутствие жесткой схемы на стадии загрузки (schema-on-read).
- Lakehouse — современная архитектура, которая объединяет преимущества DW и Data Lake. Lakehouse хранит данные на объектном хранилище, но обеспечивает транзакции (ACID), схему эволюцию и богатый метаданные-менеджмент, позволяя выполнять запросы высокой производительности и аналитическую обработку как в DW, так и в Lake. В lakehouse часто применяются форматы столбцовых данных (Parquet, ORC), а для обеспечения транзакционной целостности используются специализированные форматы таблиц, такие как Apache Iceberg, Apache Hudi или Delta Lake.
Форматы данных и метаданные
- Форматы столбцовых данных: Parquet, ORC, Avro — оптимизированы под аналитические запросы, обеспечивают эффективную компрессию и скорость сканирования.
-
Форматы управления таблицами с поддержкой версионирования и транзакций: Iceberg, Hudi, Delta Lake. Эти форматы позволяют:
- выполнять обновления и удаление (upserts) без перезаписи всего файла;
- эволюцию схемы без ломки существующих данных;
- поддержку временных путей (time travel) для анализа изменений во времени.
- Каталоги и метаданные: Hive Metastore, AWS Glue, Apache Iceberg catalog, OpenMetadata и подобные решения. Хороший каталог обеспечивает быстрый поиск данных, отслеживание источников, версии таблиц, линейность данных и доступ к данным через разные движки (SQL-экраны, Spark, Trino/Presto, ClickHouse и прочие).
Архитектура и принципы проектирования
- ELT против ETL: в современных хранилищах чаще применяется ELT — данные сначала загружаются в «мягкую» землю, после чего трансформации выполняются на уровне вычислений в хранилище. Это обеспечивает гибкость, более быструю доставку данных и масштабируемость по мере роста объема данных и числа источников.
- Стратегия слоев: bronze (сырьевые данные), silver (очищенные и нормализованные данные), gold (готовые к использованию в BI/аналитике агрегаты и модели). Lakehouse-подход естественным образом поддерживает такую многоуровневую архитектуру за счет эффективной обработки больших объемов данных в разных форматах.
- Гибкость и управляемость: lakehouse позволяет работать с разнообразными данными (клиентская активность, клиенты, транзакционные логи, изображения, документы), но требует системного управления качеством данных, мониторинга и узлов IAM/безопасности.
- Безопасность и соответствие требованиям: шифрование данных в покое и в транзите, разграничение доступа на уровне ролей и таблиц, аудит доступа, маскирование PII, соответствие требованиям GDPR/Роскомнадзора/локализации данных — это обязательные элементы любой современной архитектуры хранения.
Производительность, стоимость и эксплуатация
- Производительность запросов зависит от форматов, каталога, подходов к индексации и распределению данных. В lakehouse важна способность выполнения эффективной prune-подборки (pruning), хранение в оптимальном формате и поддержка кэширования слоев вычислений.
- Стоимость: затраты на хранение (объектное хранилище), вычисления (кластер исполнения), лицензионные сборы за SI-технологии (инструменты управления метаданными, движки SQL) и стоимость миграций/перекатов. Lakehouse может снизить стоимость хранения за счет эффективной компрессии и разделения вычислений от хранения, но требует инвестиций в инфраструктуру каталога и управления версиями.
- Операционная устойчивость: мониторинг загрузок, контроль качества данных, управление версиями таблиц, резервное копирование, планирование обновлений схем и структур таблиц, обработка сбоев и восстановления.
Роли и сценарии использования в CDP
- В CDP ключевые данные о клиентах приходят из разных систем: CRM, ERP, веб-аналитика, мобильные приложения, службы поддержки, офлайн-мероприятия. Хранение этих данных в lakehouse обеспечивает гибкость и возможность объединенного анализа, сегментации и персонализации.
- Для оперативной аналитики и BI часто требуется быстрый доступ к агрегированным данным и витринам для маркетинга, продаж и поддержки. В этих случаях полноценный DW (или DW-часть lakehouse) обеспечивает низкую латентность и предсказуемую производительность.
- В рамках CDP важно поддерживать временные версии данных и временную аналитику: time travel, версия истории изменений клиента, ретроспективный анализ активности. Iceberg/Hudi/Delta позволяют реализовать такие сценарии на уровне таблиц.
Практические примеры
Общие примеры Open Source и российских подходов помогут увидеть, как можно реализовать warehousing и lakehouse-схемы в реальной компании.
1) Open-Source стек для lakehouse
- Хранилище данных и формат: объектное хранилище (S3-совместимое, Gluster/MINIO) с Parquet/ORC.
- Табличный формат с поддержкой транзакций: Apache Iceberg как основной формат таблиц на объектном хранилище. Iceberg обеспечивает транзакционность, эволюцию схемы и эффективные запросы через метаданные и каталоги.
- Вычислительная платформа: Apache Spark или Apache Flink для обработки ETL/ELT, преобразований, загрузки и реальной временной аналитики. Spark может читать/пишуть Iceberg-таблицы напрямую.
- Оркестрация: Apache Airflow или Dagster для координации ETL-пайплайнов, зависимостей и мониторинга.
- Каталог метаданных: встроенный Iceberg catalog (Hive Metastore, Hadoop-каталог, AWS Glue, или локальные каталоги Iceberg). Дополнительно — OpenMetadata для управления метаданными, lineage и качества данных.
- Визуализация и BI: Apache Superset или Metabase для дашбордов и исследований. dbt для управляемых трансформаций данных в слое Silver/Gold.
- Пример сценария: загрузка данных клиентов из источников (CRM, веб-аналитика, мобильные приложения) в Bronze-слой в Parquet на объектном хранилище, очистка и нормализация в Silver-слое с использованием Spark и Iceberg-таблиц, создание Gold-слоя с агрегированными витринами и готовыми к BI таблицами. Весь процесс контролируется Airflow, изменения версий таблиц отслеживаются через Iceberg catalog, а данные мониторятся через OpenMetadata.
2) Российские решения и интеграции
- ClickHouse как хранилище для аналитических запросов: это российская разработка, широко применяемая в аналитике больших данных. ClickHouse отлично подходит для DW-слоя (OLAP-запросы, низкая задержка, горизонтальное масштабирование). Он особенно эффективен для сегментыции клиентов, ретеншина, поведенческих аналитик и дашбордов в реальном времени.
- Яндекс Облако и российские практики хранения: Яндекс Облако предоставляет Object Storage и сервисы для аналитики, которые можно использовать как основу lakehouse-архитектуры на российском облаке. В сочетании с ClickHouse можно построить быстрый и надежный слой DW и подходящий слой храненея сырых данных в Object Storage Яндекс.Облако, поддерживающий Parquet, ORC и другие форматы.
- Интеграции и пайплайны: для российской экосистемы часто применяют Kafka для стриминга, Airflow или Dagster для оркестрации, dbt для трансформаций, а также открытые решения для мониторинга и контроля качества. Такой набор обеспечивает устойчивую инфраструктуру данных, соответствующую требованиям по локализации и регуляторике.
3) Примеры конкретных сценариев архитектуры
- Пример A (lakehouse + DW): данные о клиентах поступают в lakehouse через партиционированные S3-совместимые бакеты в формате Parquet. Iceberg таблицы управляют сущностями клиентов и их активностями. Spark выполняет ETL-процессы, превращая сырые данные в Silver и Gold слои. BI-отчеты строятся на слоях Gold через Trino/Presto и визуализацию (Superset). Оперативные панели показывают текущее поведение клиента, сегменты и показатели конверсий.
- Пример B (чистый DW на ClickHouse): в случаях, где критично низкое время отклика и большой поток запросов, используется DW на ClickHouse. Источники данных пишутся в через Kafka, затем загружаются в столбцовые таблицы ClickHouse. Важная часть — правильная модель данных (звезда/снежинка) и индексирование. Обеспечивается консистентность через транзакционные возможности ClickHouse и периодическую очистку/миграцию данных из lake-слоя в DW-слоя в рамках согласованных бизнес-процессов.
- Пример C (Hybrid с локализацией): данные клиентов сначала попадают в Data Lake на российском облаке, затем агрегируются и перемещаются в ClickHouse для быстрых отчётов. В качестве механизма трансформаций применяются dbt и Spark. Это обеспечивает и гибкость lakehouse, и производительность DW для BI.
Форматы и данные
- Parquet и ORC — базовые форматы столбцовых данных, минимизирующие дискозатраты и ускоряющие сканирование. Parquet популярен из-за гармонизации со многими движками (Spark, Trino, ClickHouse через внешние источники) и эффективной компрессии.
- Iceberg, Hudi, Delta Lake — форматы таблиц, предоставляющие ACID-транзакции на уровне файлов и каталогов в объектном хранилище. Iceberg поддерживает развёртывание схем, параллелизм и «time travel» запросы. Hudi подходит для сценариев с частыми upsert-операциями. Delta Lake (первоначально от Databricks) обеспечивает транзакционность и схему эволюцию на S3/ADLS.
- Каталоги метаданных и линейность: Hive Metastore, AWS Glue, Iceberg Catalog, OpenMetadata. Каталоги хранят информацию о версиях таблиц, схемах, местоположении файлов и источниках данных, что критично для повторного анализа и аудита.
Архитектура слоев и управление данными
- Bronze/Silver/Gold (слои трансформаций): Bronze — сырой поток данных, Silver — очищенные данные, Gold — готовые для BI витрины и аналитических моделей. Lakehouse позволяет реализовать эти слои на едином хранилище, снижая трение между различными инструментами.
- Управление схемой и эволюция данных: эволюция схемы должна быть безопасной, без разрушения существующих процессов. Iceberg/Hudi/Delta позволяют добавлять новые поля, переименовывать колонки и изменять типы данных без разрыва запросов.
- Линейность и качество данных: мониторинг источников, мониторинг качества данных, тестирование трансформаций (например, с помощью dbt tests или Great Expectations). В CDP критично поддерживать доверие к данным, так как персональные данные клиентов требуют особого внимания.
Безопасность и комплаенс
- Управление доступом: RBAC на уровне баз данных и таблиц, политики на уровне объектного хранилища, шифрование в покое и в транзите (TLS, SSE), аудит доступа.
- Защита PII и персонализация: маскирование и анонимизация при необходимости, безопасные модели персонализации, минимизация объема данных, доступных для подобных операций.
- Локализация данных и соответствие требованиям: в России часто требуется локализация данных и локальные дата-центры. Выбор облачной инфраструктуры должен учитывать требования регулятора и внутренние политики компании.
Практическая настройка и эксплуатация
- Выбор движков запроса: для lakehouse — Spark SQL, Trino/Presto, а для DW — ClickHouse и подобные движки. Взаимодействие между движками осуществляется через каталоги метаданных и единый слой данных.
- Мониторинг и observability: мониторинг загрузок, латентности, ошибок трансформаций, качество данных и использование ресурсов. Важно на практике иметь дашборды по времени выполнения ETL/ELT-процессов, потреблению CPU/памяти и по количеству обработанных записей.
- Резервное копирование и восстановление: регулярное создание снимков (snapshots) таблиц Iceberg/D/Hudi, резервное копирование объектного хранилища, планы восстановления после сбоев.
- Обновления и миграции: эволюция схем, переход на новые форматы, миграция данных между слоями без простоев для бизнес-пользователей.
Риски и ограничения
Сложность архитектуры
- Lakehouse объединяет две парадигмы, но это усложняет управление архитектурой, требования к компетенциям команды и governance. Необходимо грамотное проектирование каталогов, схем, прав доступа, а также документирование пайплайнов и зависимостей.
Цена и стоимость владения
- Хранение больших объемов данных в ледяном объеме может быть недорогим, но вычислительная инфраструктура для обработки и аналитики может существенно увеличивать стоимость. Важно учитывать стоимость хранения, вычислений, лицензий, сетевого трафика и миграций.
Консистентность и качество данных
- В lakehouse возможны расхождения между слоями данных, дубликаты и недостаточно детальные трассировки источников. Необходимо внедрить строгие процедуры управления качеством данных, тестирования и lineage.
Безопасность и соответствие требованиям
- Работа с персональными данными клиента требует строгой защиты, контроля доступа и аудита. Неправильная настройка RBAC или ошибки в маскировании могут привести к утечке данных.
Миграции и миграционные риски
- Переход от чистого DW к lakehouse или комбинации DW+Lake требует планирования миграций, тестирования влияния на существующие BI-отчеты и пользователей. Риски включают простои, задержки в линейках трансформаций и несовместимости между инструментами.
Зависимость от технологий и экосистем
- Выбор Iceberg/Hudi/Delta и конкретных движков приводит к зависимости от конкретной экосистемы. В долгосрочной перспективе это может привести к сложности переключения между решениями и ограничить гибкость.
Регуляторные и локальные ограничения
- В России важны вопросы локализации, госрегулирования и санкций. Необходимо выбрать решения и провайдеров, которые соответствуют требованиям локализации и предоставляют необходимый уровень поддержки.
Выбор технологий хранения в рамках CDP требует баланса между скоростью доступа, гибкостью данных, управляемостью и стоимостью. Warehousing и lakehouse — не взаимоисключающие подходы, а разные конструкции, которые можно сочетать в единой архитектуре: DW обеспечивает быстрый доступ к структурированным данным и аналитическим витринам, lakehouse обеспечивает масштабируемость, схему и транзакции над широким набором данных и форматов. В рамках CDP особенно полезны слоистые подходы (bronze/silver/gold), которые позволяют разделить «сырые» данные и бизнес-готовые витрины. Важно помнить оGovernance, контроле качества, безопасности и соответствии требованиям, а также о грамотной миграции и обучении команды.
FAQ (Вопрос–Ответ)
В чем разница между DW и lakehouse? Когда выбирать каждую модель в CDP?
DW — это традиционное хранилище, оптимизированное под структурированные данные и быстрые агрегации, с сильной транзакционной целостностью. Lakehouse — объединение преимуществ DW и Data Lake: масштабируемость и гибкость Data Lake вместе с транзакционной надёжностью и управлением схемами. В CDP lakehouse чаще всего применяется для единого источника истины, который объединяет данные разных источников и типов, в то время как DW может использоваться для специфических витрин и высокопроизводительных BI-отчётов. Выбор зависит от требований к задержкам, разнообразия данных, бюджета и готовности команды поддерживать более сложную инфраструктуру.
Какие технологии стоит рассмотреть для lakehouse?
Open-source решения: Apache Iceberg (табличный формат на объектном хранилище с поддержкой ACID и схеме изменений), Apache Hudi, Delta Lake. Инструменты вычисления: Apache Spark, Trino/Presto, Flink. Оркестрация: Apache Airflow, Dagster. Метаданные и линейность: OpenMetadata, Iceberg catalog ( Hive Metastore, Glue и т. п.). Визуализация и трансформации: Apache Superset, dbt. Российские и локальные решения: ClickHouse как быстрый DW-слой для анализа; использование российского облака (Яндекс Облако) для хранения и интеграций. В сочетании с локальным форматом Parquet/ORC и инструментами для ETL/ELT это обеспечивает локализованную и эффективную архитектуру под CDP.
Почему в CDP важна концепция bronze/silver/gold?
Такая сегментация упрощает управление качеством данных, обеспечивает прозрачность трансформаций и снижает риски для бизнес-пользователей. Bronze — это источник, который можно подробно анализировать и проверять, Silver — очищенные и нормализованные данные, Gold — бизнес-витрины и готовые к аналитике данные. Это позволяет отделить операционные данные от аналитических и обеспечивать устойчивый доступ к данным для разных групп потребителей.
Какие российские практики полезны для реализации DW/ lakehouse?
Использование ClickHouse как мощного DW-аналитического хранилища. Яндекс Облако как инфраструктура для хранения данных и интеграции с российскими сервисами. Kafka для стриминга, Airflow для оркестрации, dbt для трансформаций и OpenMetadata/Alternatives для управления метаданными. Важно также учитывать локализацию и регуляторику, выбирая провайдеров и инструменты.
Как обеспечить безопасность и соответствие требованиям в lakehouse/CDP?
Реализация RBAC и IAM на уровне источников и таблиц, шифрование данных в покое и в транзите (TLS, SSE), аудит доступа, маскирование PII, политик доступа к данным по ролям. Включение процессов управления данными и политики соответствия (GDPR, локальные регламенты) и учет требований к локализации данных в инфраструктуре, особенно в российских условиях.
Какие риски стоит предусмотреть при внедрении?
Сложность архитектуры и управлением данными, расходы на вычисления и хранение, риск несогласованности между слоями, проблемы с качеством данных и lineage, регуляторные сложности и локализационные требования. Чтобы минимизировать риски, нужно строить governance с начала проекта: правила метаданных, тестирование трансформаций, мониторинг данных и четкую документацию.
Как оценить TCO для DW vs lakehouse?
Оценка включает стоимость хранения данных, вычислений, лицензий и поддержки, а также затраты на миграцию и обучение команды. Lakehouse может снизить некоторые затраты за счет меньшей необходимости повторного хранения данных и гибкого использования вычислений, но требует инвестиций в каталоги, форматы таблиц и инструменты управления. Подсказка: моделируйте различные сценарии нагрузки и объемы данных, чтобы увидеть реальную экономику в вашей организации.
Как мигрировать существующий DW к lakehouse?
Начать с идентификации наиболее важных бизнес-витрин, которые можно переносить в Gold-слой lakehouse, постепенно добавлять слои Bronze и Silver, внедрять Iceberg/Hudi/Delta как слой таблиц, настраивать каталоги и линейность, мигрировать источники данных и пайплайны трансформаций, тестировать консистентность и качество данных. Не забывайте про параллельную работу BI-пользователей и бизнес-подразделений на новых витринах, чтобы обеспечить плавный переход.
Как обеспечить консистентность между слоями?
Используйте единый каталожный слой и форматы таблиц (Iceberg/Hudi/Delta), чтобы изменения в Bronze/ Silver не ломали Gold. Применение ELT-подхода, версионирование схем, time travel и строгие тесты трансформаций помогают поддерживать согласованность. Механизмы миграции и мониторинга качества данных также являются ключевыми.
Что выбрать в условиях жесткой локализации данных и ограничений?
Если локализация критична, рассмотрите российские решения: ClickHouse как DW-платформу и российские облачные сервисы для хранения (Яндекс Облако или локальные дата-центры). Важно, чтобы каталоги, механизмы аутентификации и сетевые политики поддерживали требования локализации, прав доступа и аудита. Также можно сочетать зарубежные инструменты с российскими сервисами в гибридной архитектуре, чтобы сохранить желаемый уровень функциональности и соответствия требованиям.
Выбор технологий хранения — ключевой фактор успеха CDP-проектов. Правильная комбинация warehousing и lakehouse, адаптированная под задачи BI и аналитики, обеспечивает быстрый доступ к данным, гибкость в работе с разнообразными источниками и формами данных, а также высокий уровень контроля за качеством и безопасностью. При разработке архитектуры обязательно учитывайте требования к латентности, governance, стоимость и локализацию. В реальных условиях часто применяется гибридный подход: DW для оперативной аналитики и витрин, lakehouse для масштабного хранения разнообразных данных и построения единых клиентских профилей. Важна командная работа, четкие принципы управления данными, устойчивые пайплайны и поддержка изменений. Удачный выбор инструментов и архитектуры — путь к эффективной реализации CDP и успешному применению BI и DWH для персонализации и повышения бизнес-эффективности.
Вопрос–Ответ (FAQ) ч2
Что предпочтительнее выбрать в CDP — DW на ClickHouse или lakehouse на Iceberg?
Ответ: Выбор зависит от требований к задержкам и объему данных. DW на ClickHouse обеспечивает очень быструю аналитическую выдачу по готовым витринам и подходит для высокочастотной отчетности. Lakehouse на Iceberg обеспечивает гибкость и масштабируемость для хранения разнообразных данных и поддержки транзакций. Часто целесообразно сочетать: использовать DW для оперативной аналитики и витрин, а lakehouse — для хранения всего спектра данных и управляемых трансформаций, мигрируя по мере роста потребностей в гибкости и объеме данных.
Какие форматы данных лучше использовать в lakehouse?
Ответ: Parquet — основной формат для аналитических данных благодаря эффективной компрессии и скорости чтения. ORC — альтернативный формат с похожими преимуществами. Iceberg/Hudi/Delta Lake — форматы таблиц, которые обеспечивают ACID-транзакции, схемы эволюцию и удобное управление версиями. В комбинации Parquet + Iceberg/Hudi/Delta Lake дают мощную базовую основу lakehouse.
Как обеспечить качество данных в lakehouse/CDP?
Ответ: Внедрять тестирование трансформаций (например, dbt tests, Great Expectations), реализовать lineage и мониторинг данных через OpenMetadata, настраивать внешние/внутренние проверки на входе в Bronze и Silver слои, использовать проверки на уникальность, целостность ключей и соответствие бизнес-правилам. Регулярно проводить аудиты данных, отслеживать несоответствия и быстро реагировать на проблемы.
Какие российские решения можно использовать в рамках DW/CDP?
Ответ: Российские решения включают ClickHouse в роли DW, Яндекс Облако как инфраструктура хранения и интеграций, а также локальные решения для оркестрации и анализа. В сочетании с открытыми технологиями (Spark, Iceberg, Trino, dbt) можно построить устойчивую и локализованную архитектуру CDP.
Какие риски наиболее опасны в процессе внедрения?
Ответ: Наибольшие риски — это усложнение архитектуры и governance, возможные простои при миграции, рост затрат на вычисления и хранение, проблемы качества данных и потенциальные утечки PII при плохой настройке безопасности. Чтобы минимизировать риски, нужно заранее определить принципы управления данными, внедрить тестирование и мониторинг, обеспечить строгий контроль доступа и документировать все процессы.
Как мигрировать данные в lakehouse без потери доступности BI?
Ответ: Миграцию стоит планировать поэтапно: сначала перенести критично важные витрины в Gold-слой lakehouse, параллельно сохранять существующие витрины DW для BI пользователей, тестировать целостность данных, затем постепенно отключать старые процессы и переводить пользователей на новые витрины. Используйте версионирование схем и времени travel для безопасной миграции и проверяйте консистентность перед отключением старых источников.
Что важно учесть при локализации данных в условиях российской регуляторики?
Ответ: В первую очередь — выбор инфраструктуры, поддерживающей локализацию и соответствие требованиям регулятора. Обратите внимание на политиках доступа, аудитах, шифровании, сетевой сегментации, хранении резервов и право на доступ к данным. Убедитесь, что провайдеры и инструменты поддерживают региональные требования по хранению и обработке персональных данных. При необходимости используйте гибридные решения: часть данных храните в российском дата-центре, часть — в облаке с соблюдением локализации, чтобы удовлетворить бизнес-потребности и регуляторные требования.
Какие показатели эффективности стоит отслеживать для DW и Lakehouse?
Ответ: Для DW — latency запросов, throughput, время до первого ответа, точность и полнота витрин, время обновления данных. Для Lakehouse — время загрузки сырых данных, скорость эволюции схем, стоимость хранения и вычислений, частота обновления версий таблиц, качество данных и линейность. Также важно иметь KPI по доступности и отклику BI-инструментов.
Нужно ли обучать команду новым технологиям?
Ответ: Да. Lakehouse требует знаний о транзакциях на уровне таблиц и форматов, управлении версиями данных, каталогами, а также опыта работы с инструментами для трансформации (dbt), оркестрации (Airflow), вычислений (Spark/Flink) и визуализации (Superset). Регулярное обучение и практические тренировки в рамках проекта CDP помогут снизить риск ошибок и увеличить скорость внедрения.
Какой путь к внедрению считается лучшим стартом для новой команды?
Ответ: Лучше начать с определения бизнес-потребностей и источников данных, затем выбрать простой начальный стек DW на базе ClickHouse для базовой аналитики и BI. Параллельно можно строить lakehouse на Iceberg/Delta, подключив к нему основные источники и внедрив ELT-пайплайны и трансформации через dbt и Spark. Постепенно расширяйте функциональность, внедряйте слои Bronze/Silver/Gold, каталог и мониторинг, и по мере готовности перемещайте пользователй на новые витрины. Такой поэтапный подход снижает риски и позволяет быстро получить первые быстрые результаты для бизнеса, одновременно развивая инфраструктуру под будущие потребности CDP.


