

Введение в CLTV и роль BI и DWH
Customer Lifetime Value (CLTV) — это сумма прибыли, которую компания может ожидать от конкретного клиента за все время взаимоотношений. В современном бизнесе CLTV выступает не просто метрикой, а руководством к принятию решений: где инвестировать маркетинг, какие сегменты клиентов развивать, какие продукты и цены предлагать, как выстраивать сервис и удержание. В этом курсе мы изучим CLTV через призму бизнес-аналитики и хранилищ данных: какие данные нужны, как их собирать и хранить, какие методы расчета и моделирования применяются на практике, какие инструменты (open-source и российские решения) позволяют реализовать полный цикл — от добычи данных до визуализации и принятия решений. Мы обратим особое внимание на роль BI и DWH в расчете CLTV: как проектировать архитектуру данных, как строить ETL-пайплайны, как моделировать и валидировать CLTV, как проводить анализ по сегментам и кoортам, какие риски и ограничения возникают при внедрении и как их минимизировать. В конце главы вы увидите практические примеры, которые можно воспроизвести на открытом ПО и на российских решениях, а также блок FAQ с ответами на часто встречающиеся вопросы.
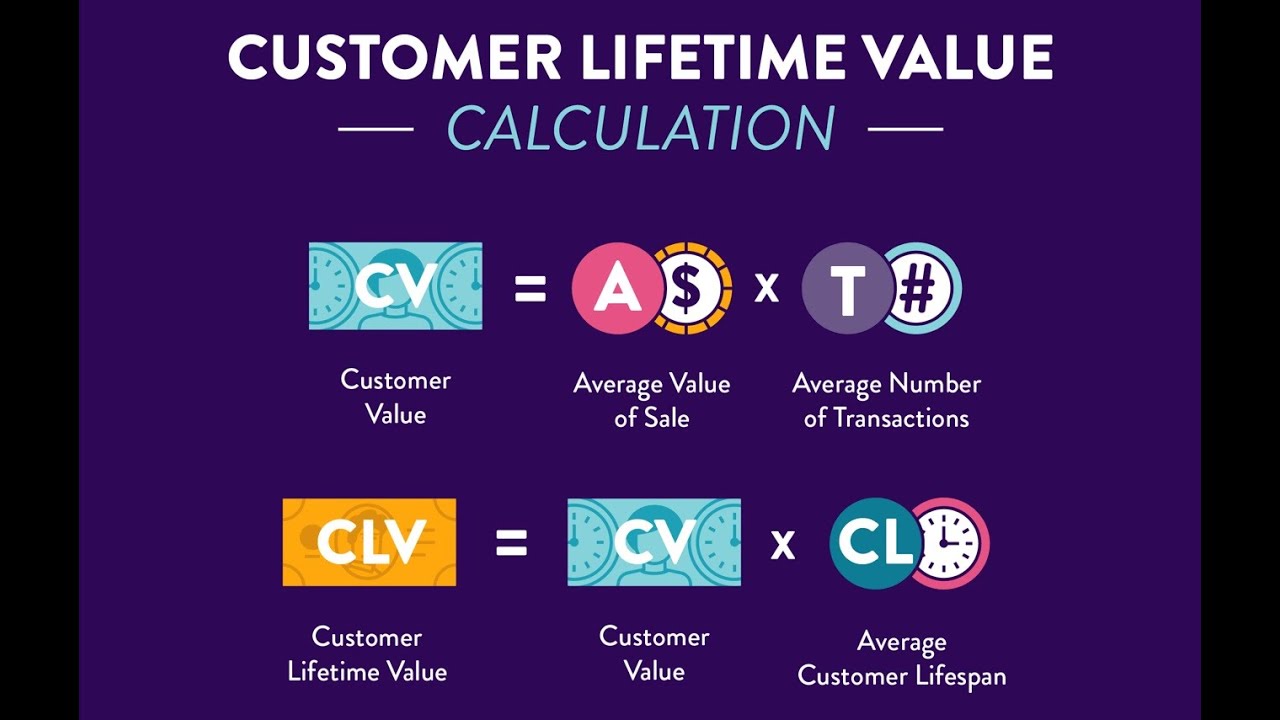
Определения и концепции
- CLTV (Lifetime Value) — ожидаемая суммарная прибыль или выручка, которую приносит клиент за весь срок взаимодействия. В простых моделях CLTV часто считается как сумма будущих денежных потоков, дисконтированных во времени, с учетом маржи и затрат на обслуживание клиента.
- LTV и CLV различаются по точке зрения: LTV чаще применяется в операционном планировании и маркетинговых расчетах, CLTV — в долгосрочной финансовой аналитике и стратегическом планировании.
- Взаимодействие с CAC (Customer Acquisition Cost) — критичный фактор. Часто CLTV сравнивают с CAC: устойчивый бизнес достигает ситуации, когда CLTV > CAC в разрезе сегментов и каналов.
- Роль маржи и издержек — следует учитывать не только валовую выручку, но и переменные и фиксированные расходы, связанные с обслуживанием клиента, а также скидки и возвраты.
Методологии расчета CLTV
- Простые подходы: CLTV = (Средняя выручка на клиента в период) × (Средняя продолжительность взаимоотношений) × (Мартингейл или discount factor). Применимо для быстро меняющихся рынков, но игнорирует динамику churn и изменение поведения.
- Дисконтированная денежная стоимость (DCF): будущие денежные потоки дисконтируются с учетом ставки дисконтирования, чтобы учесть временную ценность денег. Формула позволяет учитывать риск и временную стоимость денег.
- Моделирование оттока (churn) и retention: предсказание вероятности удержания клиента на каждом периоде и использования этой информации для расчета CLTV.
- Коортный подход: анализ CLTV по кортам клиентов, рождающимся в одинаковый период. Такой подход помогает увидеть различия в поведении у разных групп и точнее планировать маркетинг и сервис.
- Прогнозные модели: регрессия, моделирование времени до ухода (survival analysis), Markov цепи для переходов между состояниями клиента (новый — активный — повторная покупка — уход). Использование машинного обучения для предсказания будущей выручки, маржи и вероятности ухода.
- Разложение CLTV на компоненты: вклад в прибыль от разных каналов, продуктов, регионов, сегментов. Это позволяет точечно управлять маржой и ресурсами.
BI и DWH: роль и функция
- Данные и качество: базис любой CLTV-модели — качественные данные о клиентах, транзакциях, обслуживании и маркетинговой активности. Важны полнота, точность, актуальность, консистентность и полнота истории.
- Хранилище данных (DWH): единое место для интеграции данных из CRM, ERP, веб-аналитики, платёжных систем, маркетинговых платформ. Архитектура DWH должна поддерживать исторические данные, версии схем и достаточную производительность для агрегаций и аналитики.
- ETL/ELT-процессы: сбор, очистка, трансформация и загрузка данных в хранилище. В контексте CLTV важна консистентность бизнес-логики, версия контролируемых трансформаций и возможность воспроизводимого анализа.
- OLAP и моделирование: аналитика по агрегатам и уровням детализации, поддержка сложных запросов, сквозной анализ по сегментам, кортам и временным срезам.
- Инструменты BI: для визуализации, дельного анализа, федеративного доступа к данным и оперативной реакции на бизнес-события. BI-слой обеспечивает доступ к инсайтам для маркетинга, продаж, финанса и руководства.
- Архитектура и методологии: слоистая архитектура данных (событийные данные, транзакционные данные, агрегаты), логи данных (data lineage), качество данных и правовые требования — все это критично для доверия к CLTV-аналитике.
- ГОСТы и данные: обеспечение соответствия требованиям регуляторов и корпоративной политики, в том числе в части приватности, хранения и обработки персональных данных.
Данные и источники
- Источники транзакций: ERP/CRM системы, кассовые и платежные системы, онлайн-магазин, мобильные приложения.
- Источники взаимодействий: веб-аналитика (посещения, клики), колл-центр, поддержка клиентов, email-маркетинг.
- Метаданные: описания клиентов, сегменты, ценовые политики, акции, скидки, условия поставки.
- Важно: синхронизация событий во времени, корректная идентификация пользователей (единообразный идентификатор клиента), обработка дубликатов.
Методология разработки модели CLTV
- Выбор цели: прогноз на операционный период (например, 12 месяцев) или на весь срок жизни клиента.
- Определение модели: дисконтированная выручка, учет маржи, учет затрат на обслуживание, учёт скидок и возвратов.
- Валидация и тестирование: кросс-валидация, бэктестинг на исторических данных, проверка устойчивости к шуму и сезонности.
- Метрики качества: RMSE, MAE для количественных прогнозов, ROC-AUC или Brier для вероятностей ухода, G-формы для бизнес-метрик на уровне сегментов.
- Визуализация и операционная пригодность: создание дашбордов в BI-инструментах, доступность данных для разных ролей, автоматическое обновление данных.
Практические примеры
Общая структура примера
- Сценарий: онлайн-ритейлер с несколькими каналами продаж, использующий DWH на основе PostgreSQL/ClickHouse, ETL через Airflow, визуализацию через Metabase или DataLens (российское решение).
- Цель: рассчитать CLTV по сегментам клиентов за следующий год и поддерживать актуальность прогноза на еженедельной основе.
Пример 1: базовый расчет CLTV в простом SQL
- Данные: таблица customers (customer_id, signup_date), orders (order_id, customer_id, amount, discount, status, order_date), costs (order_id, cost_of_goods_sold).
- Простой подход (без дисконтирования и churn-моделирования) может выглядеть так:
  SELECT
    c.customer_id,
    SUM(o.amount) AS total_revenue,
    SUM(o.discount) AS total_discount,
    SUM(cogs.cost) AS total_cost
  FROM customers c
  JOIN orders o ON o.customer_id = c.customer_id
  LEFT JOIN costs cogs ON cogs.order_id = o.order_id
  GROUP BY c.customer_id;
- Простой CLTV в этом контексте может быть приближением к CLTV = (total_revenue - total_cost) за период, например за год, без дисконтирования и учёта будущих покупок. В реальном сценарии мы хотим прогнозировать будущие покупки и дисконтировать их.
Пример 2: коортный подход и простая дисконтированная модель
- Ввод: добавить даты и рассчитать вероятность повторной покупки и будущее ожидаемое общее значение.
-
SQL-основа:
- рассчитать RFM-метрики: Recency (последняя покупка), Frequency (число покупок), Monetary (сумма выручки).
- построить простую дисконтированную модель: CLTV = SUM_ (Revenue_t × Probability_retained_t) / (1 + discount_rate)^t.
-
Пример использования предложенной методологии:
- определить retention-плотности по кортам: сегменты, например 0-30 дней, 31-90 дней и т.д.
- применить простую модель: CLTV по кортам = средняя маржа по кортам × вероятность удержания × дисконтирование.
- Инструменты: PostgreSQL или ClickHouse для хранения данных, Python для продвинутого моделирования (scikit-learn, lifelines для survival analysis).
Пример 3: продвинутое моделирование с использованием Python
- Передача данных из DWH в Python (pandas) через соединение JDBC/ODBC или экспорт CSV/Parquet.
- Применение survival analysis для предсказания времени до ухода и вероятности ухода, а затем расчет дисконтированной будущей выручки.
- Визуализация в BI: Metabase или DataLens для сегментации и мониторинга CLTV по каналам, продуктам и регионам.
-
Примерные шаги:
- построение модели времени до ухода (survival model) на временных рядах по клиентам.
- прогнозирование когор по retention-функции и среднему чеку.
- дисконтирование будущих денежных потоков: CLTV = Σ_{t>0} p_retained(t) × margin(t) / (1 + r)^t.
Практические примеры на открытом ПО
- Архитектура: источники данных → ETL/ELT → DWH (PostgreSQL/ClickHouse) → аналитика в Apache Spark (для больших объемов) → BI-слой (Metabase, Superset) → экспорт в DataLens для визуализации и совместной работы.
- Почему ClickHouse? Это быстрый аналитический база данных с поддержкой больших объемов данных и эффективной агрегацией, что особенно полезно для когортной и временной аналитики CLTV.
- Почему PostgreSQL? Хороший транзакционный источник для CRM/ERP, наличием расширений и удобной интеграцией с dbt.
- DataLens (российское решение): мощная платформа визуализации и анализа, интегрируемая с источниками данных в российской инфраструктуре, поддерживает быстрые панели и доступ к данным для разных ролей.
Примеры инструментов:
- ETL/ELT: Apache Airflow (оркестрация), dbt (data build tool) для трансформаций; Luigi как альтернатива.
- Базы данных: PostgreSQL для транзакционных данных, ClickHouse для агрегаций и исторических запросов.
- Аналитика и визуализация: Metabase, Apache Superset как бесплатные инструменты для дашбордов; DataLens как российское решение для визуализации и совместной работы.
- Машинное обучение: Python-библиотеки (pandas, scikit-learn, lifelines), R — для статистического моделирования и survival-анализов.
Российские решения и особый подход:
- ClickHouse — российский корень и активное развитие в отечественных проектах; широко применяется для высоких нагрузок и сложной аналитики, включая CLTV.
- DataLens — отечественная BI-платформа, хорошо интегрируется с данными внутри российского облака и локальными хранилищами.
- В контексте хранения и обработки данных широко применяются PostgreSQL и ClickHouse, что частично объясняет выбор технологий в российских проектах.
Архитектура и данные
- Архитектура DWH должна поддерживать слои: источники данных, интеграция и очистка, хранилище, агрегаты и marts, аналитика и визуализация.
- Входные данные обычно должны быть версионированы: схема изменений, миграции, контроль качества и lineage — особенно важно для согласованности CLTV-метрик.
- Ключевые таблицы для CLTV: customers (сущности клиента), orders (покупки), products (товары), price/discounts, costs (costs of goods sold), interactions (каналы маркетинга), events (поведение пользователя).
Проектирование схемы
- Звездная схема (star schema): факт-таблица продаж (fact_orders) и размерные таблицы: dim_customer, dim_product, dim_time, dim_channel. Это упрощает агрегации и ускоряет запросы для CLTV.
- Snowflake-архитектура: нормализация размерных таблиц, но потребна дополнительная работа по соединениям; выбирается, когда объём и разнообразие данных высоки.
- Метаданные и управляемость: хранение описаний полей, источников, конвенций именования, бизнес-правил и линейности данных.
ETL/ELT-процессы
- Интеграция источников: CRM/ERP, платежные системы, веб-аналитика, мобильные приложения.
- Очистка и нормализация: приведение дат к общему часовому поясу, унификация идентификаторов клиента, устранение дубликатов, обработка пропусков.
- Валидация данных: тесты качества данных, обеспечение полноты и корректности записей.
- Пакетная обработка vs потоковая обработка: для CLTV часто сочетание — ночной пакетный прогон для исторических расчетов и потоковая обработка для оперативной аналитики и актуализации показателей.
Методология реализации
- Выбор инструментов в рамках бюджета и требований к соответствию. Для российских проектов имеет смысл рассмотреть отечественные решения для BI (DataLens) и российские решения для хранения данных (ClickHouse) с возможной интеграцией в облако или локальную инфраструктуру.
- Разделение факторов риска: данные, процесс, модели и governance, мониторинг.
- Внедрение на итерациях: MVP — простой набор данных и базовая CLTV-модель; далее добавляются перерасчеты на основе churn-моделей, cohort-анализ и дисконтирование.
- Мониторинг и эксплуатация: дашборды по CLTV, мониторинг качества данных, контроль версий моделей и трансформаций.
Риски и ограничения внедрения
- Данные и качество: неполные данные, несогласованность идентификаторов, проблемы с дубликатами, задержки в записи транзакций — все это искажает CLTV и приводит к неверным бизнес-решениям.
- Гибкость и адаптация: CLTV зависит от маржи, churn, ценовой политики и каналов; любая смена в бизнес-модели требует пересмотра моделей и процессов.
- Временная стоимость денег и дисконтирование: выбор ставки дисконтирования влияет на итоговую величину CLTV; риск ошибок в оценке дисконтирования и временной ценности.
- Регуляторика и данные: законы о хранении и обработке персональных данных (GDPR/локальные требования) в разных странах влияют на доступность данных и методологии.
- Технические ограничения: сложность ETL/ELT-процессов, нагрузка на DWH, стоимость хранения и вычислений, зависимость от внешних сервисов и облаков.
- Риск ошибок моделирования: переобучение, biased data, выбор неподходящих признаков, неправильная калибровка порогов, что может привести к неверной оценке CLTV и неправильным бизнес-решениям.
- Якоря внедрения: внедрение CLTV требует координации между отделами маркетинга, продаж, ИТ и финансами; без согласованных процессов и соответствующей культуры данных результаты будут неполными и противоречивыми.
- Вариативность по сегментам: CLTV может сильно различаться между каналами, регионами, продуктами; без сегментации и глубокой аналитики риск ложных общих выводов.
Выводы
- CLTV — мощная метрика для принятий решений, но эффективное применение требует усиленного фокуса на данные, архитектуру данных и методы анализа.
- BI и DWH выступают опорой для CLTV: они обеспечивают единое хранилище, доступ к данным и средства анализа, которые позволяют бизнесу не только считать CLTV, но и качественно управлять им через сегментацию, каналы и продукты.
- Важна последовательная работа: от сбора данных и качественной подготовки до моделирования и визуализации; регулярная валидация и обновление моделей, а также обеспечение прозрачности и контроля качества данных.
- Российские решения и открытое ПО дают широкий набор инструментов: ClickHouse для высокопроизводительной аналитики, DataLens для визуализации и совместной работы, PostgreSQL как база данных; для обработки больших данных — Apache Spark и Airflow; для моделирования — Python‑библиотеки; для визуализации — Metabase и Superset.
- Внедрение CLTV требует учета рисков, проектирования устойчивой архитектуры, грамотного управления данными и коллаборации между бизнесом и ИТ.
Вопрос–Ответ (FAQ)
1) Что такое CLTV и зачем он нужен в BI и DWH?
CLTV — это ожидаемая суммарная прибыль от клиента за весь период сотрудничества. В BI и DWH CLTV используется для принятия решений по каналам маркетинга, ценообразованию, удержанию и продуктовой стратегии. Он позволяет фокусировать ресурсы на наиболее прибыльных сегментах и оптимизировать затраты на привлечение клиентов в совокупности с окупаемостью CAC.
2) Какие данные необходимы для расчета CLTV?
Необходимы данные о клиентах (идентификатор, демография), транзакционные данные (покупки, даты, суммы, товары), данные по обслуживанию (затраты на поддержку, возвраты), данные о маркетинге (каналы, кампании, скидки), а также временная метрика и стоимость денег (для дисконтирования). Важно иметь единый ключ идентификации клиента и корректно синхронизировать данные по времени.
3) Какие методы расчета CLTV наиболее часто применяются?
Простые методы: на основе общей выручки и маржи за период. Продвинутые методы: дисконтированная денежная стоимость (DCF), моделирование churn/retention, коортный анализ, survival analysis и Markov-цепи. Выбор метода зависит от доступности данных, бизнес-целей и желаемой точности прогноза.
4) Какие инструменты чаще всего используются в открытом ПО для CLTV?
PostgreSQL или ClickHouse в качестве DWH, Apache Airflow для оркестрации ETL/ELT, dbt для трансформаций, Metabase или Apache Superset для визуализации, Python (pandas, scikit-learn, lifelines) для продвинутого моделирования, Apache Spark для больших данных, DataLens как российское BI-решение для визуализации и совместного анализа.
5) Какие российские решения поддерживают расчеты CLTV и аналитику?
ClickHouse — российский проект, популярный в аналитике за счет скорости. DataLens — отечественная BI-платформа, удобная для визуализации и совместной работы над данными. Также широко используются отечественные инфраструктурные решения для хранения и обработки данных (локальные репозитории, отечественные облачные сервисы) в сочетании с открытым ПО.
6) Какие риски связаны с внедрением CLTV и как их снизить?
Основные риски: низкое качество данных, дубликаты, задержки в записи событий, несогласованность между отделами, неправильные предпосылки для дисконтирования и моделей, регуляторные ограничения по данным. Как снизить: обеспечить governance и lineage, верифицировать данные, внедрить тесты качества, использоватьSegment- и cohort-аналитику, регулярно валидировать модели на исторических данных, обеспечить соответствие защиты данных.
7) Какова роль дисконта и времени в CLTV?
Дисконтирование учитывает временную стоимость денег и риск. Future cash flows приводятся к текущей стоимости с использованием коэффициента дисконтирования. Выбор ставки дисконтирования влияет на итоговую величину CLTV, поэтому её следует обосновать финансовой политикой компании.
8) Как правильно внедрять CLTV внутри организации?
Начинать с MVP: базовый набор данных и простая CLTV-модель, которая демонстрирует ценность. Затем добавлять сегментацию, коортный анализ, churn-модели и продвинутое дисконтирование. Важно обеспечить коммуникацию между отделами: маркетинг, продажи, финансы и ИТ. Наличие единого источника данных и документированной логики расчетов критично для доверия к результатам.
9) Какие сложности возникают при хранении и обработке данных в рамках CLTV?
Сложности включают консистентность идентификаторов, синхронность событий, латентность обновления данных, обработку пропусков и аномалий, поддержание актуальности моделей, мониторинг качества данных и регулирование доступа к данным. Решение — четко заданная архитектура DWH, governance, автоматизация ETL/ELT и контейнеризация рабочих процессов.
10) Какие шаги сделать на первых неделях проекта CLTV?
- Уточнить цель и KPI CLTV, определить необходимые источники данных.
- Спроектировать модель данных в DWH (звездная схема).
- Настроить ETL/ELT-процессы и обеспечить качество данных.
- Реализовать базовый SQL/модель для расчета CLTV на первом наборе сегментов.
- Подключить BI-слой для визуализации и мониторинга.
- Провести тестирование на исторических данных и валидировать результаты.
- Запустить MVP и затем расширять функциональность по мере роста доверия к данным и потребностям бизнеса.
Дополнительные примечания по практическим шагам
- При выборе инструментов ориентируйтесь на доступность команды и требования к инфраструктуре. В российских условиях часто выгоднее сочетать ClickHouse и DataLens в локальном или гибридном облаке, чтобы обеспечить быструю аналитику и соответствие регуляторным требованиям.
- Важно обеспечить сопровождение бизнес-логики: какие скидки учитываются, как считается маржа, как обрабатываются возвраты и штрафы. Все это должно быть зафиксировано в документации и тестах.
- Мониторинг должен охватывать качество данных, стабильность пайплайнов, точность CLTV-моделей и целевые бизнес-метрики. Регулярная переоценка эффектов в стратегии marketing и продаж нужна для сохранения актуальности CLTV.
Эта глава задаёт фундаментальные принципы: CLTV — это не просто число, а система знаний о клиентах, их поведении и финансовом влиянии на бизнес. BI и DWH служат инфраструктурой для аккумулирования данных, анализа и принятия решений. Реализация требует внимательности к данным, продуманной архитектуры, выборки инструментов и координации между отделами. Владение открытым ПО и российскими решениями позволяет построить эффективные, масштабируемые решения для расчета и мониторинга CLTV, адаптивные к росту бизнеса и изменениям рынка.


