

Инструменты и стек: каталоги, шлюзы и интеграционные платформы
В условиях зрелой корпоративной data-платформы роль метрического и консистентного управления метаданными выходит на первый план. Каталоги данных становятся единым источником истинности по набору данных, пайплайнам и политике доступа, тогда как шлюзы и интеграционные платформы обеспечивают безопасную, управляемую и повторяемую интеграцию разнообразных источников и потребителей данных. Глава посвящена тому, как устроены современные инструменты и стек, какие архитектурные решения следует принимать на уровне проектов и как превратить техническое решение в устойчивый бизнес-процесс.
Понимание связок между каталогами, шлюзами и интеграционными платформами позволяет не только повысить скорость внедрения и качество метаданных, но и создать управляемую экосистему, в которой данные становятся понятными, доступными и контролируемыми для бизнес-пользователей и разработчиков.
- Архитектурные принципы взаимодействия каталогов, шлюзов и интеграционных платформ в корпоративной среде.
- Протоколы, форматы и модели обмена метаданными и данными между компонентами стека.
- Практические сценарии внедрения, типичные ошибки и способы их предотвращения.
- Вопросы безопасности, соответствия и эксплуатации на постоянной основе.
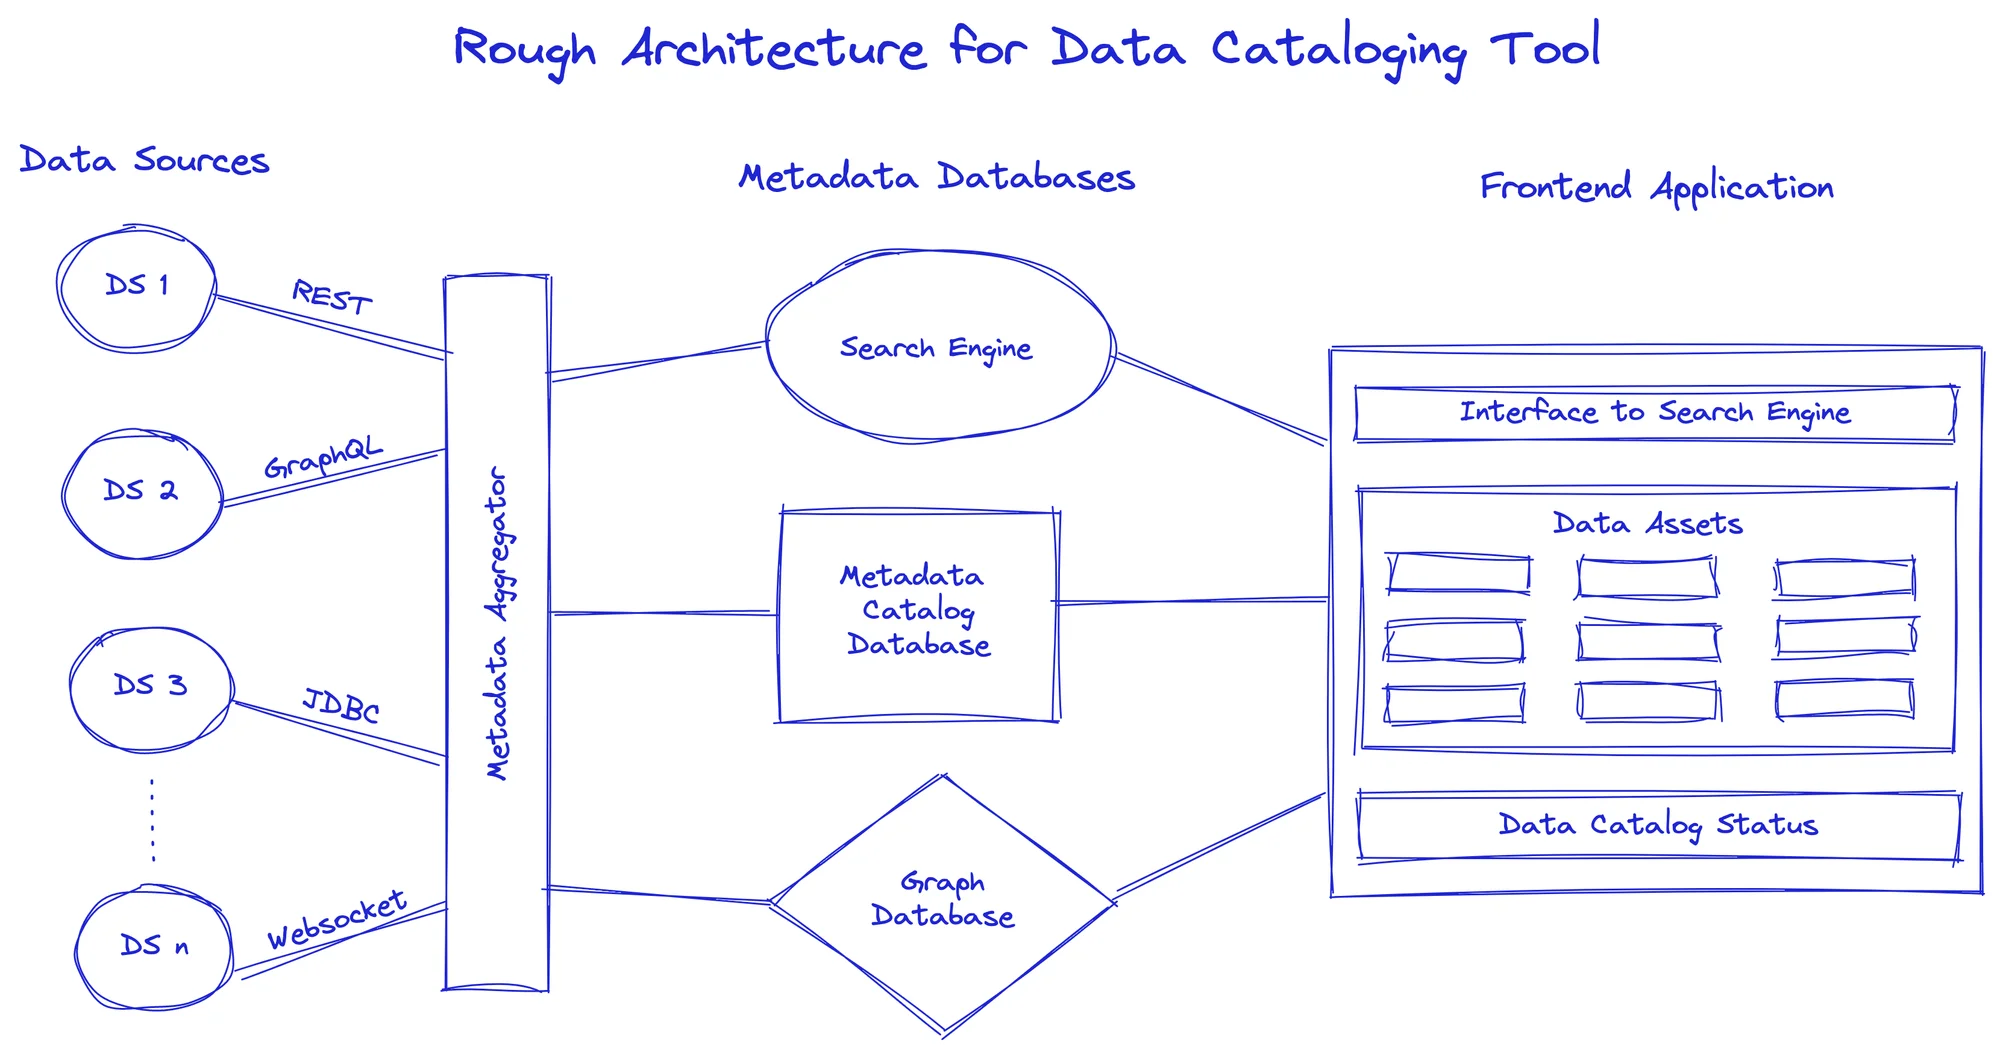
Краткое содержание главы
- Архитектура каталога данных и шлюзов: слои, роли и взаимосвязи.
- Протоколы и схемы обмена: REST/GraphQL/gRPC, модели метаданных и стандарты.
- Интеграционные паттерны и шлюзы: подключение источников, потоки данных и управление доступом.
- Эксплуатация, качество и безопасность: контроль целостности, мониторинг и соответствие требованиям.
- Архитектурные решения внедрения и типовые реализации: паттерны развёртывания, CI/CD для метаданных.
- Практические сценарии использования и кейсы внедрения.
Архитектура каталога данных и шлюзов
Современная архитектура стека для каталога данных строится вокруг трех взаимодополняющих слоев: каталог метаданных, шлюз доступа к данным и интеграционная платформа. Каталог выступает как центральный реестр, который хранит структуру и контекст объектов данных: наборы данных, таблицы, колонки, политики, владельцы и линейность данных. Шлюз доступа обеспечивает единый безопасный точек входа к источникам, применяет правила доступа и трансляцию запросов к хранилищам. Интеграционная платформа соединяет источники данных, коннекторы и пайплайны с механизмами регистрации и обновления метаданных, а также с событиями изменений.
Ключевые принципы:
- Согласованность метаданных: источник изменений должен отражаться в каталоге без задержек и ошибок.
- Расширяемость: архитектура должна поддерживать добавление новых источников, форматов и моделей данных без переработки существующей инфраструктуры.
- Безопасность и аудит: интеграция с IAM, политики доступа, журналирование действий и событий.
- Нейтральность для бизнес-пользователя: поиск, фильтры и семантика должны быть понятны без глубокого знания технических деталей.
Эта тройка слоев обеспечивает устойчивый цикл управления метаданными и данными: обнаружение источника, регистрация в каталоге, доступ через шлюз, использование в аналитических и операционных пайплайнах, затем обновление контекста и повторная синхронизация. В практических реалиях рекомендуется рассматривать как базовый каркас, который можно расширять за счёт доменных каталогов (data product catalogs) и специализированных метаданных, отражающих бизнес-области.
- Каталог данных: хранение схем, линейности, ownership, атрибутов качества и классификации данных; поддержка схем Open Metadata и собственных типов.
- Шлюз доступа: единая точка входа, обеспечение политики доступа, кэширование метаданных и маршрутизация запросов к хранилищам.
- Интеграционная платформа: коннекторы и адаптеры, управление потоками, событиями и обновлениями метаданных; поддержка обеспечения воспроизводимости и мониторинга.
Пример конфигурации для инжекции метаданных в каталог (упрощённый, для иллюстрации взаимодействий):
{
  "source": "jdbc:mariadb://db.company.local:3306/sales",
  "credentials": {"type": "secret", "vault": "k8s-secret/sales-db"},
  "schema": "public",
  "tables": ["orders","customers"],
  "metadata": {
     "owner": "data-team",
     "classification": "PII",
     "tags": ["sales","customer"]
  },
  "pollIntervalSeconds": 3600
}
В рамках открытых экосистем в качестве примеров реализации каталога можно отметить Apache Atlas и OpenMetadata. Эти решения демонстрируют подходы к типизации метаданных, наследованию политик, линейности и интеграции с внешними системами. Их использование может быть оправдано при необходимости быстрого старта в крупных организациях или когда требуется активная экосистема коннекторов и плагинов.
Протоколы и форматы обмена: схемы и стандарты
Эффективная интеграция между каталогом, шлюзами и источниками требует единых контрактов обмена и согласованных схем метаданных. В рамках архитектуры допускаются как RESTful API, так и GraphQL или gRPC-интерфейсы, в зависимости от потребностей потребителей и разработчиков. Основные принципы:
- API-уровень: REST чаще всего применяется для стандартных CRUD-операций по объектам каталога; GraphQL — для динамических запросов и отбора полей; gRPC — для высокопроизводительных сценариев и интеграции сервисов в микросервисной среде.
- Форматы данных: JSON остаётся базовым форматом для обмена «метаданных о метаданных»; для передачи больших объёмов данных применяются Avro или ORC/Parquet в контексте переноса самих наборов данных, тогда как JSON-LD может служить для семантической интерпретации сложных моделей.
- Модели метаданных: общий стандарт упирается в понятия объектов данных, их атрибутов, линейности, владельцев и политик. В открытых проектах часто встречаются типы, схожие с Open Metadata или Apache Atlas, что позволяет мигрировать данные и политики между системами.
- Обмен событиями: для поддержания синхронности между источниками и каталогом применяют события изменений через шину событий (например, Kafka). Это позволяет каталогу оперативно отражать добавление новых объектов, изменение владельца или уровня доступа.
В качестве примеров open-source экосистем для каталога можно привести Apache Atlas и OpenMetadata. Atlas хорошо демонстрирует управляемый набор предикатов и типизацию объектов, OpenMetadata — гибкую модель данных и богатый коннекторный набор. При выборе стоек важно учитывать зрелость экосистемы, наличие готовых коннекторов к вашим источникам и стратегию миграции существующих схем метаданных.
Интеграционные паттерны и шлюзы
Интеграционные паттерны применяются для упорядочения взаимодействий между различными системами в рамках каталога и источников данных. Основные подходы:
- Коннекторы и адаптеры: каждый источник подключается через коннектор, который регистрирует объект в каталоге и публикует события изменений. Архитектура должна поддерживать повторно используемые коннекторы и централизованные политики доступа.
- Потоки данных и события: потоковая передача изменений через шину событий обеспечивает скорость синхронизации и актуальность метаданных. Kafka или аналогичные решения служат основой для таких сценариев.
- Шлюз как полоса политики: шлюзы предоставляют единый контракт доступа, применяют политики, маскирование чувствительных данных и аудит действий. Они уменьшают риск прямого доступа к хранилищам.
- Виртуализация данных и иная реализация доступа: для некоторых сценариев полезна слой виртуализации, который поверх каталога позволяет пользователю запросить данные без непосредственного перемещения или копирования, сохраняя политики и контекст.
- Демонстрационные примеры: использованием NiFi как оркестратора потоков данных и коннекторов к различным источникам; Kafka — как транспорт изменений и событий. Эти инструменты широко применяются в реальных проектах и имеют богатые сообщества и плагины.
Примеры интеграционных решений:
- Apache NiFi в роли оркестратора потоков и преобразования потоков метаданных и данных между источниками, каталогом и потребителями.
- Apache Kafka как платформа для передачи событий об изменениях в наборах данных, схемах и правах доступа, что обеспечивает близкое к реальному времени обновление каталога.
Важно помнить: выбор паттернов зависит от зрелости среды, скорости изменений и требований к согласованности метаданных. В некоторых случаях целесообразно сочетать централизованный каталог с локальными доменными каталогами в рамках data mesh-подхода, сохраняя единство политики и единый поиск.
Эксплуатация, качество, безопасность и соответствие
Эксплуатация стека требует четкой постановки процессов по управлению жизненным циклом метаданных, качества и соответствия требованиям регуляторов.
- Жизненный цикл метаданных: создание, обновление, удаление и архивирование объектов; фиксация изменений, версияция и возможность отката. Важно поддерживать History и линейность изменений.
- Качество метаданных: полнота, точность, согласованность и актуальность. Введение метрик качества помогает выявлять дефициты и определять зоны ответственности. Регулярные проверки позволяют поддерживать trust в каталоге.
- Безопасность и контроль доступа: интеграция каталога и шлюзов с IAM системами, поддержка ролей и политик на уровне объектов данных; аудит действий пользователей и сервисов; маскирование чувствительных данных и соблюдение режимов минимального доступа.
- Соответствие требованиям: GDPR/РОПД или региональные регуляции накладывают требования на хранение, обработку и доступ к данным. Каталог должен поддерживать функции линейности, происхождения данных и аудит.
- Мониторинг и операционная дисциплина: сбор телеметрии по времени отклика, доступности сервисов, качеству метаданных и степени соответствия политикам. Наличие SLA на доступ к метаданным и к самим данным критически важно для бизнес-пользователей.
Вопросы дизайна безопасности и соответствия обычно решаются синергией: политики доступа, политики маскирования, аудит и автоматическое уведомление в случае изменений в правах. Рекомендована практика — разделение обязанностей между командами по инфраструктуре (обеспечение доступности и устойчивости), по безопасности (контроль доступа и аудит) и по данным (качество и семантика).
Архитектуры внедрения и примеры реализации
Учитывая потребности бизнеса и масштабы компании, реализуемые архитектуры могут варьироваться. Ниже приведены наиболее устойчивые подходы.
- Центральный каталог с локальными доменными адаптерами: единый реестр для поиска и линейности, но с возможностью регистрации специфичных для домена расширений и отраслевых метаданных. Такой подход упрощает управляемость и обеспечивает единый поиск по всей организации.
- Гибридное развёртывание (облако + дата-центр): каталог может храниться в облаке, а коннекторы — локально или через гибридные каналы, что облегчает миграцию и интеграцию с локальными источниками данных.
- Архитектура для data mesh: каждый домен имеет собственный каталог или расширение каталога, но осуществляется централизованный контроль политики и обеспечения качества на уровне всей экосистемы. Это позволяет ускорить внедрение и обеспечить локальную автономию, сохраняя общий уровень качества и соответствия.
- CI/CD для метаданных: управление изменениями метаданных через конвейеры CI/CD, использование репозитариев для описания схем, политики и тестов качества. Типичный цикл — создание изменений в Git, автоматическая валидация, тестирование и деплой в целевые окружения.
Практическая рекомендация: начните с проекта пилотного масштаба, который охватывает 1–2 домена и ограниченное число источников, затем расширяйтесь по мере уверенности в инфраструктуре и процессах. При этом стоит внедрять «постепенные» шаги: выбор каталога (с учётом совместимости с существующими источниками), выбор шлюза доступа и начальные коннекторы, настройка первоначальных политик и авторизаций, затем расширение набора метрик и правил обновления.
Небольшой пример конфигурации для CI/CD метаданных (упрощённый фрагмент, иллюстративный):
name: metadata-ci
on: [push]
jobs:
  validate:
    runs-on: ubuntu-latest
    steps:
     - name: Checkout
       uses: actions/checkout@v2
     - name: Validate metadata
       run: ./scripts/validate-metadata.sh
Этот подход помогает обеспечить повторяемость и качество внедрения, снижает риски при обновлениях и позволяет бизнес-пользователям быстро видеть изменение статуса проекта.
Примеры и сценарии использования
- Поиск и доступ к наборам данных: созданные в каталоге описания должны позволять бизнес-пользователям находить наборы по функциональным признакам, владельцам, уровням доступа и классификации.
- Управление политиками доступа: через шлюз применяются политики минимального доступа и маскирование, что обеспечивает защиту чувствительных данных даже в рамках корпоративной аналитики.
- Управление качеством и происхождением данных: линейность данных и происхождение (origin) поддерживаются на уровне метаданных, что позволяет устанавливать контракты между поставщиком и потребителем данных.
- Интеграция с пайплайнами: коннекторы и каталоги должны синхронизировать контекст данных и факторы качества с пайплайнами, чтобы регламентировать, какие данные допускаются к аналитическим проектам.
- Эволюционная архитектура: вместо монолитного решения целесообразно рассматривать модульную архитектуру, где добавление новых источников и новых доменов не приводит к изменению существующих компонентов.
Эти сценарии ясно показывают, как связка каталогов, шлюзов и интеграционных платформ превращается в управляемый поток метаданных и данных, улучшающий время реакции бизнеса на изменения и уменьшающий операционные риски.
Key takeaways
- Каталог данных, шлюзы и интеграционные платформы образуют устойчивый каркас для управления метаданными, безопасного доступа и эффективной интеграции источников.
- Архитектура должна обеспечивать согласованность метаданных, расширяемость и безопасность, с явной ролью линейности данных и аудита.
- Протоколы и форматы обмена должны опираться на REST/GraphQL/gRPC, современные форматы сериализации и общие модели метаданных, такие как Open Metadata и Apache Atlas.
- Интеграционные паттерны включают коннекторы, потоковую передачу изменений через шину событий и шлюзы, которые применяют политики доступа и маскирования.
- Выбор архитектуры внедрения зависит от зрелости организации: централизованный каталог, гибридное развёртывание или data mesh с единым контролем политики.
- CI/CD для метаданных и автоматизированные правила качества улучшают воспроизводимость внедрений и качество данных.
- Важна непрерывная работа по безопасности, аудиту и соответствию требованиям регуляторов.
FAQ
1. Какие факторы влияют на выбор архитектуры каталога в крупной организации?
- Выбор зависит от масштабируемости, скорости изменений, требований к единому поиску и политик доступа, а также от готовности внедрять data mesh или централизованный подход. Централизованный каталог упрощает контроль и аудит, но может быть менее агильным. Data mesh позволяет доменам работать автономно, оставаясь под едиными политическими стандартами. В реальных условиях часто выбирают гибрид: единый верхний каталог с доменными адаптерами и локальными каталогами.
2. Какие паттерны обмена метаданными являются наиболее устойчивыми?
- Наиболее устойчивы паттерны, сочетающие REST/GraphQL API для CRUD-операций по метаданным, события изменений через шину (Kafka или аналог) и коннекторы к источникам. Такой подход обеспечивает как синхронность, так и асинхронность обновлений метаданных, что снижает задержки и повышает надёжность.
3. Как обеспечить безопасность и соответствие в контексте каталога и шлюза?
- Интегрируйте каталог с IAM-системами, применяйте роли и политики доступа на уровне объектов, используйте маскирование чувствительных данных, аудиты и отслеживание действий. Регулярно проводите проверки соответствия требованиям регуляторов и поддерживайте процедуры реагирования на инциденты.
4. Какие примеры технологий стоит рассмотреть в рамках «интеграционных паттернов»?
- В качестве открытых решений можно рассмотреть Apache NiFi как оркестратор потоков и коннекторов, и Apache Kafka как платформу для передачи изменений и событий. Также полезны Open Metadata или Atlas как примеры архитектур метаданных и полей. Выбор делается в зависимости от того, как глубоко интегрируются источники и какой уровень гибкости нужен для управления метаданными.
5. Как организовать качественный цикл жизненного цикла метаданных?
- Введите процессы создания, обновления, валидации и устаревания метаданных с автоматическими тестами на полноту, точность и согласованность. Внедрите политики версионирования и возможность отката. Включите тестирование прав доступа и согласование изменений с бизнес-владельцами.
6. Какие метрики помогут оценить эффективность каталога и шлюзов?
- Время до обнаружения изменений, доля актуальных записей, процент полноты метаданных, уровень соответствия политикам доступа, число incident-ов связанных с доступом, время отклика API каталога, процент ошибок в процессе миграций и обновлениях.
7. Какой минимальный набор компонентов обеспечивает работоспособность стека?
- Каталог метаданных, шлюз доступа, интеграционная платформа с коннекторами к ключевым источникам, шина событий или API-слой для обновления, базовый набор политик доступа и средства аудита. Разумеется, по мере роста потребуется расширение коннекторов и внедрение дополнительных доменных каталогов.
8. Какие риски и антипаттерны стоит избегать?
- Излишняя монолитность каталога без гибкости к новым источникам, недооценка требований к безопасности и аудиту, отсутствие автоматизации в обновлениях метаданных, игнорирование жизненного цикла и качества. Рекомендуется начинать с пилотного проекта и постепенно расширять охват, сохраняя единый контракт обмена данными и политики.
9. Как организовать перенос существующих наборов данных в каталог?
- Определите приоритеты по бизнес-ценности и риски; зафиксируйте единый модельный набор метаданных; используйте коннекторы для миграции, сохраняя линейность и контекст. Введите этап проверки качества миграции и аудит изменений. Хорошим подходом является постепенная миграция по доменам с параллельной работой старой и новой инфраструктуры до полного перехода.
10. Какие практики ускоряют внедрение и снижают риск?
- Начинайте с пилотного сценария, ограниченного количеством источников и доменов; используйте готовые коннекторы и типовые схемы метаданных; внедряйте автоматизированный QA и CI/CD для метаданных; активно привлекайте бизнес-партнёров для валидации семантики и политики доступа. Постепенно усиливайте архитектуру, добавляя новые домены, источники и правила, сохраняя единый стандарт.
Глава предложила сбалансированное представление архитектурных принципов, паттернов интеграции и практик эксплуатации с учётом корпоративной зрелости и требований к качеству метаданных и безопасности. Принимая решение, руководствуйтесь реальным контекстом вашей организации: масштабами данных, скоростью изменений, уровнем регуляторной нагрузки и готовностью к переходу на новые принципы управления данными.


