

Управление данными для признаков: качество, линейность, ответственность
Краткое введение
Управление признаками - это не только сбор и хранение отдельных значений. Это комплексная практика обеспечения качества признаков, их прослеживаемости (линейности происхождения) и ответственности за использование данных на протяжении всего цикла жизни модели - от разработки до эксплуатации. В контексте Feature Store такие аспекты становятся критическими: некачественные признаки приводят к ухудшению качества моделей, отсутствие линейности происхождения затрудняет аудит и соответствие требованиям регуляторов, а слабая ответственность превращает управление данными в хаотичный процесс без устойчивых контрактов и версий. Эта глава развивает концептуальные основы и практические решения для эффективного управления данными признаков: методологии текущего и будущего поколения, архитектуру и технологическую реализацию, организационные роли, примеры реальных кейсов и подробные технические детали.
Введение
Цель данной главы - выстроить системную модель управления данными признаков: от их определения и качества до прослеживаемости и ответственности за использование. Мы рассмотрим, какие именно характеристики данных нужны для надежной эксплуатации признаков в обучении и онлайн-применении, какие механизмы контроля необходимы для обеспечения чистоты данных и недопущения утечек, а также как это реализуется в современных архитектурах Feature Store. В рамках курса мы увидим:
- как определить требования к качеству признаков и какие метрики для этого применяют;
- как обеспечить линейность происхождения признаков: от источников к обучению к сервисам онлайн-применения;
- как сформировать договоры данных (data contracts) и процедуры аудита;
- какие архитектурные решения применяются в open-source и российских платформах;
- какие риски и типичные ошибки возникают и как их минимизировать.
Теоретические основы и терминология
- Признак (Feature): конкретная характеристика объекта предметной области (например, пользовательский возраст, сумма последнего платежа, частота визитов). Признаки могут быть как статическими, так и временными (тайм-вью).
- Feature Store: централизованное хранилище признаков, обеспечивающее хранение, версионирование, версионную совместимость и доступ к признакам как на стадии обучения, так и в онлайн-пайплайне.
- Online vs Offline stores:
- Offline store: хранилище признаков для обучения (например, Parquet/ORC в дата-луже) с высокой емкостью и воспроизводимостью.
- Online store: низкая задержка для онлайн-обработки (например, Redis, RocksDB) для рекомендаций, скоринга в реальном времени.
- Data lineage (прослеживаемость, линейность происхождения): полный путь признака от источников данных до обучающей выборки и онлайн-использования, включая все преобразования и версии. Ключевые аспекты: источники, преобразования, версия, время актуальности.
- Data quality (качество данных): совокупность характеристик признаков - полнота, точность, своевременность, непротиворечивость, корректность типов и единиц измерения, устойчивость к дрейфу и аномалиям.
- Data contracts (контракты данных): формальные соглашения между сторонами (источниками, инженерами признаков, командами ML) о форматах, валидности и ограничениях признаков.
- Governance и аудит: механизмы доступа, журналирования изменений, контроль версий, требования соответствия (регуляторика, приватность).
- Версионирование признаков: поддержка нескольких версий одного признака, чтобы обеспечить воспроизводимость экспериментов и телеконстантность обучения.
Методологии и подходы
- Контракты данных и контрактная проверка признаков:
- Определение структуры и правил валидности признаков (типы, диапазоны значений, уникальность, ограничение по времени).
- Обеспечение совместимости версий: каждый признак имеет уникальный идентификатор, версию и действенный диапазон.
- Контроль качества признаков:
- Метрики качества: полнота (missingness), точность, согласованность, timeliness, drift-detection по признакам и по распределениям между обучением и продакшеном.
- Инструменты: целевые валидаторы и скрипты проверки, интегрированные в пайплайны.
- Линейность происхождения (lineage) как основа аудита:
- Включение полного цепочки: источник -> этапы преобразования -> версия -> обучающая выборка -> онлайн-использование.
- Использование стандартов и протоколов (OpenLineage, Apache Atlas, Amundsen) для отображения графа родословной признаков.
- Версионирование и управление изменениями:
- Обеспечение иммутабельности признаков: новые версии создаются вместо изменения существующих.
- Управление зависимостями: как изменение одной версии влияет на обучающие пайплайны и онлайн-применение.
- Безопасность, доступ и ответственность:
- Ролевое моделирование доступа (RBAC/ABAC) к признакам; аудит операций.
- Защита персональных данных и приватности признаков; минимизация копий данных.
- Интеграция с пайплайнами обучения:
- Внедрение Data Contracts в процессы подготовки данных и обучения.
- Контроль качества и линейность в рамках CI/CD для ML.
- Обеспечение воспроизводимости экспериментов.
Архитектура и технологическая реализация
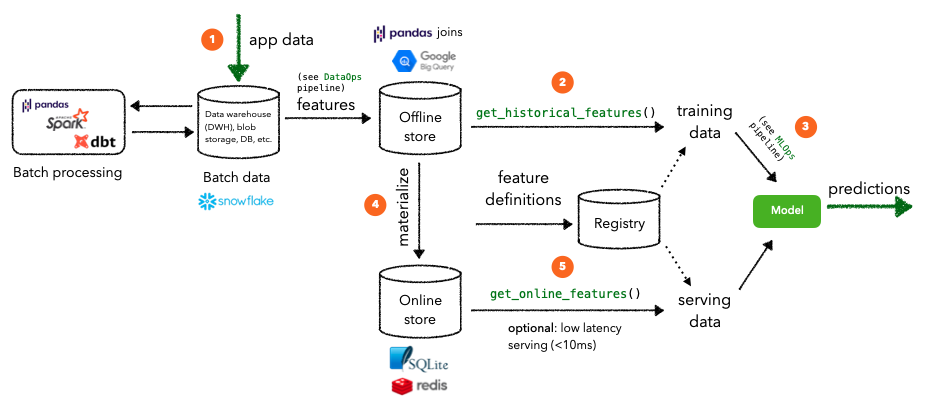
Ключевые компоненты архитектуры управления признаками:
- Источники данных и Data Lake/Warehouse:
- Базы данных операционного уровня, логи, события, ленты де-сьюжетинга и т.д.
- Генераторы признаков (Feature Engineering):
- Пайплайны ELT/ETL, которые формируют признаки и сохраняют их в офлайн-Store.
- Feature Store (централизованный регистр признаков):
- Registry/каталог признаков, поддержка версий, модели доступа.
- Слои online/offline store с согласованием версии и задержек.
- Контракты и валидация признаков:
- Модуль контрактов, валидаторы и тесты признаков, интегрированные в пайплайны.
- Логирование и аудит (Data Governance):
- Журналы изменений, доступов, заметки по качеству, ошибки.
- Линейность и прослеживаемость (Lineage):
- Интеграция с OpenLineage, Atlas/Amundsen, визуализация графа происхождения признаков.
- Контроль доступа, безопасность и соответствие:
- RBAC/ABAC, аудит доступа, шифрование, минимизация копий.
- Мониторинг и оповещение:
- Валидаторы качества, Drift-девиции, SLA по онлайн-ответу для признаков.
- Инструменты оркестрации и среды разработки:
- Airflow, Dagster, Kedro, Kubeflow Pipelines; интеграции с GitOps.
Ниже пример концептуальной схемы (упрощенная диаграмма в текстовом виде):
- Источники данных -> Генераторы признаков -> Offline Store, Registry -> Online Store
- Registry взаимодействует с OpenLineage для линейности
- Контракты данных и Quality Validators запускаются на этапе ingest
- Обновления версий признаков уведомляются через систему уведомлений
Технологические решения и примеры реализации
Open-source решения:
- Feast (Feature Store): поддерживает онлайн/offline хранилища, регистр признаков, версии и интеграцию с пайплайнами обучения. Пример кода позже в разделе «Технические детали реализации».
- Hopsworks Feature Store: интегрированная платформа с фокусом на управление признаками, мониторингом и линейностью происхождения, хорошая поддержка с/OpenLineage и UI.
- Kubeflow/ML платформы с компонентами feature store: интеграция с Dagshub, Kubeflow Pipelines, OpenLineage.
Российские решения и примеры архитектур:
- Яндекс DataSphere (российское решение) предлагает функциональность для ML-платформ, включая управление признаками, датасетами и обработку данных, с акцентом на интеграцию в экосистему Яндекс и локализацию требований к приватности и регуляторике.
- Архитектурные примеры внутри крупных российских организаций: собственные feature-store решения, встроенные в MLOps-платформы на базе OpenLineage, Apache Atlas или Amundsen, адаптированные под локальные правила хранения данных и требования к аудитам. В таких кейсах часто присутствуют собственные конвейеры и сервисы валидации признаков, классификация доступа и инструменты мониторинга.
- Примеры кейсов на практике: внедрение контрактов данных и версионирования признаков в рамках fraud-подсистем, рекомендаций и прогнозирования спроса, где данные проходят через офлайн-слой и онлайн-слой с синхронными и асинхронными обновлениями признаков.
Практические примеры и кейсы
Пример 1. Open-source кейс: Feast в реальном пайплайне ML
Контекст: онлайн-рекомендации в e-commerce стартапе. Необходимо быстро и безопасно использовать признаки как в обучение, так и в онлайн-сценарии, с контролем качества и прослеживаемостью.
Архитектура:
- Источник данных: журналы кликов и покупок, база клиентов.
- Offline store: Parquet-бэкенд на Data Lake.
- Online store: Redis для низкой задержки.
- Registry: Feast Registry (SQLite/PostgreSQL).
- Контракты данных: определены через набор тестов в Great Expectations.
- Валидаторы качества: набор проверок на полноту, диапазоны и drift.
- Линейность: OpenLineage записывает путь от источника к признаку и обучающей выборке.
- Мониторинг: Prometheus/Grafana, алерты на drift и нарушение контрактов.
Пример кода:
# Feast: определение сущностей и признак-вью from feast import Entity, Feature, FeatureView, ValueType from datetime import timedelta from feast import RepoConfig, FeatureStoreОпределение сущности
customer = Entity(name="customer_id", value_type=ValueType.INT64, description="Unique customer")
Определение признаков (FeatureView)
customer_features = FeatureView( name="customer_features", entities=["customer_id"], ttl=timedelta(days=7), features=[
Feature(name="age", dtype=ValueType.INT64),
Feature(name="num_logins_last_7d", dtype=ValueType.INT32),
Feature(name="avg_purchase_value_last_30d", dtype=ValueType.FLOAT), ], online=True, )
Конфигурация репозитория и пайплайна
registry хранит версии признаков; online_store - Redis; offline_store - Parquet/Delta
config = { "project": "retail", "registry": "data/registry.db", "provider": "local", "online_store": {"type": "redis", "connection": "redis://localhost:6379"}, "offline_store": {"type": "parquet", "path": "data/feature_store/offline"}, }
Пример использования
fs = FeatureStore(repo_path=".") entity_df = fs.get_online_features( features=["customer_features: age", "customer_features: num_logins_last_7d"], entity_rows=[{"customer_id": 123}, {"customer_id": 456}], )
Методы и вывод:
- Признаки доступны онлайн и оффлайн синхронно; версии признаков сохраняются в регистри.
- Контракты данных обеспечиваются через тесты на уровне пайплайнов; drift-детекция интегрирована через Great Expectations.
- Линейность непрерывно отслеживается через OpenLineage: источники -> преобразования -> признаки -> обучающие данные.
Пример 2. Российское решение на базе Яндекс DataSphere
Контекст: банковское мошенничество и скоринг клиентов. В рамках локализации требований к приватности внедряется собственный слой признаков, связанный с доступами на уровне продуктов и регионов.
Архитектура:
- Источники данных: внутренние БД клиентов, логи операций.
- Data Lake: локальный хранилище с контролируемым доступом.
- Feature Store: реализуется с совмещением регистров признаков и "online" слоя для скоринга в реальном времени.
- Линейность: прослеживаемость в OpenLineage, интеграция с Atlas/Amundsen как каталогом данных.
- Контракты: формальные правила валидности признаков, соответствие требованиям к приватности.
- Безопасность: RBAC по ролям и территориям, аудит изменений, журналирование.
Практическая ценность:
- Быстрое развертывание новых признаков.
- Прозрачная прослеживаемость тех преобразований, которые применялись к признаку.
- Контроль доступа к признакам по регионам и ролям, чтобы ограничить просмотр чувствительных признаков.
Ключевые выводы:
- Российские платформы применяют гибридный подход: открытые инструменты в сочетании с локальными модулями для регуляторной и приватности.
- Важно обеспечить не только качество признаков, но и прозрачность происхождения и доступ.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Качество признаков
- Метрики качества: полнота (completeness), точность (accuracy) по известной выборке, согласованность (consistency) между источниками, timeliness (свежесть) признаков.
- Валидаторы:
- Диапазоны значений и типы (schema validation).
- Проверка на дубликаты и уникальность.
- Drift-девиции по распределениям между обучением и продакшеном.
- Инструменты: Great Expectations, TFX Data Validation, Pydantic для контрактов данных.
- Линейность происхождения (Lineage)
- Архитектурные подходы:
- Регистрация признаков и версий в Registry.
- Ведение графа lineage через OpenLineage, Apache Atlas или Amundsen.
- Визуализация цепочек: источники -> преобразования -> признак -> обучающая выборка -> онлайн.
- Примеры реализации:
- OpenLineage: интеграция с Airflow/Kedro Dagster для захвата метаданных.
- Атлас как каталог метаданных и регистр изменений.
- Пример схемы регистрации признаков:
- Идентификатор признака: feature_id
- Версия: v1, v2
- Источник: raw_table
- Преобразования: pipeline stages, их параметры
- Применение: обучающая выборка, онлайн-скоринг
- Важность: возможность ретроспективного анализа влияния изменений в признаке на качество моделей и воспроизводимость экспериментов.
- Версионирование и управление изменениями
- Иммутабельность признаков: новые версии создаются при изменениях; существующие версии остаются доступными для воспроизведения.
- Контроль зависимостей: изменение одного признака может повлиять на зависимые признаки и обучающие пайплайны; необходимо поддерживать граф зависимостей.
- Механизмы отката: быстрый возврат к предыдущей рабочей версии признаков и пайплайнов.
- Тестирование версий: регрессионные тесты на новых версиях.
- Интеграция с пайплайнами обучения
- Data contracts в пайплайнах: формальные контракты, которые документируют форматы и допустимые значения признаков.
- Валидация на инжесте: перед загрузкой признаков в offline/online-слои выполняются проверки.
- Мониторинг изменений: drift и качество признаков в продакшене, авто-оповещения.
- Встраивание в CI/CD: тесты на качества признаков в пайплайнах обучения, автоматизация разворачивания новых версий.
- Безопасность, доступ и аудит
- RBAC/ABAC: права на доступ к конкретным признакам и версиям, по ролям и атрибутам.
- Аудит действий: запись изменений в регистр признаков, доступ к признакам, экспорт данных.
- Приватность: минимизация копий данных в онлайн-слоях; использование псевдонимов и агрегатов для неразглашения чувствительных значений.
- Инструменты и протоколы интеграции
- HTTP/gRPC API для доступа к признакам и метаданным.
- Протоколы обмена метаданными: OpenLineage, ML Metadata.
- Стратегии интеграции с оркестраторами: Airflow, Dagster, Kubeflow Pipelines.
- Примеры интеграций: эти инструменты поддерживают обмен событиями об обновлениях признаков, дефолтных значениях и версиях.
Риски, ограничения и типовые ошибки
- Дрейф признаков: распределения признаков меняются со временем, что может снизить качество обученных моделей. Решение: Drift-девиции и регулярная переобучаемость; уведомления, обновления контрактов.
- Неправильное версияing и путаница: отсутствие строгих контрактов может привести к расходованию времени на восстановление воспроизводимости.
- Неправильная прослеживаемость: без полного lineage трудно определить источник ошибок и влияние изменений.
- Ошибки доступа и утечки: неправильные настройки RBAC могут привести к раскрытию чувствительных признаков.
- Непостоянство онлайн-слоя: несогласованность между online/offline store может привести к расхождению признаков во времени.
- Сложности с приватностью: признаки, которые содержат чувствительные данные, требуют дополнительных слоев шифрования и приватности.
Перспективы развития направления
- Serverless и квазиизбыточные компоненты: управление признаками с масштабируемостью и минимальным обслуживанием.
- Расширенная поддержка приватности и федеративного обучения: возможность использования признаков из разных учреждений без прямого обмена данными.
- Расширенные контракты данных: более формальные договоры о качестве и согласованности признаков.
- Автоматизация версий и откатов на уровне пайплайнов и онлайн-платформы.
- Интеграции с большими каталогами данных и расширенными инструментами мониторинга.
- Расширение эко-системы российских решений: усиление поддержки локальных регуляторных требований и интеграций с Яндекс DataSphere и аналогами.
Заключение
Управление данными признаков - это фундаментальная часть архитектуры ML-решений. Оно обеспечивает качество, воспроизводимость и доверие к моделям: признаки должны быть корректными, их происхождение - прослеживаемым, а ответственность - понятной для бизнес- и IT-команд. В условиях растущей сложности пайплайнов и требований к слушанию регуляторики, практическая реализация контрактов данных, контроль версий и прослеживаемости признаков становится ключевым конкурентным преимуществом. Реализация таких принципов требует согласованности между методологией, архитектурой, инструментарием и организацией процессов.
FAQ (вопросы и ответы)
Что такое контракт данных и зачем он нужен в управлении признаками?
Контракт данных - это формальное соглашение между командами разработчика признаков и потребителями признаков (учебных моделей/приложений) о формате данных, ограничениях по значениям и времени актуальности. Он обеспечивает согласованность между источниками данных и теми, кто использует признаки, предотвращает неожиданные ошибки в обучении, облегчает аудит и регуляторику.
Какую роль играет линейность происхождения в регуляторных требованиях?
Линейность происхождения обеспечивает прозрачность цепочки данных - от источников до онлайн-использования признака. Это критично для аудита, объяснимости моделей и соблюдения приватности. В случае инцидента можно быстро определить источники изменений и влияние на модель.
Какие метрики качества признаков наиболее важны на практике?
Полнота (missingness) и корректность типов данных.
Действительность диапазонов значений и единиц измерения.
Timeliness - насколько данные актуальны.
Drift-девиции - изменение распределения признаков со временем.
Непротиворечивость между offline и online представлениями признаков.
Как избежать типовых ошибок при внедрении feature store?
Определить четкие контракты и версии признаков с immutability.
Встроить валидаторы качества на каждом этапе ingest.
Обеспечить полноту линейности происхождения через регистр и OpenLineage.
Настроить RBAC/аудит и приватность признаков.
Внедрить механизмы мониторинга и уведомления о дрейфе и нарушениях контрактов.
Какие открытые инструменты можно использовать для реализации?
Feast - open-source feature store с поддержкой онлайн/offline хранения и версий.
Hopsworks Feature Store - платформа с управлением признаками и линейностью.
OpenLineage, Apache Atlas/Amundsen - инструменты для прослеживаемости и каталогов данных.
Great Expectations - инструмент для контрактов и валидаторов качества.
Какие российские решения применимы к управлению признаками?
Яндекс DataSphere - российское решение для ML-платформ, включающее функциональности для управления признаками, дата-слоями и регуляторикой.
Архитектуры в крупных российских организациях часто используют гибридный подход: открытые инструменты в сочетании с локальными модулями для регуляторной и приватности, что позволяет адаптироваться под требования локального рынка.
Чем отличается онлайн-Store от офлайн-Store в контексте качества и линейности?
Offline-store ориентирован на обучение и хранение более полного набора признаков, устойчив к задержкам и позволяет делать повторные вычисления. Online-store - нужны низкие задержки для онлайн-скоров; качество признаков в онлайн-слое должно соответствовать offline-слою, иначе возникает когнитивное расхождение и деградация качества модели.
В рамках линейности происхождения онлайн-слой и офлайн-слой должны быть синхронизированы с учётом времени актуальности признаков и версий.
Как обеспечить безопасность и приватность признаков в рамках Feature Store?
Ролевой доступ (RBAC) и атрибутный доступ (ABAC) к признакам и версиям.
Шифрование данных в покое и в передаче.
Минимизация копий данных в онлайн-слое; использование агрегаций и псевдонимов.
Мониторинг доступа и аудит изменений.
Какие практические шаги можно предпринять для начала внедрения управления признаками?
Определить набор основных признаков и их версии, сформировать начальные контракты данных.
Реализовать офлайн-слой и онлайн-слой с базовым регистром признаков.
Встроить валидаторы качества и drift-девицию.
Включить OpenLineage для линейности и вести журнал изменений.
Постепенно расширять набор признаков и интегрировать дополнительные проверки.
Какие будущие направления будут влиять на управление признаками в ближайшие 3-5 лет?
Расширение функциональности приватности и федеративного обучения.
Расширение автоматизации контрактов данных и метрик контроля качества.
Расширение поддержки локальных российских решений и соответствие регуляторике.
Более тесная интеграция feature store с каталогами данных и управлением доступами в единых платформах.
Приложения и дополнительные материалы
- Пример конфигурации Feast (feature_store.yaml) и базовый Python-скрипт для определения признаков (см. код выше).
- Пример конфигурации OpenLineage и интеграции с Airflow.
- Руководство по внедрению Great Expectations для контрактов данных.
- Руководство по безопасному доступу и аудиту для признаков: RBAC/ABAC, журналы, политики хранения.
Приложение A. Таблица сопоставления: характеристики качества признаков и техники их обеспечения
- Качество признаков: полная валидность, точность, единицы измерения.
- Линейность происхождения: источники -> преобразования -> признаки, версия, время актуальности.
- Контракты данных: формат, ограничения, валидаторы.
- Версионирование: иммутабельность, зависимость между версиями.
- Безопасность: RBAC/ABAC, аудит, приватность.
Приложение B. Пример процессов внедрения управления признаками в организации
- Шаг 1: Определение ключевых признаков, владельцев и контрактов.
- Шаг 2: Разработка архитектуры онлайн/offline, регистрации признаков и lineage.
- Шаг 3: Внедрение валидаторов качества и drift-девиции.
- Шаг 4: Интеграция с пайплайнами обучения, тестирование на воспроизводимость.
- Шаг 5: Мониторинг, аудит и расширение набора признаков.
Заключение (повторение ключевых идей)
Эффективное управление данными для признаков - это не только технологическая задача, но и управленческая. Ключ к устойчивым ML-решениям лежит в ясности контрактов, надежной прослеживаемости и надежной системе ответственности за данные. В рамках Feature Store такие принципы становятся частью инфраструктуры, объединяющей инженеров данных, аналитиков, архитекторов и руководителей data-направлений. Реализация требований к качеству, линейности и ответственности позволяет достичь воспроизводимости экспериментов, устойчивости к дрейфу и долгосрочной управляемости моделей в условиях реального бизнеса.
Feature Store становится важным элементом зрелой AI-платформы, позволяя масштабировать разработку моделей, управлять признаками и повышать повторное использование данных в ML-проектах.
Узнайте, как внедрить искусственный интеллект для бизнеса от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до создания AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в бизнес-процессы компании.


