

Практические кейсы внедрения CI/CD для ML: финансы и банки
Краткое введение
- В финансовом секторе требования к качеству данных, прослеживаемости и аудиту возрастают в разы. Внедрение CI/CD для ML позволяет превратить эксперименты в управляемые конвейеры, где данные, модели и инфраструктура проходят повторяемые проверки на каждом этапе. Эта глава объединяет теоретические основы и практические кейсы, показывая, как организовать надежные CI/CD-процессы в банках и финтех-компаниях, где важна скорость вывода моделей на производство без потери контроля и комплаенса.
Введение
CI/CD для ML (MLOps) - это не просто набор скриптов и пайплайнов. Это культурно-организационный подход, который обеспечивает:
- воспроизводимость и прослеживаемость обучающих конвейеров;
- автоматическое тестирование данных и моделей на каждом шаге;
- управляемую миграцию и развёртывание моделей в продакшен;
- мониторинг, детекцию дрейфа и обратную связь для быстрого исправления ошибок.
Финансы и банки предъявляют специфические требования к данным, безопасности и соответствию регуляторным нормам. В этой главе мы рассматриваем практические кейсы внедрения CI/CD для ML в банковском контексте, анализируем архитектурные решения, инструменты и риски, приводим конкретные примеры реализации как на открытых, так и на российских платформах.
Теоретические основы и терминология
- CI (Continuous Integration) и CD (Continuous Deployment/Delivery) для ML: объединение верифицированных артефактов (данных, признаков, моделей) в единый процесс выпуска.
- MLOps: дисциплина, соединяющая Data Engineering, ML-инженерию и DevOps для единых конвейеров разработки, тестирования и развёртывания ML-систем.
- Артефактная версия: данные, признаки, обучающие наборы, модели, конфигурации, окружения (ENV-репозитории), чемпионы версий.
- Data validation (проверка данных): набор тестов и правил для гарантирования качества и полноты входных данных перед обучением.
- Feature store: хранилище признаков для повторного использования и согласованного обучения и инференса.
- Model registry: реестр версий моделей, окружений и характеристик, позволяющий контролировать выпуск (canary, blue/greenDeployment, A/B-тестирование).
- Гигиена инфраструктуры: повторяемые образы, тестовые окружения, GitOps, инфраструктурный код (IaC).
- Регуляторика и аудит: трассируемость изменений, журналы изменений, согласование политик доступа, защита персональных данных (PII/PCI-DSS), соответствие требованиям регуляторов.
Методы и подходы
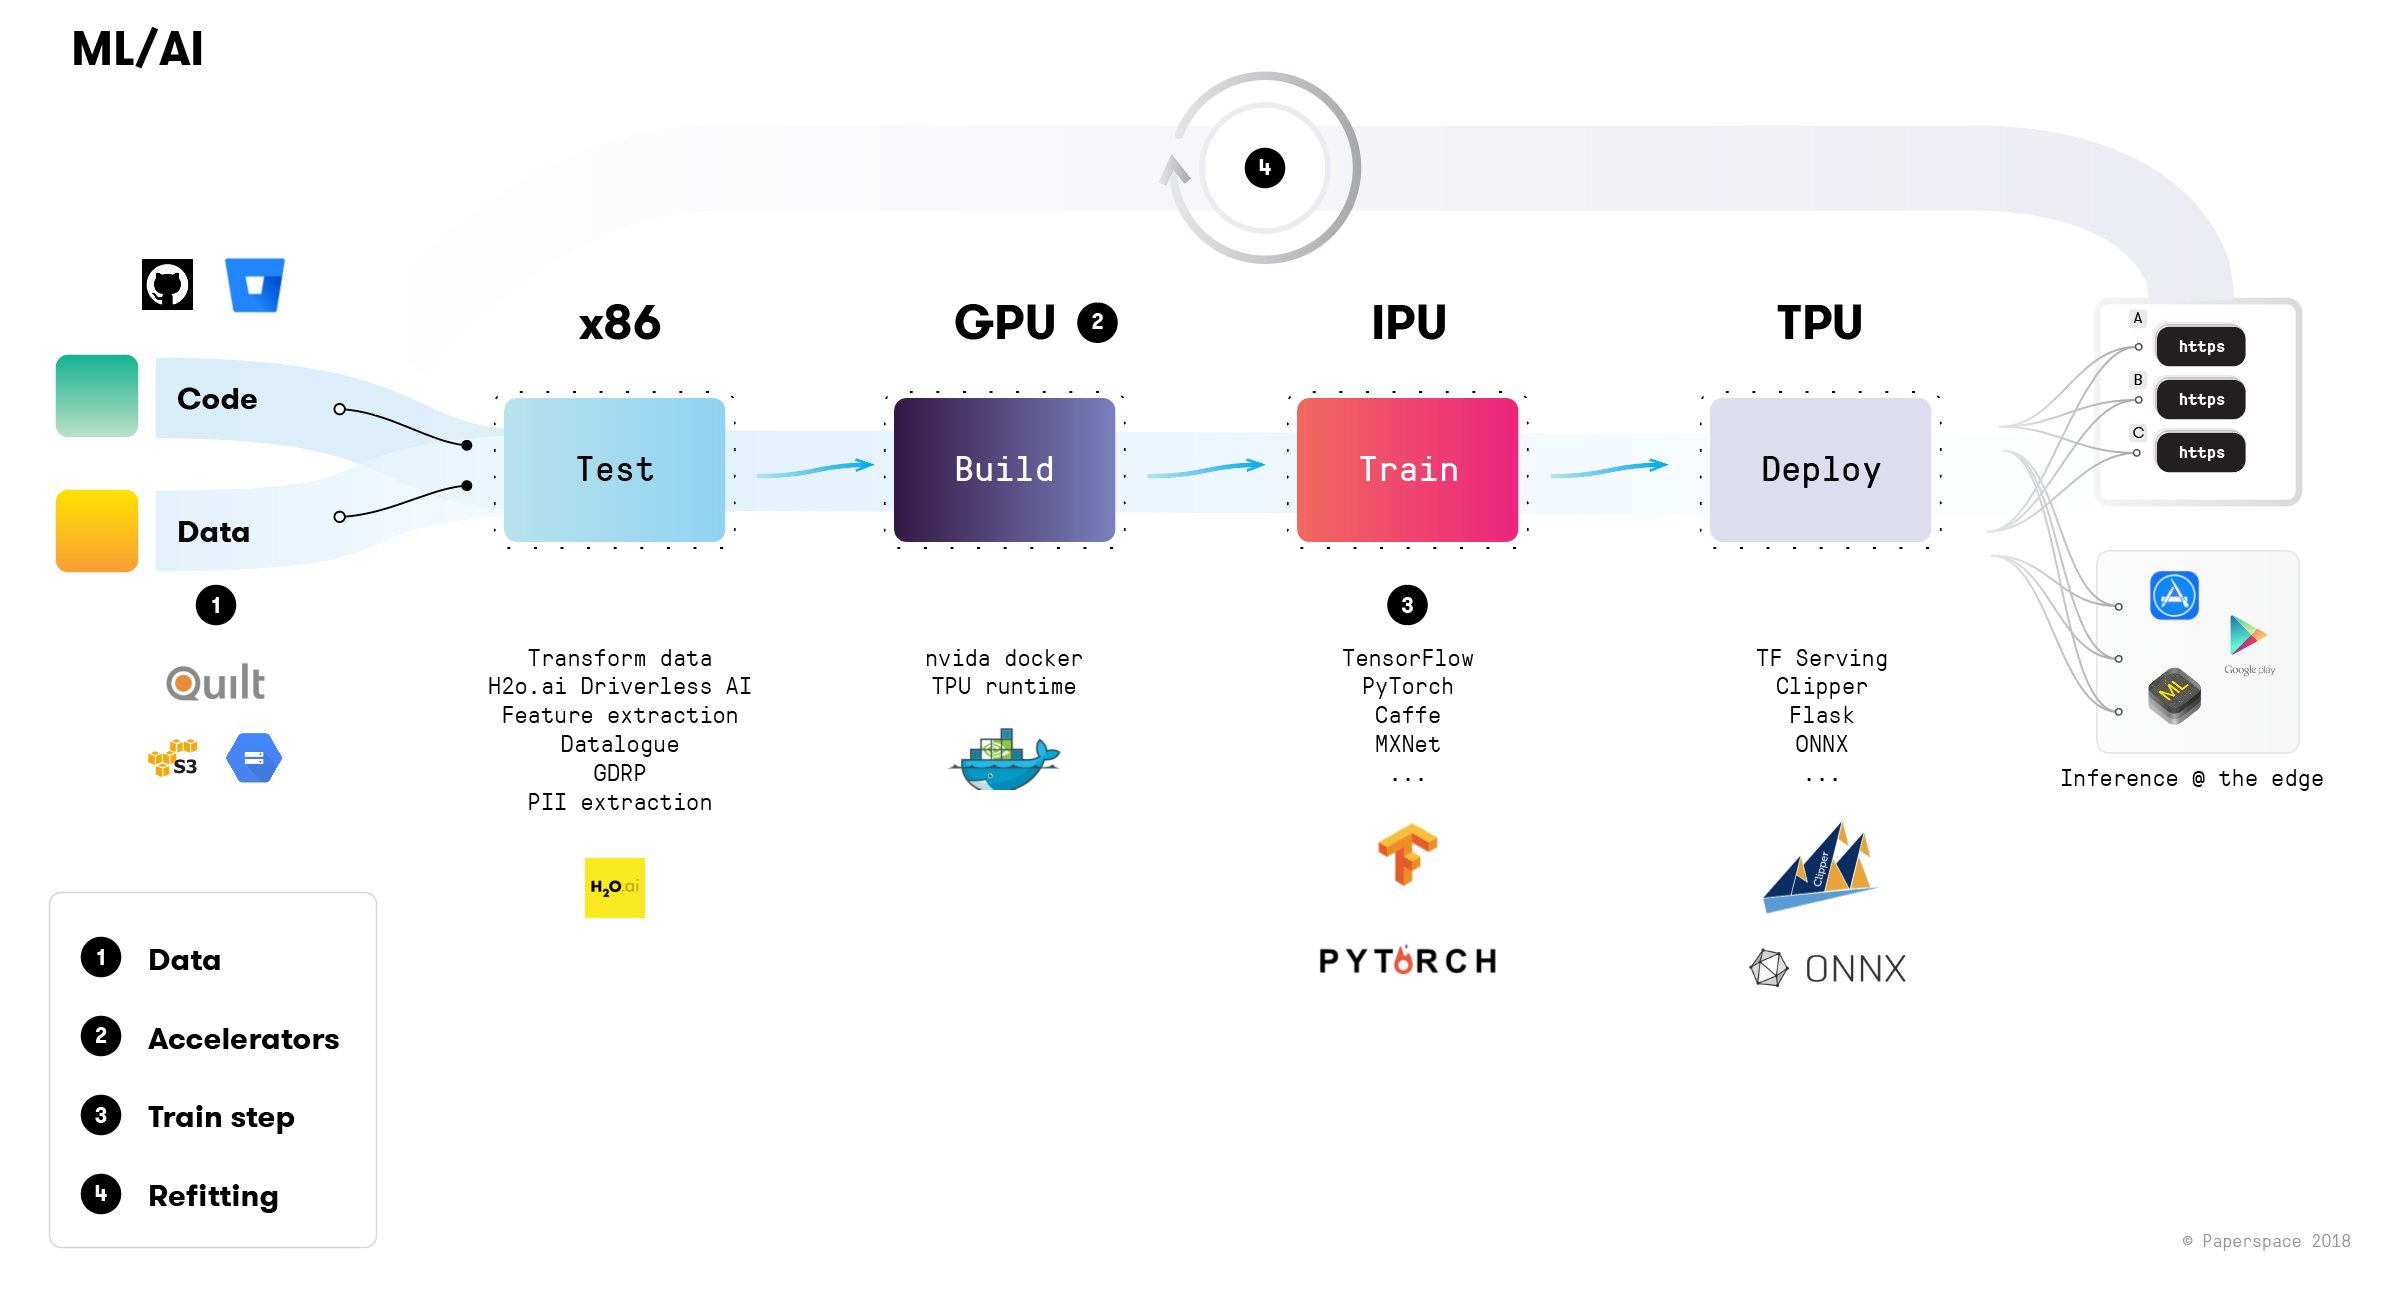
- Конвейеризация на каждом уровне: данные → признаки → обучение → оценка → развёртывание → мониторинг.
- Data-first подход: тестирование и валидация данных до обучения; предотвращение утечки данных и некорректной выборки.
- Контроль версий артефактов: даны в рамках Data Versioning (DVC/MLflow/независимые решения) и Model Registry.
- Тестирование на инфраструктуре: тесты развёртывания, конфигураций Kubernetes, безопасность доступа и сетевых политик.
- Канаревая доставка (canary) и A/B-тестирование: постепенное развёртывание и сравнение моделей по бизнес-метрикам.
- GitOps и IaC: управление средами через код и прописанные политики доступа.
- Непрерывное тестирование требований к соответствию (регуляторика): аудит изменений, журналирование, обоснование решений.
Архитектура и технологическая реализация
Общая архитектура конвейера ML в финансах
- Источники данных: транзакционные системы, логи, внешние данные.
- Data validation layer: проверки качества, полноты и согласованности данных (перед обучением и инференсом).
- Feature engineering и feature store: создание признаков и их хранение для повторного использования.
- Обучение и эксперименты: запуск гиперпараметрических сочетаний, сравнение моделей, артефактирование.
- Model registry и контейнеризация: версия моделей, зависимости, окружения.
- Развёртывание и сервисы инференса: canary/blue-green, мониторинг качества и дрейфа.
- Наблюдаемость и управления: мониторинг производительности, аудиты, алерты.
- Управление конфигурациями и инфраструктурой: IaC, GitOps, безопасный доступ.
[Data Sources] -> [Data Validation] -> [Feature Store] -> [Model Training & Evaluation] -> [Model Registry]
      |                                                             |
      v                                                             v
[Data Drift Monitoring]                                        [Deployment] -> [Serving]
Технологический стек (пример)
- Оркестраторы: Kubeflow Pipelines, Apache Airflow, Tekton.
- Валидация данных: Great Expectations, Deequ (Scala/Java).
- Признаки и хранилище: Feast (Feature Store), собственные решения на базе DVC.
- Обучение и эксперименты: MLflow, MLRun, Kubeflow.
- Модельный реестр: MLflow Model Registry, Kubeflow Metadata, Локальные реестры.
- Контейнеризация и развёртывание: Docker, Kubernetes, ArgoCD/Flux (GitOps).
- Мониторинг: Prometheus, Grafana, OpenTelemetry; алерты через PagerDuty/Opsgenie.
- Безопасность и соответствие: Vault, OPA Gatekeeper, Policy-as-Code, аудит журналов.
- ИИ- Governance: детекция дрейфа, fair-модификации, управляемый доступ к данным.
Пример технического конвейера
- Данные загружены и валидируются.
- Признаки вычисляются и сохраняются в feature store.
- Обучение и оценка: выбираются модели, регистрируются артефакты.
- Модель публикуется в реестр и разворачивается на staging.
- Мониторинг и тесты на проде; при сигнале - миграция к production.
Пример кода: YAML-конфигурация для GitHub Actions (упрощено)
name: ml-ci-cd
on:
  push:
    branches: [ main ]
jobs:
  build-train-evaluate-deploy:
    runs-on: ubuntu-latest
    steps:
- uses: actions/checkout@v3
- name: Set up Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.9'
- name: Install dependencies
        run: |
          python -m pip install --upgrade pip
          pip install -r requirements.txt
- name: Data validation
        run: |
          python src/validate_data.py
- name: Feature store update
        run: |
          python src/update_features.py
- name: Train model
        run: |
          python src/train.py
- name: Evaluate model
        run: |
          python src/evaluate.py
- name: Register model
        run: |
          python src/register_model.py
- name: Deploy to staging
        run: |
          ./deploy.sh staging
Командные примеры для kubernetes и GitOps
- ArgoCD для синхронизации конфигураций инфраструктуры с Git-репозиторием.
- FluxCD как альтернатива ArgoCD с интеграцией в Kubernetes.
- IaC: Terraform/ Pulumi для описания кластеров, сетевых политик и сервисов.
Архитектура и технологическая реализация: банковские кейсы
Кейсы внедрения в банковской среде
- Кейс 1: Банковская розница внедряет CI/CD для моделей Fraud Detection.
- Архитектура: Kubeflow Pipelines на Kubernetes, MLflow для трекинга экспериментов, Great Expectations для проверки данных, Feast как feature store.
- Практика: строгий контроль версий данных и признаков; canary-доставка по сегментам клиентов; мониторинг качества по бизнес-метрикам (FPR, TPR, precision@k).
- Результат: ускорение цикла разработки на 40-60%, снижение ошибок в проде, снижение времени на регуляторные проверки.
- Кейс 2: Кредитный скоринг и оценка риска с применением DataSphere и открытых инструментов.
- Архитектура: Яндекс DataSphere как платформа управления пайплайнами, интеграция с локальным реестром моделей и пайплайнами на Kubeflow.
- Практика: единая модельная палитра на разных данных и окружениях; централизованный контроль типов данных, комплаенса и аудита.
- Результат: единый цикл от идеи до продакшена, сокращение затрат на инфраструктуру за счёт унифицированного пайплайна.
- Кейс 3: Финтех-стартап с фокусом на платежи использует MLRun + Tekton для CI/CD.
- Архитектура: MLRun для управления экспериментами и версиями моделей; Tekton как CI-трап для Kubernetes.
- Практика: тесты безопасности и контроля доступа, повторяемые smoke-тесты, мониторинг для управления дрейфом.
- Результат: ускорение вывода новых моделей на рынок без потери аудита и контроля.
Открытые решения и российские платформы
- Open-source решения:
- Kubeflow Pipelines: orchestration ML-работ.
- MLflow (Tracking, Projects, Models): управление экспериментами и артефактами.
- Feast: feature store и хранение признаков для повторного использования.
- Apache Airflow / Tekton: оркестрация данных и обучения.
- Dagster: orchestration и качество пайплайнов.
- Российские решения и практика:
- Яндекс DataSphere: платформа обучения, пайплайны, управление артефактами и интеграция с локальными сервисами. Особенно полезна для банковской экосистемы, где важны регуляторные требования и локализация данных.
- Применение отечественных решений в рамках банковской инфраструктуры с поддержкой локального хранения и аудита: использование Kubeflow/MLflow в сочетании с внутренними реестрами и политиками доступа.
- Интеграция с банковскими системами: единый подход к данным, транзакциям и этим процессам без нарушений регуляторики.
Примеры и практические подходы
- Валидация данных прежде всего: Great Expectations или аналогичные инструменты, включающие специфичные для банков домены тесты (валидации по полям транзакции, времени, источнику).
- Управление признаками: Feast позволяет обеспечить единый источник признаков и повторное использование признаков между обучением и инференсом.
- Управление моделью: MLflow Model Registry/ Kubeflow Metadata для отслеживания версий моделей, зависимостей и окружений.
- Мониторинг и управление дрейфом: детекция дрейфа в данных и концептах, алерты для риск-менеджеров и регуляторов.
- Безопасность и аудит: контроль доступа на уровне пользователей и сервисов, журналирование изменений, хранение артефактов в неизменяемых хранилищах.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Алгоритмы валидации данных:
- Проверки схемы (schema checks), диапазоны значений, уникальность ключей, аномалии.
- Checkpoints качества: полнота данных, дубликаты, пропуски, несогласованности.
- Признаки и хранилище:
- Хранение признаков в одном месте с версиями, совместимыми метаданными; обеспечение совместимости между обучением и инференсом.
- Обучение и гиперпараметрические исследования:
- Системы для экспериментов: трекинг метрик, версии кодов, зависимостей.
- Параллельное выполнение гиперпараметрических конфигураций, агрегация лучших моделей.
- Развёртывание и инфраструктура:
- Контейнеризация: повторяемые образы Python, зависимостей и окружения.
- Kubernetes: управление потоками обучения, инференсом и обновлениями версий моделей.
- Интеграции:
- CI/CD-инструменты: GitHub Actions, GitLab CI, Jenkins; их интеграция с Kubeflow/Tekton.
- GitOps: ArgoCD/ Flux для автоматического развёртывания приложений и конфигураций.
- IaC: Terraform/ Pulumi для описания кластеров, сетей и политик безопасности.
- Безопасность и комплаенс:
- Контроль доступа на основе ролей (RBAC), шифрование в покое и в transit, аудит изменений.
- Соответствие требованиям банковской регуляторики: журнал изменений, доказательство происхождения данных и решений, работа с PII.
Организационные и процессные аспекты
- Роли и ответственности:
- ML-инженер: конфигурации пайплайнов, контроль качества признаков и моделей.
- Data Engineer: обеспечение качества источников данных, схемы и дата-гигиена.
- DevOps/Platform Engineer: управление инфраструктурой, IaC, безопасность и доступ.
- QA/Compliance: проверки соответствия, аудит и регуляторные требования.
- Data Scientist: разработка моделей, прототипы, верификация результатов.
- Регуляторика и аудит:
- Журналы изменений и версионирование артефактов.
- Управление доступами к данным и моделям, контроль использования персональных данных.
- Подготовка аудиторских материалов для регуляторов и внутреннего контроля.
- Процессы внедрения:
- Постепенная миграция от ручных процессов к автоматизированным конвейерам.
- Разделение инфраструктуры на окружения: dev/stage/prod с управлением доступами.
- Нормализация процессов проверки и тестирования на уровне данных и моделей.
- Управление рисками:
- Риск-аналитика на уровне различных стадий пайплайна.
- Снижение рисков через ограничение доступа и детальные проверки.
- План реагирования на дрейф данных, деградацию модели и регуляторные инциденты.
Практические примеры и кейсы (open-source и российские решения)
- Пример 1: В банкe-рознице внедрена унифицированная платформа на базе Kubeflow Pipelines и MLflow.
- Что сделано: единый пайплайн обучения и развёртывания, сохранение артефактов, автоматическая проверка данных и признаков.
- Инструменты: Kubeflow Pipelines, MLflow, Great Expectations, Feast, ArgoCD.
- Эффекты: сокращение времени вывода новых моделей на продакшн, повышение повторяемости миграций, улучшение аудита.
- Пример 2: Российская реализация на базе Яндекс DataSphere.
- Что сделано: централизованные пайплайны, единый реестр моделей, интеграции с локальными источниками данных и безопасными средами.
- Инструменты: Яндекс DataSphere, Kubeflow, собственные регистры и политики доступа.
- Эффекты: локализация данных и соответствие требованиям регуляторов, ускорение разработки и внедрения.
- Пример 3: Open-source и совместные практики.
- Команды используют MLRun (open-source) для управления экспериментами, задачами и артефактами; Tekton для CI/CD в Kubernetes.
- Пример использования: tráfego canary, мониторинг дрейфа, автоматическая регрессия моделей по регуляторным правилам.
Таблица сравнения инструментов (упрощенная)
| Инструмент | Назначение | Преимущества | Ограничения | Поддержка инфраструктуры |
|---|---|---|---|---|
| Kubeflow Pipelines | Оркестрация ML-пайплайнов | Глубокая интеграция с Kubernetes, гибкость | Кривая обучения, сложность администрирования | Kubernetes, локальные кластеры |
| MLflow | Tracking/Projects/Models | Простота использования, хорошо интегрируется | Нет встроенного оркестратора сложных пайплайнов | Любые окружения, легкая интеграция |
| Feast | Feature store | Повторное использование признаков, единый источник правды | Окружение требует инфраструктурной поддержки | Kubernetes/облачные хранилища |
| Great Expectations | Валидация данных | Широкий набор готовых правил, легко расширяем | Настройка под специфические домены | Любые данные и пайплайны |
| Яндекс DataSphere | Российская платформа | Локализация данных, регуляторика, локальная поддержка | Зависит от экосистемы Яндекса | Русскоязычная поддержка, интеграции с локальными сервисами |
Технические детали реализации (продвинутые блоки)
- Валидация и監控 данных:
- Great Expectations позволяет создавать "expectations" - ожидания по данным. Они интегрируются в пайплайны как тесты на этапе pre-training.
- Данные, прошедшие проверку, попадают в feature store; неверные данные откатываются и уведомляются.
- Управление признаками:
- Feast обеспечивает единый источник признаков между обучением и инференсом, что особенно важно в финансы, где признаки обновляются регулярно и должны быть совместимы на проде.
- Модельный реестр:
- MLflow Registry позволяет хранить версии моделей, связанные с конфигурациями и метриками. Это упрощает возвраты к предыдущим версиям при выявлении регресса.
- Развертывание и мониторинг:
- Canary deployments и blue/green-подходы снижают риски инцидентов.
- Мониторинг метрик: precision, recall, ROC-AUC, бизнес-метрики (outliers, fraud rate), а также детекция дрейфа через статистические тесты и drift-подсистемы.
- Безопасность:
- Аудит изменений в конфигурациях и артефактов.
- Шифрование в покое и в транзите, контроль доступа на уровне сервисов и пользователей.
- Политики доступа через OPA Gatekeeper и инфраструктурные правила.
Риски, ограничения и типовые ошибки
- Данные как источник ошибок:
- Неполнота, неконсистентность, задержки обновления данных могут привести к деградации моделей и некорректной работе бизнеса.
- Регуляторика и аудиты:
- Неполное документирование процессов, отсутствующая прослеживаемость изменений - прямой риск несоответствия регуляторным требованиям.
- Инфраструктура и операционная сложность:
- Неправильно настроенные пайплайны могут вызвать перегрузку кластеров, задержки и ошибки развертываний.
- Безопасность и приватность:
- Обработка PII и финансовых данных требует строгого соблюдения правил доступа и обработки.
- Зрелость процессов:
- Внедрение требует культурного сдвига в компании, обучение сотрудников и развитие новых ролей.
Перспективы развития направления
- Расширение моделирования и тестирования в составе пайплайнов: включение этических и юридических аспектов в конвейеры (responsible AI, fairness checks).
- Расширение возможностей монетарной регуляторики: встроенная поддержка аудита и доказывания соответствия в реестрах и пайплайнах.
- Модели на границе (edge) и локальная обработка данных: частичные вычисления на месте, где данные не могут покидать корпоративную инфраструктуру.
- Инструменты управления данными и монетарными политиками: тонкая настройка доступа, версионирование данных и контрактов между бизнес- и IT-базами.
- Демократизация MLOps: обучение команд и создание общих стандартов и практик, чтобы новые проекты соответствовали регуляторной среде.
Заключение
CI/CD для ML в финансовом секторе - это не только про скорость релизов, но и про качество, безопасность и регуляторную прозрачность. Применение архитектурно согласованных пайплайнов, тестирования данных и моделей, а также управляемого развёртывания помогает банкам снизить риск ошибок, увеличить время вывода на рынок и повысить доверие клиентов. В условиях зрелости банковских организаций такие подходы становятся неотъемлемой частью цифровой трансформации.
Вопрос-Ответ (FAQ)
Что такое CI/CD для ML и чем она отличается от классического CI/CD?
Ответ: CI/CD для ML фокусируется на артефактах, которые не ограничиваются кодом: данные, признаки, обучающие наборы, модели и окружения. Основные отличия - требования к валидации данных, управление признаками, регистр моделей, а также мониторинг и аудит на уровне бизнес-метрик и регуляторных требований. В ML пайплайны нужно тестировать не только код, но и качество данных и устойчивость моделей к дрейфу.
Какие этапы должны быть в базовом ML-CI/CD конвейере для банков?
Ответ:
- Источник данных и валидация данных;
- Признаки и признак-стор;
- Обучение и эксперименты (трекер экспериментов, гиперпараметрические исследования);
- Оценка и выбор модели по бизнес-метрикам;
- Регистрация и версия моделей;
- Развёртывание в staging/production;
- Мониторинг, drift-детекция и аудит.
Как обеспечить воспроизводимость обучающих пайплайнов?
Ответ: использовать контроль версий данных (DVC/MLflow/ Feast), фиксировать версии кода и зависимостей, сохранять образ окружения, хранить конфигурации параметров и обеспечить детальные логи выполнения. Важно, чтобы каждый артефакт сопровождался метаданными: дата, источник данных, версия признаков, параметры обучения, метрики.
Какие риски связаны с регуляторикой и как их минимизировать?
Ответ: ключевые риски** - нарушение аудита, утечка данных, несоблюдение требований к доступу и журналированию. Репрезентативная и детальная документация пайплайна, строгий доступ, хранение артефактов в неизменяемых хранилищах, периодический аудит и регуляторные проверки снижают риски.
Какие примеры открытых и российских решений можно привести?
Ответ:
- Open-source: Kubeflow Pipelines, MLflow, Feast, Great Expectations, Apache Airflow, Tekton.
- Российские решения: Яндекс DataSphere (для пайплайнов и регистров), локальные реализации на основе Kubeflow/MLflow с регуляторной настройкой и аудитом.
Как организовать мониторинг и детекцию дрейфа в продакшн-моделях?
Ответ: внедрить drift-детекторы на уровне данных и концептов; регулярно сравнивать распределения данных и выходы модели по целевым метрикам; настроить алерты и автоматические процедуры отката при сигнале деградации.
Какую роль играет Feature Store в CI/CD для ML?
Ответ: Feature Store обеспечивает единый источник признаков между обучением и инференсом, снижает риск несогласованности признаков между версиями обучающего пайплайна и проды, упрощает повторное использование признаков, ускоряет внедрение новых моделей и упорядочивает управление данными.
Какие практики следует применять для безопасного и соответствующего регуляторике развертывания?
Ответ: управление доступами на уровне сервисов и пользователей, аудит изменений, контроль версий артефактов, шифрование, журналы событий, политикам доступов через IaC и Policy-as-Code. Важно иметь регуляторно-готовые пайплайны и отчёты.
Какие перспективы в области MLOps для банков в ближайшие годы?
Ответ: поддержка edge-вычислений, улучшение автоматизации compliance-процессов, расширение возможностей по управлению дрейфом и ответственным AI, усиление интеграций с регуляторическими платформами, развитие единых платформ для банковской экосистемы с локализацией данных.
Какие шаги можно сделать в начале проекта внедрения CI/CD для ML в банке?
Ответ:
- определить ключевые бизнес-метрики и регуляторные требования;
- выбрать базовый стек инструментов (CI/CD, валидация данных, feature store, модель registry);
- сформировать команду и роли (ML-инженеры, Data Engineer, Platform Engineer, QA/Compliance);
- создать пилотный пайплайн на одном кейсе (например, fraud-detection или кредитный скоринг) в staging-среде;
- внедрить канаревая доставка и мониторинг, обеспечить аудит и журналирование;
- постепенно масштабировать по подразделениям и данным.
Заключение по FAQ
- Сфокусируйтесь на воспроизводимости, аудите и регуляторике.
- Строение пайплайнов должно быть модульным: данные, признаки, модели, развёртывание, мониторинг.
- Важно обеспечить сотрудничество между бизнес-аналитиками, регуляторами и инженерными командами, чтобы CI/CD для ML в финансах работал стабильно и безопасно.
Если ваша компания планирует масштабировать проекты машинного обучения, ключевым фактором становится создание устойчивой ML-платформы с практиками MLOps и автоматизированными CI/CD-процессами.
Узнайте, как внедрить искусственный интеллект для бизнеса - от стратегии до внедрения: от оценки готовности компании и архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в ключевые бизнес-процессы.


