

Гибридные подходы к прогнозированию: принципы интеграции и схемы использования
Гибридные подходы к прогнозированию demand представляют синтез традиционных статистических моделей и методов машинного обучения с целью повысить точность, устойчивость и адаптивность систем прогнозирования в условиях динамически меняющихся рынков. Такой синтез требует аккуратной архитектурной проработки, управляемого обмена данными между компонентами, а также организационных изменений, позволяющих оперативно трансформировать модели в бизнес-ценности. В данной главе рассматриваются принципы интеграции, архитектурные схемы и схемы использования гибридных систем от концепций к реализациям, с акцентом на сбалансированное сочетание точности, интерпретируемости и управляемости.
Гибридность как концепция выходит за рамки простого добавления одной модели к другой. Она предполагает продуманное разделение ролей между источниками данных, признаками и моделями, а также управление тем, как их предикторы объединяются для формирования итоговой оценки спроса. В условиях реального бизнеса это означает умение настраивать пайплайны так, чтобы они устойчиво справлялись с данными с изменяющимся распределением, сезонными паттернами, шумом и ограничениями по времени реакции. Эффективная реализация требует не только технических средств, но и процессов контроля качества, мониторинга и согласования с бизнес-целями.
Краткое содержание главы
- Принципы и классификация гибридных подходов: уровни интеграции и типовые архитектуры.
- Архитектура гибридной прогностической системы: компоненты, интерфейсы и требования к эксплуатации.
- Паттерны интеграции данных и моделей: пайплайны, калибровка, управление версиями.
- Управление качеством, мониторинг и риски: drift, аудит, регуляторика и организационные аспекты.
- Внедрение и жизненный цикл: процессы, роли, обучение и трансформация.
Понятийный базис и мотивация гибридных подходов
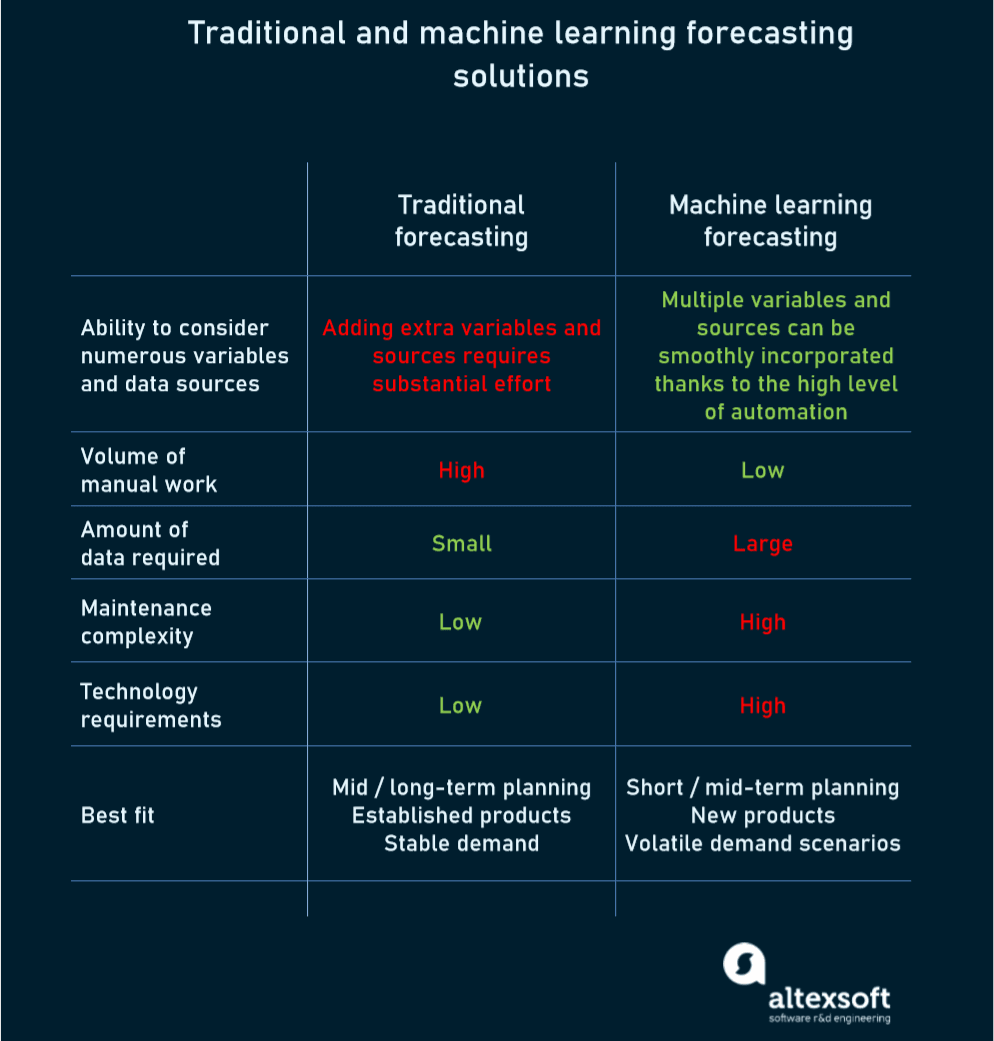
Гибридность в прогнозировании спроса можно рассматривать как объединение преимуществ статистических методов и машинного обучения в рамках единой системы. Статистические модели, как правило, хороши в условиях ограничения данных и явной теории формирования спроса: они дают ясные структуры предположений, легко объяснимые параметры и стабильные сеансы обучения. Машинное обучение, в свою очередь, эффективно обнаруживает сложные шаблоны в больших массивах данных, учитывает нелинейности и взаимодействия факторов, умеет адаптироваться к новым паттернам и скрытым зависимостям. Однако каждое из этих направлений нередко сталкивается с собственными ограничениями: статистика может недоставать гибкости, ML - интерпретации и устойчивости к изменению условий; гибридность позволяет компенсировать слабые стороны за счет взаимодополнения.
С точки зрения архитектуры гибридное прогнозирование может происходить на трех уровнях интеграции:
- Data/Feature level (уровень данных): создание совместных признаков, которые обогащают входы как статистических, так и ML-моделей. Этот подход позволяет моделям работать на схожем информационном поле и упрощает синхронность обновлений.
- Model level (уровень моделей): параллельная или каскадная работа нескольких моделей с последующим объединением их выходов. Это классический ансамбль, но в гибридном формате подразумевает целевые механизмы управления вкладом отдельных компонент в итоговую предсказательную величину.
- Decision level (уровень решений): отдельные прогнозы конвертируются в бизнес-решения через агрегаторы, которые могут включать правила, ограничения и адаптивное взвешивание в зависимости от контекста.
Преимущества такие: повышение точности за счет использования сильных сторон обеих парадигм, повышение устойчивости к дрейфу данных через диверсификацию сигналов, улучшение калибровки и унифицированной трактовки результатов на уровне бизнеса. Риск состоит в усложнении системы, росте требований к управлению данными, инфраструктуре и компетенциям команды. Поэтому важным является не только выбор методов, но и проектирование процессов, которые обеспечивают управляемость и прозрачность.
В рамках проекта по прогнозированию спроса следует формулировать целевые KPI: точность прогноза, скорость обновления, устойчивость к дрейфу, качество данных, интерпретируемость и соответствие регуляторным требованиям. В идеале гибридная система должна демонстрировать выигрыш по нескольким KPI: например, увеличение точности на 5-15% по сравнению с лучшей одиночной моделью, снижение среднего времени цикла обновления прогноза и улучшение устойчивости к сезонным и иррегулярным паттернам.
Архитектура гибридной системы прогнозирования
Архитектура гибридной системы прогнозирования строится вокруг ясной декомпозиции ролей между слоями: данные, признаки, модели и исполнительная среда. Основная цель - обеспечить масштабируемость, повторяемость и управляемость, сохранение интерфейсов между компонентами и возможность безболезненного замещения отдельных элементов.
Компоненты архитектуры
- Данные и признаки: центральная цифровая платформа, включающая интеграцию источников спроса, внешних факторов (погодные условия, макроэкономика, промо-активности) и внутренней репрезентации продаж. Важна поддержка версионирования признаков, чтобы повторно воспроизводить результаты по времени и сценариям.
- Модели и их регистры: ансамбли статистических моделей и ML-моделей, каждый из которых хранит параметры, гиперпараметры, историю обучения и метрики. Регистр моделей обеспечивает трекинг версий, зависимостей и совместимости с данными.
- Пайплайны и оркестрация: orchestration-системы (например, Workflow/ETL-конвейеры) управляют последовательностью шагов, обновлениями признаков, обучением и переобучением моделей, а также дегустацией выпусков. В рамках гибридной схемы это критически важно для поддержания своевременности прогноза и согласованности между компонентами.
- Сервис прогнозирования и API: слой обслуживания, предоставляющий единый вход для бизнес-потребителей и внутренних компонентов. Он агрегирует выходы отдельных моделей, выполняет калибровку и возвращает итоговый прогноз в формате, понятном потребителю.
- Мониторинг, аудиты и регуляторика: отдельный слой наблюдения за качеством данных, производительностью моделей, дрифтами и соответствием требованиям. Включает процессы аудита данных, журналирование принятых решений и регламентированные сигналы для переобучения.
- Платформы MLOps и инструменты: трекинг моделей, управление экспериментами, репозитории кода и данных, контроль версий признаков, инструменты для развёртывания и мониторинга. Примеры - MLflow для трекинга и Kubeflow для конвейеров. Их интеграция обеспечивает повторяемость и прозрачность жизненного цикла.
Совокупность этих компонентов должна поддерживать прозрачную связь между данными, моделями и бизнес-решениями. Важно обеспечить совместимость протоколов обмена данными, согласованность версий и возможность быстрого замещения компонентов без риска для бизнес-процессов.
Интерфейсы и взаимодействие
- Определение единых входов и выходов: входы должны быть стандартизированы, чтобы статистические и ML-модели могли работать на одном и том же наборе признаков. Выходы моделей должны консолидироваться в единый вектор решений с понятной интерпретацией.
- Контракты между компонентами: каждое звено системы имеет контракт на форматы данных, частоту обновления и уровень качества. Это снижает неопределенность и упрощает версионирование.
- Прозрачность и интерпретируемость: даже при использовании ML-компонентов следует сохранять возможность объяснить вклад каждого сигнала в итоговый прогноз. Это особенно важно для бизнес-подразделений и регуляторов.
- Безопасность и приватность: доступ к данным и моделям должен строиться на принципах минимальных прав и аудита, особенно при обмене с внешними источниками и в контексте персональных данных.
Инструменты и примеры реализации
В рамках архитектурной практики допустимо использование открытых инструментов, которые хорошо сочетаются с гибридными подходами. Например, MLflow может обеспечить трекинг версий моделей и артефактов, Kubeflow - оркестрацию конвейеров и развёртывание в Kubernetes, что особенно важно в масштабируемых промышленных средах. Выбор инструментов следует привязывать к корпоративной инфраструктуре, требованиям к безопасности и скорости доставки изменений.
Паттерны интеграции в зависимости от контекста
- Паттерн CASCADE (каскадное объединение): статистическая модель формирует базовый прогноз, ML-модель дополняет его адаптивной корректировкой. Итоговый прогноз - линейная или нелинейная комбинация с явной весовой частью.
- Паттерн STACKED-ENSEMBLE для прогноза спроса: несколько базовых моделей обучаются независимо, их предсказания подаются на стековый ансамбль, который обучается на истории ошибок. Этот подход хорошо работает, если обеспечены достаточные данные и устойчивые временные зависимости.
- Паттерн FEATURE-LEVEL HYBRID: создание общих признаков, которые улучшают как статистические, так и ML-модели, что упрощает совместную работу на входах и повышает консистентность прогноза.
- Паттерн DECISION-LEVEL HYBRID: отдельные прогнозы приводят к бизнес-решениям через правила и адаптивное взвешивание, что особенно полезно для оперативной диспозиции запасов и планирования.
Схемы интеграции данных и моделей: пайплайны, калибровка и управление версиями
Эффективность гибридной системы во многом зависит от того, как организованы данные и как организовано взаимодействие моделей. Основные принципы:
- Качественные пайплайны данных: данные должны проходить через стандартизированные этапы валидации, очистки и нормализации. Важно обеспечить полноту, согласованность и своевременность поступления сигналов. Прозрачность источников и трансформаций облегчает аудит и устранение ошибок.
- Управление признаками: признако-становление и хранение признаков в feature store позволяют повторно использовать их между моделями и версиями конвейеров. Важно поддерживать версионирование признаков, чтобы воспроизводимость экспериментов и переобучения оставались управляемыми.
- Калибровка и согласование выходов: интеграция прогноза в единый слой требует калибровки. В некоторых случаях полезна отдельная калибровка прогнозов под конкретные сегменты рынка или временные периоды. Это обеспечивает трактуемость и управляемость решений на уровне бизнеса.
- Управление версиями моделей: хранение версий параметров, зависимостей и артефактов позволяет понять, как каждая версия повлияла на бизнес-показатели и как повторно воспроизвести результаты.
- Контроль качества и мониторинг: на уровне пайплайнов важно отслеживать задержку, полноту данных, отклонения в распределении признаков и производительности моделей. Мониторинг должен включать сигнализацию о дрейфе, деградации точности и нарушении SLA.
Управление качеством, мониторинг и риски
Гибридные системы требуют активного управления качеством и рисками, чтобы не возникало непредсказуемых сбоев и потеря бизнес-ценности.
Мониторинг производительности и качества
- Постоянный мониторинг метрик точности: RMSE, MAPE, MAE, в зависимости от типа бизнеса и размерности задач. Важно учитывать сезонность и контекст.
- Контроль стабильности: анализ временных рядов на наличие дрейфа распределения входных данных или изменений паттернов спроса. Раннее обнаружение дрейфа позволяет своевременно обновлять модели.
- Интерпретируемость прогноза: поддержка объяснения вклада отдельных факторов в прогноз хотя бы на уровне признаков. Это укрепляет доверие пользователей и облегчает аудиты.
drift и переобучение
- Дрифт данных: сдвиги входного распределения сигналов. Нужны автоматизированные триггеры для переобучения или перенастройки.
- Концептуальный дрифт: изменение причинно-следственных связей между факторами спроса и его величиной. Требует анализа доменной экспертов и возможного пересмотра модели.
- Процессы переобучения: определение триггеров, частоты обучения, тестирования на отложенных данных и валидирования в условиях реального времени.
Управление рисками и соответствие
- Регуляторика и аудит: документирование принятых решений, версий моделей и источников данных. Аудиты должны подтверждать соблюдение регуляторных требований и корпоративной политики.
- Этика и справедливость: выявление и минимизация предвзятостей в данных, особенно в сегментах рынка, где решения влияют на доступность продукции, цены или скидки.
- Безопасность данных: защита персональной информации, соблюдение норм хранения и обработки. Обеспечение конфиденциальности и контроля доступа.
Внедрение и жизненный цикл: процессы, роли и организация
Гибридные подходы требуют сочетания технических изменений и трансформации организационных процессов. Успех во многом зависит от того, насколько плотно выстроены роли, роли и способы сотрудничества между бизнес-подразделениями, аналитикой и IT.
Организационные изменения и роли
- Кросс-функциональные команды: совместная работа data scientists, аналитиков по бизнес-процессам, инженеров данных и специалистов по продукту обеспечивает единое владение целевыми KPI и ускоряет принятие решений.
- Роли и ответственности: ясность в части владения данными, ответственностью за качество данных, ответственностью за публикуемые прогнозы, а также за мониторинг и поддержание жизненного цикла моделей.
- Циклы оценки и коммуникации: регулярные обзоры прогресса, ветвления стратегий и корректировки roadmap на основе бизнес-приоритетов.
Процессы разработки, тестирования и развёртывания
- CI/CD для моделей: автоматизированные конвейеры обучения, тестирования и выпуска новых версий моделей. Включение проверок на качество данных, воспроизводимость прогнозов и регуляторные требования.
- Тестирование на зрелости модели: проверка устойчивости к дрейфу, устойчивости к сбоям процессов и тесты на реалистичных сценариях.
- Экспериментальные режимы и AB-тестирование: планирование экспериментов для измерения реального эффекта внедрения гибридной системы и ее влияния на бизнес-показатели.
Пользовательское и эксплуатационное образование
- Обучение пользователей: обучение бизнес-подразделений пониманию работы гибридного прогноза, доверия к результатам и использованию прогнозов в планировании.
- Панели мониторинга и отчетности: удобные дашборды, показывающие как точность, так и текущие риски, тенденции дрейфа и качество данных.
- Поддержка эксплуатации: регламенты по обновлениям, восстановлениям после сбоев, регламент по обслуживанию и устранению неполадок.
Примеры схем внедрения и сценарии использования
- Прогноз запасов в ритейле: базовый прогноз продаж, дополненный ML-моделью, которая корректирует сезонность и промо-эффекты через гибридное объединение. В рамках схемы используются feature store и регистр моделей, а внедрение сопровождается детальным мониторингом дрейфа и переобучением в начале каждого сезона.
- Прогноз спроса в FMCG с внешними факторами: сочетание статистических моделей, учитывающих ценовую эластичность, и ML-моделей, обученных на больших массивах транзакционных данных и внешних факторов. Архитектура опирается на единый сервис прогнозирования и API, где итоговый прогноз формируется через взвешивание с учётом рыночного контекста.
- Управление спросом в электронной коммерции: быстрые обновления нескольких моделей, включая онлайн-обучение на ограниченных данных и переобучение на аккумуляторе офлайновых данных. Встроенная система мониторинга обеспечивает раннее оповещение о резком дрейфе и снижении точности.
Key takeaways
- Гибридное прогнозирование объединяет сильные стороны статистических методов и машинного обучения, балансируя точность, интерпретируемость и адаптивность.
- Архитектура гибридной системы должна обеспечить четкое разделение ролей между данными, признаками, моделями и сервисами, поддерживая версионирование и управляемость.
- Интеграционные схемы требуют продуманного подхода к пайплайнам данных, калибровке выходов и контролю качества на протяжении всего жизненного цикла моделей.
- Мониторинг, управление дрейфом и регуляторика являются критическими элементами устойчивого применения гибридных подходов в бизнесе.
- Внедрение требует организационных изменений: кросс-функциональные команды, регламенты разработки и обучения пользователей.
- Выбор инструментов и платформ MLOps должен быть связан с инфраструктурой компании, требованиями к безопасности и целями бизнес-ценности.
- Эффективная гибридная система должна позволять бизнесу быстро адаптироваться к изменению спроса и сохранять прозрачность принятых решений.
FAQ
1) Что такое гибридный подход к прогнозированию спроса и зачем он нужен?
Гибридный подход объединяет статистические модели и методы машинного обучения для формирования единого прогноза. Он необходим, когда бизнес-данные богаты и изменчивы, а простые статистические предпосылки не могут уловить все динамики рынка. Комбинация обеих парадигм позволяет использовать явные, теоретически обоснованные связи и мощную адаптивность ML к сложным зависимостям, снижая риски и повышая устойчивость к дрейфу данных.
2) Какие уровни интеграции являютcя наиболее распространенными?
Наиболее распространены три уровня: data/feature level (общие признаки, доступ к которым имеют все модели), model level (параллельное или каскадное использование моделей с последующим объединением прогнозов) и decision level (объединение прогнозов в бизнес-решения через правила и адаптивное взвешивание). Выбор уровня зависит от операционных ограничений, требований к интерпретации и скорости развертывания.
3) Как строится архитектура гибридной системы без потери управляемости?
Необходима четкая модульная декомпозиция: данные и признаки должны иметь единые контракты, модели - версии и зависимости, сервис прогнозирования - API и агрегацию выходов, мониторинг - сигналы для доклада и аудита. Важна поддержка версионирования и регламентированные конвейеры обучения и развёртывания. Использование инструментов MLOps упрощает повторяемость и прозрачность.
4) Как обеспечить качество данных и защиту от дрейфа?
Вводится непрерывный мониторинг распределений признаков, тесты на полноту и консистентность данных, а также детекция дрейфа входов и концептов. Триггеры для переобучения и повторной калибровки должны быть четко прописаны. Привязка переобучения к бизнес-плану и сезонности снижает риск преждевременного отклонения от целей.
5) Как измерять эффективность гибридной модели?
Ключевые метрики зависят от контекста: RMSE/MAE для количественных прогнозов, CRPS для вероятностных прогнозов, доля ошибок по сегментам, а также бизнес-показатели вроде точности планирования запасов и оборачиваемости. Важно проводить сравнение гибридной модели с эталонными подходами (чистая статистика, чистый ML) на одной и той же выборке и в аналогичных условиях.
6) Какие организации и процессы поддерживают устойчивость внедрения?
Необходимы кросс-функциональные команды, регламенты по жизненному циклу моделей, процессы аудита и документации, а также обучение пользователей, чтобы обеспечить принятие и использование прогнозов в операциях. Регистрация версий и прозрачность в изменениях помогают бизнесу видеть ценность гибридной системы и доверие к ней.
7) Какие риски связаны с гибридными схемами и как минимизировать их?
Риски включают усложненную архитектуру, затраты на инфраструктуру, риски нарушения регуляторики и снижение понятности результатов. Минимизация достигается через модульность, четкие контракты между компонентами, мониторинг и аудит, выбор разумной сложности, а также постепенное внедрение с измеримой бизнес-ценностью.
8) Какие примеры open-source решений можно использовать в рамках гибридных подходов?
Open-source решения, такие как MLflow для трекинга моделей и Kubeflow для оркестрации конвейеров, позволяют строить повторяемые процессы развёртывания и мониторинга. Их применение должно быть адаптировано к корпоративной инфраструктуре, требованиям безопасности и регулятивным нормам.
9) Каковы главные принципы успешного внедрения в организацию?
Ключевыми являются ясное определение бизнес-целей, участие бизнес-пользователей в разработке и тестировании, прозрачность методов и результатов, а также регулярная коммуникация об эффекте прогноза на операционные решения и финансовые показатели.
10) Что важнее на старте: точность или интерпретируемость?
Это зависит от контекста. В некоторых сценариях бизнес-решениям необходима строгая интерпретация и объяснимость каждого вклада; в других - предпочтение дается скорости и точности, при этом сохраняются способы проверки и оценки через мониторинг и аудит. Оптимальная стратегия - обеспечить базовую интерпретируемость для критических решений и прагматичную точность для оперативной части прогноза, сохранив возможность её расширения в будущем.
Если ваша компания планирует внедрение продвинутой аналитики или систем прогнозирования на базе AI, важно выстроить правильную архитектуру данных и платформу для аналитики.
Узнайте, как реализовать искусственный интеллект для бизнеса — от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до разработки решений прогнозирования, AI-ассистентов и интеллектуальных систем, интегрированных в бизнес-процессы компании.


