

Временные ряды с внешними регрессорами и рыночными факторами
В современных цепочках поставок и торговле спрос формируется под влиянием множества факторов, выходящих за рамки истории продаж. Включение внешних регрессоров и рыночных факторов в модели временных рядов позволяет уловить сигнал от макро-обстановки, акций конкурентов, сезонных паттернов и маркетинговых мероприятий. Правильная организация работы с такими переменными требует системного подхода: от проектирования архитектуры данных и выбора моделей до внедрения, мониторинга и организационных изменений внутри компании.
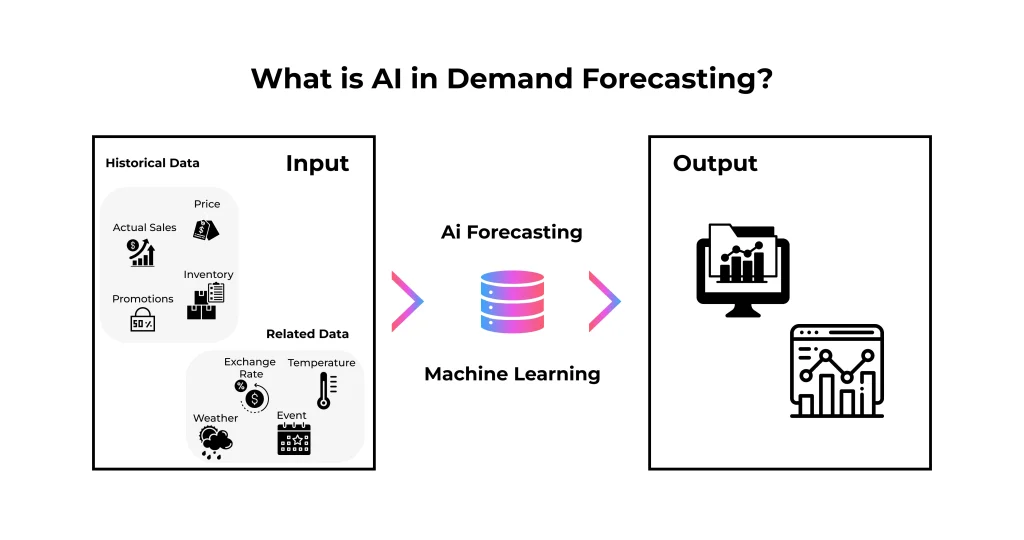
Привычные модели при анализе спроса часто ограничены внутренними данными: прошлые продажи, запасы, цены. Расширение набора признаков за счет внешних регрессоров требует внимательного подхода: как выбирать источники данных, как синхронизировать временные ряды, какие признаки добавлять и как избегать ложных корреляций. В данной главе рассматриваются принципы методологии для построения и эксплуатации прогнозных систем, которые учитывают внешние сигналы и рыночную среду, а также практики внедрения в корпоративной среде.
- Непрерывное включение внешних регрессоров в прогнозы: источники данных, архитектура потоков данных и управление качеством признаков.
- Модели и методики: архитектуры ARIMAX/SARIMAX, динамические регрессоры, состояственные подходы и гибридные ML-решения с регрессорами.
- Процессы внедрения: валидация, мониторинг, управление данными, ответственные роли и организационные изменения.
Концептуальная база: роль внешних регрессоров и рыночных факторов
Внешние регрессоры в контексте временных рядов - это переменные, значения которых не зависят напрямую от наблюдаемого ряда продаж в данный момент, но влияют на его значение в будущие моменты времени. Их корректная интеграция требует понимания нескольких ключевых аспектов.
Во-первых, различают виды регрессоров: макроэкономические индикаторы (инфляция, безработица, ВВП), рыночные факторы (цены конкурентов, акции, промо-кампании, ассортимент), погодные и сезонные переменные, календарные эффекты (праздники, дни скидок). Во-вторых, существует различие между причинной и корреляционной связью. Регрессоры должны обладать устойчивым временным lead/lag эффектом, чтобы обоснованно использовать их для прогнозирования. В-третьих, стоит помнить о проблемах ведомой задержки данных и задержек обновления источников: регрессоры могут приходить с задержкой или обновляться нерегламентированно. В-четвертых, важна идентификация риска: добавление слишком большого числа регрессоров усиливает риск переобучения и мультиколлинеарности; здесь применяются принципы отбора признаков и регуляризации.
С точки зрения методологии следует учитывать, что регрессоры могут быть как прямыми индикаторами спроса, так и косвенными детекторами трендов. Например, промо-акции и рекламные мероприятия могут служить как прямым сигналом спроса во время акции, так и индикаторами будущего спроса за счет запоминания эффектов бренда. В рамках архитектуры прогнозирования важно обеспечить ясность причинно-следственных связей, прозрачность модели и возможность аудита принимаемых решений.
Принципиально целесообразно разделить процесс на три слоя: источники данных, инженерия признаков и выбор модели. Источники данных должны иметь понятные контрактные условия, частоту обновления и уровень точности. Инженерия признаков включает создание лагов, скользящих средних, взаимодействий признаков и декомпозицию сезонности. Выбор модели - это компромисс между объясняемой компонентой и предсказательной мощностью: классические модели для структурированного сигнала и гибридные подходы, которые способны работать с изменчивостью рынка и нелинейными зависимостями.
Архитектура данных и процесс подготовки
Эффективная работа с временными рядами с внешними регрессорами начинается с выстраивания устойчивой архитектуры данных. Основной идеей является обеспечение согласованности времени между целевым рядком и регрессорами, а также создание воспроизводимой среды от сбора данных до прогноза.
Необходимо реализовать три взаимосависимых контура: сбор данных, хранение признаков и режим расчета прогноза. В контексте внешних регрессоров критично поддерживать синхронность временных шкал: регрессор, ведущий по времени, должен соответствовать горизонту прогноза, а регрессоры с запаздыванием - быть логически привязанными к моменту прогноза. Важную роль здесь играет концепция feature store - централизованного контейнера признаков, который обеспечивает версионирование, повторное использование признаков и единообразную обработку на стадии обучения и онлайн-прогнозирования. В корпоративной среде это позволяет обеспечить прозрачность и управляемость признаков, их качество и доступность для разных команд.
Ключевые практики подготовки данных включают:
- Нормализация и выравнивание: приведение регрессоров к единой частоте обновления; обработка пропусков и аномалий.
- Инженерия признаков: создание лагов, скользящих окон, сезонных индикаторов, взаимодействий регрессоров и целевого ряда. Важно избегать “п leaking” - утечки будущих данных в признаки.
- Управление качеством: регулярные проверки целостности данных, мониторинг задержек обновления источников, валидация согласованности меток и регрессоров.
- Контракты на данные: формальные соглашения с владельцами источников о виде, частоте обновления, SLA и методах версионирования.
- Архитектура развертывания: разделение обучения и онлайн-обработки, параллелизм вычислений, обеспечение детерминированности прогноза.
С точки зрения типа моделей, архитектура данных должна поддерживать как классические регрессионные модели, так и гибридные подходы. Фреймворки и инструменты с открытым исходным кодом (например, Statsmodels для ARIMAX/SARIMAX и Prophet для регрессоров) могут ускорить внедрение, но требуют контроля за качеством данных и совместной работы с бизнес-единницами для определения релевантности регрессоров. В корпоративной среде целесообразно использовать совместно с вендорскими и внутренними инструментами: система контроля версий моделей, реестр признаков, пайплайны проверки качества данных.
Модели и подходы: от ARIMAX к гибридным методам
Учет внешних регрессоров в моделях временных рядов можно реализовать различными способами, от классических до современных гибридных подходов. В рамках методологии целесообразно рассмотреть три уровня моделей: структурированные временные ряды с регрессорами, состоящие из детерминированных вкладов и стохастических компонентов; динамические регрессии, где регрессоры воздействуют через лаги и коэффициенты изменяются во времени; а также гибридные архитектуры, сочетающие преимущества статистических и ML-моделей.
- Структурированные временные ряды с внешними регрессорами (ARIMAX/SARIMAX, Dynamic Regression, State-Space)
ARIMAX и SARIMAX - базовые инструменты для учёта регрессоров в рамках классических моделей авторегрессии, интегрирования и скользящего среднего с внешними вводами. Эти подходы хорошо работают, когда регрессоры линейно влияют на целевой ряд, и сезонность позволяет явно разделить периодические сигналы. В рамках методологии важно:
- аккуратно подбирать лаги регрессоров и учитывать гипотезы стационарности;
- избегать мультиколлинеарности за счет отбора признаков и регуляризации;
- проводить тесты на стационарность и проверку допущений;
- использовать сезонные компоненты (SARIMAX) при наличии повторяющихся паттернов: сезонная константа, сезонные лаги и сезонные регрессоры.
State-Space и динамические регрессоры расширяют классические подходы, позволяя интегрировать регрессоры через скрытые состояния и Kalman фильтр. Такой подход особенно полезен, когда влияние регрессоров может изменяться во времени или когда сигнал нестабилен. В промышленной практике это требует ясной стратегии обновления состояний, интерпретации параметров и мониторинга устойчивости.
- Вклад регрессоров в регрессионные деревья и линейные модели (с ограничениями)
Линейные модели с регрессорами (OLS- или ridge-регрессия) сохраняют интерпретируемость и прозрачность влияния регрессоров, однако могут страдать при нелинейной зависимости или взаимодействиях между регрессорами. В этой парадигме регрессоры добавляются как признаки к набору переменных, и применяются регуляризация и отбор признаков. В корпоративной среде полезно сочетать такие подходы с ограниченным числом интерактивных признаков, чтобы сохранить интерпретируемость и устойчивость на реальных данных.
- Гибридные подходы и современные методологии ML
Гибридные подходы объединяют статистические модели с мощностью ML. Классический пример - использование регрессоров в динамическом или регрессионном контуре, дополняемом ML-моделью для обработки нелинейностей и сложных зависимостей. В современной практике возможно сочетать:
- регрессоры в рамках ARIMAX/SARIMAX с ML-моделью, которая обучается на остатках или на представлениях признаков;
- использование ML-блоков для обработки регрессоров, а затем передача результатов в структурированную математическую модель времени;
- применение нейросетевых архитектур, специально адаптированных под временные ряды (например, Temporal Fusion Transformer), которые умеют работать с регрессорами помимо истории продаж.
Контекст: выбор инструментов зависит от бизнес-целей, объема данных и требований к прозрачности. Open-source решения включают Statsmodels для классических моделей и Prophet или CatBoost как инструменты для обработки регрессоров и нелинейностей. В местах, где требуется производительность и устойчивость к рыночным изменениям, целесообразно применять гибридно-архитектурные подходы и проверять их на backtesting.
- Практические принципы инженерии признаков и предотвращение ловушек
- Создание лагов и перекрестных эффектов: подберите лаги так, чтобы регрессоры отвечали на горизонте прогноза. Важно тестировать различные задержки и выбирать те, которые дают устойчивый сигнал, а не шум.
- Линейность против нелинейности: начните с линейных регрессий, затем по мере необходимости внедряйте нелинейности в рамках ML-компонентов.
- Проблемы коллинеарности: при большом числе регрессоров вероятность мультиколлинеарности возрастает; применяйте регуляризацию и функциональные способа снижения размерности.
- Защита от утечки данных: строго отделяйте обучающие данные от тестовых, избегайте использования будущих значений регрессоров в обучении.
- Валидация гипотез о влиянии регрессоров: используйте тесты на причинность и устойчивость эффектов регрессоров к событиям в бизнес-процессах.
- Мониторинг качества регрессоров: следите за задержками обновления, целостностью данных и изменениями источников.
- Внедрение и эксплуатация гибридных моделей
Гибридные архитектуры требуют четкой процедуры внедрения и поддержки. Включение регрессоров в онлайн-прогнозирование должно сопровождаться:
- регламентом обновления признаков и частотой перерасчета;
- мониторингом качества входных данных и согласованностью их значений;
- управлением версиями моделей и признаков, чтобы можно было возвращаться к предыдущим состояниям;
- механизмами отклика на изменения рыночной конъюнктуры (перекалибровка, перерасчет лагов, повторная калибровка).
Инструменты и примеры: для поддержки экспериментирования и версионирования моделей можно использовать открытые решения типа MLflow или аналогичные инфраструктурные подсистемы. В рамках выбора технологий достаточно упомянуть эти решения как опцию для инженерной инфраструктуры, не загромождая текст избыточной конкретикой.
Валидация, мониторинг и управление данными
Ключевые аспекты валидации:
- стратегическая выборка для временного ряда: rolling-origin или walk-forward backtesting, где каждый шаг моделирования воспроизводит реальный цикл обновления данных.
- метрики прогноза: MAPE, sMAPE, RMSE, MAE и бизнес-ориентированные показатели (например, доля ошибок выше порога, влияние на запас и оборот). Важно выбирать метрику, которая соответствует бизнес-цели и устойчиво отражает различия между моделями.
- тестирование значимости вкладов регрессоров: чтобы уловить устойчивый сигнал, а не случайную корреляцию.
- устойчивость к рыночным изменениям: периодические проверки на устойчивость параметров и переобучение при изменениях в условиях рынка.
- мониторинг дальше по жизненному циклу: автоматические дашборды, уведомления о деградации точности прогноза, автоматизированное триггерное обновление моделей.
Организационная часть верификации и внедрения требует установления процессов и ролей: аналитики продаж, инженеры данных, data scientists и команды DevOps должны работать в связке. В рамках инфраструктурного уровня рекомендуется внедрить репозитории данных и моделей, процедуры ревью изменений, а также процессы аудита и успокаивающих регламентов для выполнения изменений в регрессионной архитектуре.
Организационные аспекты внедрения: роли, процессы и управление изменениями
Успешная реализация прогнозирования спроса с учетом внешних регрессоров предполагает соответствие бизнес и технических процессов. Важные элементы организационной части:
- совместная работа кросс-функциональных команд: бизнес-д Owners, аналитики, инженеры данных и специалисты по MLOps должны работать как единая команда, способная быстро адаптироваться к изменениям рынка.
- формализация требований к данным: определение источников регрессоров, частоты обновления, точности и ответственности за качество данных.
- процессы контроля версий и воспроизводимости: хранение версий признаков, моделей, скриптов расчета и параметров; документирование изменений и их причин.
- интерпретируемость и прозрачность: бизнес-пользователи должны понимать, как регрессоры влияют на прогноз, какие факторы являются основными драйверами и как изменится прогноз при изменении входных данных.
- governance и аудит: регулярные обзоры моделей, соответствие регламентам и политикам качества данных, соблюдение требований безопасности и приватности.
- внедрение в бизнес-процессы: автоматизация рабочих процессов** - от загрузки данных до расчетов прогноза и распространения результатов в принятии решений.
В местах, где применяются регрессоры рыночной среды, необходима устойчивость к непредвиденным событиям и способность к адаптации. Организационная поддержка включает регулярное обучение сотрудников, создание культуры экспериментов и прозрачности, а также развитие компетенций в области анализа данных и статистики.
Прорывные архитектуры и протоколы интеграции
Эффективная интеграция внешних регрессоров требует продуманной архитектуры, где данные проходят чётко выстроенный путь: от источника до прогноза и его использования в бизнесе. Рекомендуются следующие практики:
- контрактная архитектура для данных: clearly defined data contracts between data producers and model teams, with explicit SLAs and data lineage.
- пайплайны «данные → признаки → модель → прогноз» с контролем качества на каждом переходе.
- разделение обучения и онлайн-прогнозирования: пакетная перерасчета признаков и обновления модели в рамках цикла, за которым следует онлайн-логика прогноза для оперативной поддержки решений.
- использование фреймворков для управления признаками и моделями: хранение признаков в постоянном хранилище, версионирование моделей, журналирование всех прогонов и параметров.
- мониторинг качества данных и точки «порогов»: автоматическая сигнализация при падении точности, изменении распределения регрессоров или задержке от источников.
Пример архитектурной картины может включать: источники данных (поставщики регрессоров), слой подготовки признаков (feature engineering & validation), слой моделей (ARIMAX, SARIMAX, динамические регрессоры, ML-блоки), сервис прогноза (онлайн-API), и слой мониторинга(сигнализация деградации и аудит). В контексте российского и открытого ПО допустимы примеры: Statsmodels для статистических моделей, Prophet для регрессоров и временных зависимостей, а также CatBoost как ML-инструмент, который хорошо работает с табличными признаками и может учитывать регрессоры. Встроенная инфраструктура может опираться на MLflow для экспериментов и версионирования моделей.
Key takeaways
- Внешние регрессоры расширяют predictability временных рядов, но требуют строгого управления источниками данных, синхронностью и гипотезами о влиянии.
- Архитектура данных должна обеспечить версионирование признаков, воспроизводимость пайплайнов и возможность повторного использования признак‑окон.
- Выбор модели зависит от линейности зависимостей и необходимости учета нелинейных эффектов; сочетание статистических подходов и ML‑моделей часто обеспечивает наилучшее соотношение объяснимости и точности.
- Валидация прогноза должна быть сквозной: rolling-origin/backtesting, бизнес‑ориентированные метрики и анализ устойчивости эффектов регрессоров.
- Внедрение требует организационной поддержки: роли, контракты на данные, governance, мониторинг и систематическую работу над качеством данных.
- Гибридные подходы представляют собой эффективное решение в условиях рыночной изменчивости: они позволяют сочетать прозрачность статистики и мощность ML без потери управляемости.
- Регулярная переработка и переобучение моделей в ответ на изменения рынка - необходимый элемент жизненного цикла, а мониторинг деградации прогнозов - критический фактор успешности.
FAQ
1) Какие регрессоры чаще всего учитывают в прогнозах спроса и как их выбирать?
Регрессоры обычно охватывают макроэкономические условия, рыночную активность конкурентов, цены и промо-акции, погодные условия, календарные эффекты и логистическую обстановку. Выбор регрессоров строится на нескольких шагах: скоординированный анализ корреляций и причинности, тестирование лагов, оценка устойчивости сигнала к шуму и проверка на перекрытие бизнес-событий. Важна способность регрессоров быть доступными в нужный момент и не приводить к утечке информации.
2) Как определить, какие лаги регрессоров стоит использовать?
Начните с анализа кросс‑корреляций между целевым рядком и регрессорами на разных лагах. Затем применяйте методику пошагового отбора признаков с учетом риска переобучения и мультиколлинеарности. В рамках ARIMAX/SARIMAX можно экспериментировать с лагами в диапазоне нескольких периодов (от нескольких дней до недель, в зависимости от горизонтa прогноза). Для ML‑моделей используйте регуляризацию и проверку устойчивости через кросс‑валидацию во временной плоскости.
3) Какие риски сопряжены с использованием внешних регрессоров?
Основные риски: ложные корреляции, задержки и неполнота данных, шум регрессоров, несоответствие временных рамок, инциденты в источниках данных, а также риск переобучения из-за избыточного числа признаков. Не менее важен риск «утечки» будущих данных через регрессоры. Необходимо проводить тщательную валидацию и поддерживать контроль доступа к данным.
4) Когда предпочтительнее использовать ARIMAX/SARIMAX, а когда гибрид ML‑подход?
ARIMAX/SARIMAX эффективны, когда зависимости линейны, данные достаточно структурированы и требуется прозрачная интерпретация. Гибридные подходы полезны при наличии нелинейностей, сложных взаимодействий или когда регрессоры имеют непредсказуемый характер. В реальной практике часто применяется сочетание: базовый статистический прогноз с регрессорами + ML‑модуль для коррекции остатков или для обработки нелинейных эффектов.
5) Какие методы валидации лучше всего подходят для временных рядов с регрессорами?
Рекомендуются walk-forward/backtesting и rolling-origin подходы, которые сохраняют временной порядок и позволяют оценить устойчивость прогноза на будущее. Метрики должны учитывать бизнес‑контекст: MAPE, RMSE, MAE и бизнес‑ориентированные показатели. Важно проводить статистическую проверку значимости вкладов регрессоров и проводить сравнение моделей на одинаковых тестовых горизонтах.
6) Какие практики внедрения обеспечивают устойчивый результат?
Контроль версий признаков и моделей, детальная документация изменений, строгие контракты на данные, мониторинг качества входных данных и точности прогноза, регулярные аудиты и ретриггеры на перерасчет моделей. Внедрение должно сопровождаться механизмами автоматического обновления признаков и уведомлениями в случае деградации точности.
7) Какие инструменты и технологии особенно уместны в данной области?
Open-source инструменты, такие как Statsmodels для ARIMAX/SARIMAX и Prophet для регрессоров, хорошо подходят на начальном этапе. Для поддержки гибридных подходов и управления экспериментами полезны системы типа MLflow для версионирования моделей и артефактов. Выбор конкретной платформы зависит от инфраструктуры компании, но важно обеспечить совместимость между пайплайнами данных, моделями и бизнес-процессами.
8) Как обеспечить прозрачность и интерпретируемость в гибридных моделях?
Сохранение объяснимости достигается через явное разделение вкладов регрессоров и компонент моделирования, использование моделей с понятной структурой (линейные и детерминированные части) и аудит принятых решений. В рамках гибридных подходов рекомендуется сохранять возможность анализа влияния каждого регрессора, а ML‑блок - сопровождать объясними существующими методами интерпретации (например, анализ остаточных сигналов, важность признаков в агрегированной форме).
9) Как организовать работу с рыночными регрессорами на уровне данных?
Необходимо заключение контрактов на данные и контроль версий. В процессе подготовки данных важно обеспечить согласование частоты обновления, форматов и единиц измерения регрессоров. Нужна единая методика обработки пропусков и аномалий, а также политика обновления признаков, чтобы регрессоры reliably входили в расчеты на каждом горизонте.
10) Какие критерии следует учитывать при выборе между локальными и глобальными регрессионами?
Локальные регрессоры (для отдельных SKU/регионов) могут давать точный сигнал в специфических условиях, но требуют большего объема данных и усилий по управлению многочисленными моделями. Глобальные регрессоры работают эффективнее на уровне портфеля и унифицируют подход, но могут пропускать локальные паттерны. Выбор зависит от бизнес‑целей, объема данных и требуемой скорости внедрения изменений. Практика часто достигается через иерархическую модельную архитектуру, где глобальные регрессоры дополняются локальными адаптациями.
Глава предлагает систематический путь к управлению временными рядами с внешними регрессорами и рыночными факторами в контексте методологии: от философских оснований до практик внедрения и управления жизненным циклом прогностических систем.
Если ваша компания планирует внедрение продвинутой аналитики или систем прогнозирования на базе AI, важно выстроить правильную архитектуру данных и платформу для аналитики.
Узнайте, как реализовать искусственный интеллект для бизнеса — от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до разработки решений прогнозирования, AI-ассистентов и интеллектуальных систем, интегрированных в бизнес-процессы компании.


