

Полное руководство по метрикам оценки Machine Learning моделей и анализу ошибок
Метрики оценки ML-моделей помогают понять, насколько хорошо модель решает конкретную задачу и какие ошибки она допускает. Универсальной метрики не существует: для классификации, регрессии и кластеризации используют разные показатели, а выбор зависит от бизнес-цели, дисбаланса классов, цены ошибки и требований к интерпретации результата.
В этом руководстве разбираем основные метрики машинного обучения: accuracy, precision, recall, F1-score, ROC-AUC, confusion matrix, MAE, MSE, RMSE, R² и метрики кластеризации. Покажем, почему одной точности недостаточно, как анализировать ложноположительные и ложноотрицательные ошибки, какие метрики выбирать для разных задач и как не сделать неверные выводы о качестве модели.
Что внутри:
- почему не существует единственной правильной метрики;
- как выбирать метрику под бизнес-задачу;
- confusion matrix и анализ ошибок классификации;
- accuracy, precision, recall и F1-score;
- ROC-AUC и PR-AUC;
- ложноположительные и ложноотрицательные ошибки;
- метрики регрессии: MAE, MSE, RMSE, MAPE, R²;
- метрики кластеризации;
- влияние дисбаланса классов;
- цена ошибки в ML-проектах;
- типовые ошибки при оценке моделей.
В современном мире, где машинное обучение становится ключевым инструментом для принятия бизнес-решений, критически важно правильно оценивать качество создаваемых моделей. Неверный выбор метрики может привести к катастрофическим последствиям: от некорректных прогнозов и финансовых потерь до принятия неверных стратегических решений.
В этом материале мы подробно разберем метрики для всех основных типов задач машинного обучения: классификации, регрессии и кластеризации. Мы не только объясним теорию, но и покажем на реальных примерах, как эти метрики работают на практике, а главное — на что следует обратить внимание, чтобы не допустить фатальных просчетов в ваших проектах.
Почему не существует единственной правильной метрики?
Первый и главный вывод, который должен сделать каждый специалист по data science: универсальной метрики, подходящей для всех задач, не существует. Выбор метрики напрямую зависит от типа задачи (классификация, регрессия, кластеризация), бизнес-цели (что для вас важнее — минимизировать ложноположительные срабатывания или не пропустить ни одного реального случая?), дисбаланса классов (одна из самых частых проблем в реальных данных), а также от цены ошибки (ошибка в предсказании цены акции и ошибка в диагностике заболевания имеют совершенно разную стоимость).
Игнорирование этих факторов — первая и самая грубая ошибка, которая сводит на нет все усилия по построению модели.
Метрики классификации: глубже, чем просто точность
Классификация — один из самых распространенных типов задач.
Для простоты понимания рассмотрим бинарный случай. Но перед этим стоит внимательно ознакомиться с матрицей ошибок (confusion matrix) и её компонентами.

Обучим логистическую регрессию на датасете Breast Cancer Wisconsin, построим на основе её прогнозов данную матрицу.
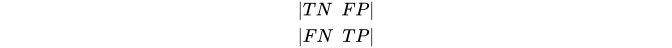
Импорт библиотек, которые нам понадобятся:
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix
from sklearn.preprocessing import LabelEncoder
from sklearn.metrics import (accuracy_score, precision_score, recall_score, f1_score,
                             fbeta_score, roc_curve, roc_auc_score, precision_recall_curve,
                             auc, average_precision_score, classification_report)
Загрузка датасета
df_path = "/content/drive/MyDrive/breast_cancer.csv"
breast_cancer = pd.read_csv(df_path)
breast_cancer.drop(columns=['id','Unnamed: 32'], inplace=True)
print(breast_cancer)
X = breast_cancer.drop(columns='diagnosis', axis=1)
y = breast_cancer['diagnosis']
y = LabelEncoder().fit_transform(y)
# 1 - Malignant, 0 - Benign
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)
    diagnosis  radius_mean  texture_mean  perimeter_mean  area_mean  \
0           M        17.99         10.38          122.80     1001.0
1           M        20.57         17.77          132.90     1326.0
2           M        19.69         21.25          130.00     1203.0
3           M        11.42         20.38           77.58      386.1
4           M        20.29         14.34          135.10     1297.0
..        ...          ...           ...             ...        ...
564         M        21.56         22.39          142.00     1479.0
565         M        20.13         28.25          131.20     1261.0
566         M        16.60         28.08          108.30      858.1
567         M        20.60         29.33          140.10     1265.0
568         B         7.76         24.54           47.92      181.0
     smoothness_mean  compactness_mean  concavity_mean  concave points_mean  \
0            0.11840           0.27760         0.30010              0.14710
1            0.08474           0.07864         0.08690              0.07017
2            0.10960           0.15990         0.19740              0.12790
3            0.14250           0.28390         0.24140              0.10520
4            0.10030           0.13280         0.19800              0.10430
..               ...               ...             ...                  ...
564          0.11100           0.11590         0.24390              0.13890
565          0.09780           0.10340         0.14400              0.09791
566          0.08455           0.10230         0.09251              0.05302
567          0.11780           0.27700         0.35140              0.15200
568          0.05263           0.04362         0.00000              0.00000
     symmetry_mean  ...  radius_worst  texture_worst  perimeter_worst  \
0           0.2419  ...        25.380          17.33           184.60
1           0.1812  ...        24.990          23.41           158.80
2           0.2069  ...        23.570          25.53           152.50
3           0.2597  ...        14.910          26.50            98.87
4           0.1809  ...        22.540          16.67           152.20
..             ...  ...           ...            ...              ...
564         0.1726  ...        25.450          26.40           166.10
565         0.1752  ...        23.690          38.25           155.00
566         0.1590  ...        18.980          34.12           126.70
567         0.2397  ...        25.740          39.42           184.60
568         0.1587  ...         9.456          30.37            59.16
     area_worst  smoothness_worst  compactness_worst  concavity_worst  \
0        2019.0           0.16220            0.66560           0.7119
1        1956.0           0.12380            0.18660           0.2416
2        1709.0           0.14440            0.42450           0.4504
3         567.7           0.20980            0.86630           0.6869
4        1575.0           0.13740            0.20500           0.4000
..          ...               ...                ...              ...
564      2027.0           0.14100            0.21130           0.4107
565      1731.0           0.11660            0.19220           0.3215
566      1124.0           0.11390            0.30940           0.3403
567      1821.0           0.16500            0.86810           0.9387
568       268.6           0.08996            0.06444           0.0000
     concave points_worst  symmetry_worst  fractal_dimension_worst
0                  0.2654          0.4601                  0.11890
1                  0.1860          0.2750                  0.08902
2                  0.2430          0.3613                  0.08758
3                  0.2575          0.6638                  0.17300
4                  0.1625          0.2364                  0.07678
..                    ...             ...                      ...
564                0.2216          0.2060                  0.07115
565                0.1628          0.2572                  0.06637
566                0.1418          0.2218                  0.07820
567                0.2650          0.4087                  0.12400
568                0.0000          0.2871                  0.07039
[569 rows x 31 columns]
Обучение и прогноз модели логистической регрессии
model = LogisticRegression(max_iter=10000)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
print(y_pred)
[1 0 0 0 0 0 0 0 0 0 1 0 0 1 0 1 0 1 1 1 1 1 0 0 1 0 0 1 0 1 0 1 0 1 0 1 0
 1 0 1 1 0 1 0 1 1 0 0 0 1 1 1 1 0 0 0 0 0 0 1 1 1 0 0 1 0 1 1 1 0 1 1 0 0
 1 0 0 0 0 0 1 1 1 0 1 0 0 0 1 1 0 1 1 1 0 0 1 0 0 0 0 0 0 0 1 0 1 0 1 1 0
 1 1 0 0 0 0 0 0 0 0 0 1 0 1 0 1 0 0 0 1 0 0 0 0 0 0 1 1 0 0 0 1]
Построение и визуализация confusion matrix
conf_matrix = confusion_matrix(y_test, y_pred)
sns.heatmap(conf_matrix, annot=True, fmt='d', cmap='Reds')
plt.title('Confusion Matrix')
plt.xlabel('Predicted Label')
plt.ylabel('True Label')
plt.show()
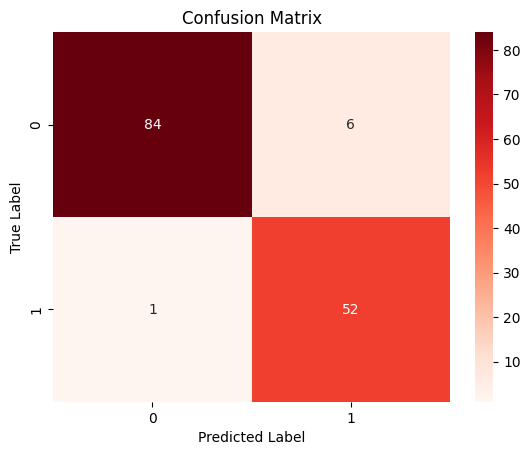
Судя по полученной матрице ошибок, мы имеем следующее:
- True Positive (TP): 52 случая. Модель идентифицировала злокачественные опухоли верно
- True Negative (TN): 84 случая. Модель идентифицировала доброкачественные опухоли верно.
- False Positive (FP): 6 случаев. Ошибка I рода. Модель ложно диагностировала рак у здоровых пациентов. Риск: ненужные стресс, дополнительные дорогостоящие и инвазивные обследования.
- False Negative (FN): 1 случай. Ошибка II рода. Модель пропустила злокачественную опухоль. Риск: упущенное время для лечения, прямая угроза жизни пациента.
Перейдем к самим метрик.
Accuracy (Точность): Просто, но опасно
Accuracy = (TP + TN) / (TP + TN + FP + FN) = (52 + 84) / (52 + 84 + 6 + 1) ≈ 0.951
accuracy = accuracy_score(y_test, y_pred)
error_rate = 1 - accuracy
print(f'Accuracy: {accuracy}')
print(f'Error rate: {error_rate}')
Accuracy: 0.951048951048951
Error rate: 0.04895104895104896
Эта метрика интуитивно понятна — это доля правильных ответов. Однако она крайне обманчива при дисбалансе классов.
Представьте, что в выборке 95% здоровых пациентов и 5% больных. Модель, которая всегда предсказывает "здоров", будет иметь accuracy 95%, но при этом она абсолютно бесполезна и опасна. Слепое доверие к accuracy — грубейшая ошибка!
Precision (Точность) и Recall (Полнота): Две стороны одной медали
Чтобы учесть тип ошибок, мы используем используем следующие метрики:
Precision = TP / (TP + FP) = 52 / (52 + 6) ≈ 0.897
precision = precision_score(y_test, y_pred)
print(precision)
0.896551724137931
Вопрос: Насколько мы можем доверять положительному прогнозу модели?
Бизнес-смысл: Минимизация ложных срабатываний. Критична в спам-фильтрах (чтобы не потерять важное письмо) или при запуске дорогостоящей рекламной кампании для потенциальных клиентов (чтобы не тратить бюджет на нецелевую аудиторию).
Recall (Sensitivity, TPR) = TP / (TP + FN) = 52 / (52 + 1) ≈ 0.981
recall = recall_score(y_test, y_pred)
print(recall)
0.9811320754716981
Вопрос: Какую долю реальных положительных случаев мы обнаружили?
Бизнес-смысл: Минимизация пропущенных угроз. Критична в медицине (диагностика заболеваний), выявлении мошенничества (когда пропуск мошеннической операции дороже ее блокировки) и поиске информации (поисковая система должна найти все релевантные документы).
Между этими метриками существует фундаментальный компромисс. Повышая порог классификации (становясь более "строгими"), мы увеличиваем Precision (меньше ложных срабатываний), но снижаем Recall (больше реальных случаев мы пропускаем). И наоборот.
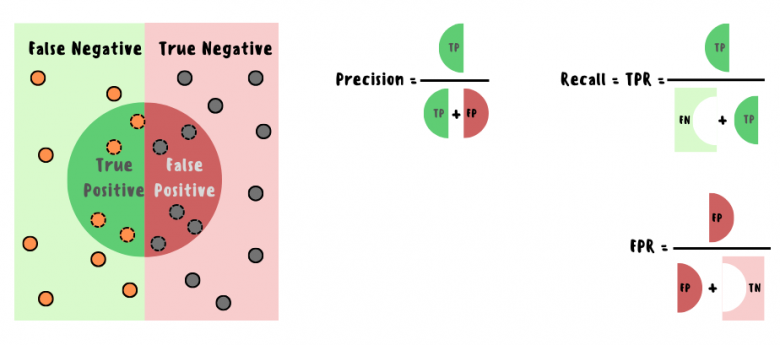
FPR
False Positive Rate характеризует долю ошибочно предсказанных положительных классов среди всех образцов, которые являются отрицательным классом. Другими словами, метрика показывает, как часто модель неверно прогнозирует наличие заболевания, когда его на самом деле нет.
Для лучшего понимания метрик, описанных выше, приводим следующее изображение:
F1-Score: Гармонический баланс
F1 = 2 * (Precision * Recall) / (Precision + Recall) ≈ 0.937
f1 = f1_score(y_test, y_pred)
print(f1)
0.9369369369369369
F1-Score — это гармоническое среднее между Precision и Recall. Он полезен, когда вам нужно найти баланс между этими двумя метриками, и особенно важен при сильном дисбалансе классов.
Fβ-Score: Если одна из метрик важнее другой, используется обобщенная версия. Например, в задаче диагностики рака Recall (пропуск болезни) гораздо критичнее, поэтому можно использовать F2-Score, который дает Recall больший вес: F2 ≈ 0.963.
f2 = fbeta_score(y_test, y_pred, beta=2)
print(f2)
0.9629629629629629
ROC-AUC: Оценка качества ранжирования
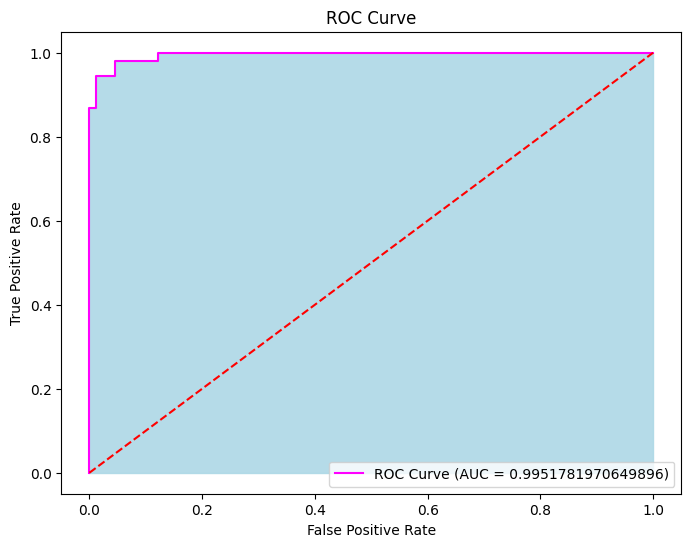
ROC-кривая визуализирует производительность модели при всех возможных порогах классификации. Она показывает, как соотносятся True Positive Rate (Recall) и False Positive Rate (FPR).
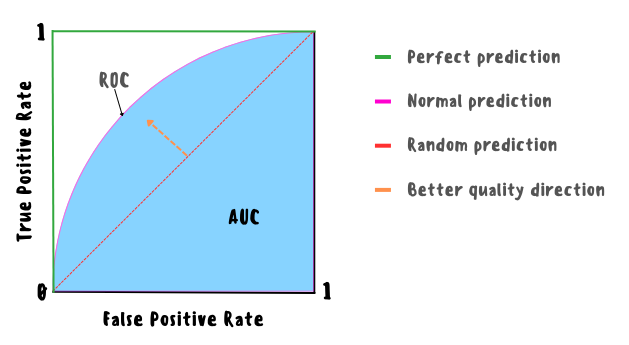
AUC (Area Under Curve): Площадь под ROC-кривой. Значение 1.0 — идеальная модель; 0.5 — модель не лучше случайного угадывания; < 0.5 — модель работает хуже случайности.
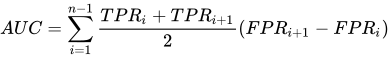
ROC-AUC не зависит от порога классификации и отлично показывает, насколько хорошо модель ранжирует объекты (например, насколько вероятность быть классом "1" у реальных единиц выше, чем у нулей).
При сильном дисбалансе классов ROC-AUC может давать излишне оптимистичную оценку, так как малое изменение в числе FP (которых и так мало) сильно не меняет FPR.
def binary_roc_curve(y_true, y_score):
    thresholds = np.sort(y_score)[::-1]
    tps = np.array([])   # True positives
    fps = np.array([])   # False positives
    for threshold in thresholds:
        # predictions binarization by each threshold
        y_pred = (y_score >= threshold).astype(int)
        tp = np.sum((y_true == 1) & (y_pred == 1))
        fp = np.sum((y_true == 0) & (y_pred == 1))
        tps = np.append(tps, tp)
        fps = np.append(fps, fp)
    # find optimal (corner) points (thresholds)
    corner_point = True
    d2_fps = np.diff(fps, 2)   # is used as a "second derivative"
    d2_tps = np.diff(tps, 2)
    is_corner_points = np.r_[corner_point, np.logical_or(d2_fps, d2_tps), corner_point]
    optimal_indexes = np.where(is_corner_points == corner_point)[0]
    # add an extra threshold position to optimal values to make sure that the curve starts
    # at (0, 0) and also ends in 1 even if all samples are incorrectly classified
    optimal_fps = np.r_[0, fps[optimal_indexes]]
    optimal_tps = np.r_[0, tps[optimal_indexes]]
    optimal_thresholds = np.r_[max(y_score) + 1, thresholds[optimal_indexes]]
    optimal_fpr = optimal_fps / optimal_fps[-1]
    optimal_tpr = optimal_tps / optimal_tps[-1]
    return optimal_fpr, optimal_tpr, optimal_thresholds
def area_by_trapz(y, x):
    dx = np.diff(x)   # height
    return 0.5 * ((y[1:] + y[:-1]) * dx).sum()
def binary_roc_auc_score(y_test, y_pred):
    fpr, tpr, _ = binary_roc_curve(y_test, y_pred)
    return area_by_trapz(tpr, fpr)
y_pred_probas = model.predict_proba(X_test)[:, 1]
roc_auc = binary_roc_auc_score(y_test, y_pred_probas)
fpr, tpr, thresholds = binary_roc_curve(y_test, y_pred_probas)
print(f'AUC: {roc_auc}', '', sep='\n')
print('Optimal False Positive Rates:', fpr, '', sep='\n')
print('Optimal True Positive Rates:', tpr, '', sep='\n')
print('Optimal thresholds:', thresholds, sep='\n')
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, label=f'ROC Curve (AUC = {roc_auc})', color='fuchsia')
plt.plot([0, 1], [0, 1], 'r--')  # Dashed diagonal line
plt.fill_between(fpr, tpr, color='lightblue', alpha=0.9)
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve')
plt.legend(loc='lower right')
plt.show()
AUC: 0.9951781970649896
Optimal False Positive Rates:
[0.         0.         0.         0.01111111 0.01111111 0.04444444
 0.04444444 0.12222222 0.12222222 1.        ]
Optimal True Positive Rates:
[0.         0.01886792 0.86792453 0.86792453 0.94339623 0.94339623
 0.98113208 0.98113208 1.         1.        ]
Optimal thresholds:
[2.00000000e+00 1.00000000e+00 9.39251068e-01 9.28758892e-01
 8.62519599e-01 7.34708679e-01 6.73824037e-01 2.39038287e-01
 2.23663185e-01 1.80054591e-06]
Реализация scikit-learn
sk_roc_auc = roc_auc_score(y_test, y_pred_probas)
sk_fpr, sk_tpr, sk_thresholds = roc_curve(y_test, y_pred_probas)
print(f'AUC (scikit-learn): {sk_roc_auc}', '', sep='\n')
print('Optimal False Positive Rates (scikit-learn):', sk_fpr, '', sep='\n')
print('Optimal True Positive Rates (scikit-learn):', sk_tpr, '', sep='\n')
print('Optimal thresholds (scikit-learn):', sk_thresholds, sep='\n')
AUC (scikit-learn): 0.9951781970649896
Optimal False Positive Rates (scikit-learn):
[0.         0.         0.         0.01111111 0.01111111 0.04444444
 0.04444444 0.12222222 0.12222222 1.        ]
Optimal True Positive Rates (scikit-learn):
[0.         0.01886792 0.86792453 0.86792453 0.94339623 0.94339623
 0.98113208 0.98113208 1.         1.        ]
Optimal thresholds (scikit-learn):
[2.00000000e+00 1.00000000e+00 9.39251068e-01 9.28758892e-01
 8.62519599e-01 7.34708679e-01 6.73824037e-01 2.39038287e-01
 2.23663185e-01 1.80054591e-06]
PR-AUC (Precision-Recall AUC) и Average Precision (AP)
Для несбалансированных данных гораздо информативнее смотреть на кривую Precision-Recall и площадь под ней (PR-AUC) или на метрику Average Precision.
Эти метрики фокусируются на работе с положительным классом и не учитывают истинно отрицательные срабатывания (TN), что делает их более чувствительными к дисбалансу.
precisions, recalls, _ = precision_recall_curve(y_test, y_pred_probas)
pr_auc_score = auc(recalls, precisions)
print(pr_auc_score)
0.9924452566260418
В scikit-learn существует альтернативная метрика- Average Precision. Её основное отличие заключается в том, что для расчёта не используется линейная интерполяция.
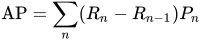
ap_score = average_precision_score(y_test, y_pred_probas)
print(ap_score)
0.992511694643552
Если мы ищем редкие случаи мошенничества (1% от всех операций), PR-AUC даст гораздо более адекватную оценку качества модели, чем ROC-AUC.
Многоклассовая классификация: стратегии усреднения
Когда классов больше двух, метрики для каждого класса вычисляются отдельно, а затем усредняются. Существует три основные стратегии.
Micro-average: Учитывает общее количество TP, FP, FN по всем классам. Фактически, взвешивает вклад каждого класса по его размеру. Близка к глобальной accuracy.
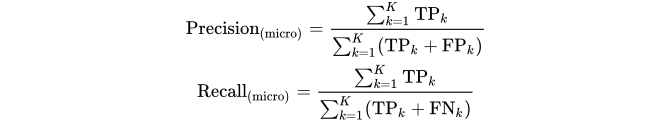
Macro-average: Простое среднее арифметическое метрик по всем классам. Дает всем классам одинаковый вес, что важно, если все классы equally важны, независимо от их размера.
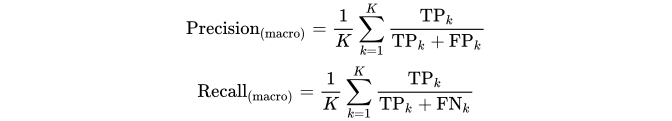
Weighted average: Среднее арифметическое, взвешенное по количеству объектов в каждом классе. Учитывает дисбаланс, но не решает проблему "неважности" малых классов.
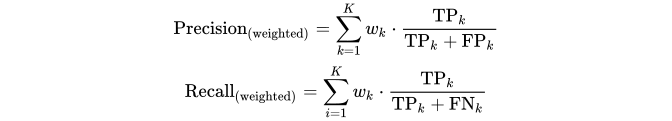
Для лучшего понимания рассмотрим пример с подсчётом наиболее популярных метрик на данных Red Wine Quality. Для этого воспользуемся функцией classification_report из scikit-learn.
Загрузка датасета
red_wine = pd.read_csv("/content/drive/MyDrive/winequality-red.csv")
print(red_wine)
X = red_wine.drop(columns='quality', axis=1)
y = red_wine['quality']
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)
      fixed acidity  volatile acidity  citric acid  residual sugar  chlorides  \
0               7.4             0.700         0.00             1.9      0.076
1               7.8             0.880         0.00             2.6      0.098
2               7.8             0.760         0.04             2.3      0.092
3              11.2             0.280         0.56             1.9      0.075
4               7.4             0.700         0.00             1.9      0.076
...             ...               ...          ...             ...        ...
1594            6.2             0.600         0.08             2.0      0.090
1595            5.9             0.550         0.10             2.2      0.062
1596            6.3             0.510         0.13             2.3      0.076
1597            5.9             0.645         0.12             2.0      0.075
1598            6.0             0.310         0.47             3.6      0.067
      free sulfur dioxide  total sulfur dioxide  density    pH  sulphates  \
0                    11.0                  34.0  0.99780  3.51       0.56
1                    25.0                  67.0  0.99680  3.20       0.68
2                    15.0                  54.0  0.99700  3.26       0.65
3                    17.0                  60.0  0.99800  3.16       0.58
4                    11.0                  34.0  0.99780  3.51       0.56
...                   ...                   ...      ...   ...        ...
1594                 32.0                  44.0  0.99490  3.45       0.58
1595                 39.0                  51.0  0.99512  3.52       0.76
1596                 29.0                  40.0  0.99574  3.42       0.75
1597                 32.0                  44.0  0.99547  3.57       0.71
1598                 18.0                  42.0  0.99549  3.39       0.66
      alcohol  quality
0         9.4        5
1         9.8        5
2         9.8        5
3         9.8        6
4         9.4        5
...       ...      ...
1594     10.5        5
1595     11.2        6
1596     11.0        6
1597     10.2        5
1598     11.0        6
[1599 rows x 12 columns]
Первое, что можно заметить - классификатор справился не очень хорошо. Следующим интересным наблюдением является то, что из-за сильного дисбаланса классов не все классы были спрогнозированы, метрики для некоторых классов помечены нулями.
В данном случае микро-усреднение (accuracy) показало завышенные результаты, а макро показывает более реальную картину при. Взвешенное усреднениепоказало способность модели определять наиболее распространённые классы.
ovr_model = LogisticRegression(multi_class='ovr', max_iter=1000)
ovr_model.fit(X_train, y_train)
y_pred = ovr_model.predict(X_test)
clf_report = classification_report(y_test, y_pred)
print(clf_report)
    accuracy                           0.62       400
   macro avg       0.29      0.27      0.27       400
weighted avg       0.58      0.62      0.59       400
Метрики регрессии: Оцениваем (bias) и разброс (variance)
В задачах регрессии мы предсказываем непрерывную величину (цену, спрос, температуру). Ошибка здесь — это мера того, насколько наши предсказания отклоняются от реальных значений.
Импорт необходимых библиотек
import numpy as np
import pandas as pd
from sklearn.preprocessing import LabelEncoder
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import (mean_absolute_error, mean_absolute_percentage_error,
                             mean_squared_error, mean_squared_log_error, r2_score)
Загрузка датасета
df_path = "/content/drive/MyDrive/insurance.csv"
insurance_cost = pd.read_csv(df_path)
print(insurance_cost)
X = insurance_cost.drop(columns='charges', axis=1)
y = insurance_cost['charges']
cat_features_list = X.select_dtypes(include=['object']).columns
X[cat_features_list] = X[cat_features_list].apply(LabelEncoder().fit_transform)
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)
      age     sex     bmi  children smoker     region      charges
0      19  female  27.900         0    yes  southwest  16884.92400
1      18    male  33.770         1     no  southeast   1725.55230
2      28    male  33.000         3     no  southeast   4449.46200
3      33    male  22.705         0     no  northwest  21984.47061
4      32    male  28.880         0     no  northwest   3866.85520
...   ...     ...     ...       ...    ...        ...          ...
1333   50    male  30.970         3     no  northwest  10600.54830
1334   18  female  31.920         0     no  northeast   2205.98080
1335   18  female  36.850         0     no  southeast   1629.83350
1336   21  female  25.800         0     no  southwest   2007.94500
1337   61  female  29.070         0    yes  northwest  29141.36030
[1338 rows x 7 columns]
Обучение линейной регрессии
model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
print(y_pred)
[10947.91401491  9764.82733066 38027.18625354 16076.26656375
  7003.05093861  4162.38974052  1745.17453352 14273.5330135
  9022.7490154   7548.70107263  4742.33662827 10290.75344147
  8592.56051588  4173.37165612 27970.0324915  11026.04778351
 11286.00941429  6197.06911697  8269.51468144 27263.01056172
 33686.9512703  14247.8812616  11735.79293452 32419.5578177
  4475.57228648  9264.65728706  1336.5408973  10083.42064465
  4134.01766875 10422.0367284   9033.04363126 40177.36502272
 15327.89185262 13541.84076855 24979.41529438  5273.0794857
 12809.44891047 30538.99654744 33503.98483751  3477.84775709
  4169.03343497  4346.93367013 30642.90398321 39366.95813634
 28066.36347631  5110.98142166 10919.49675465  7870.63024919
  3790.77872548 10529.86942143  5758.50260778  3526.36470247
 32837.53966438 38431.60954739 16119.53210068  7198.88399648
  6010.47765564  9455.45703492  9323.82247057 11736.15685931
  1745.70435635 38856.13381995 15133.33969997 11575.03834933
 14071.5724629  13696.5272597  26189.53137674 32224.3994756
  1285.84165993 10192.3389615  12103.18984314 11812.13268915
 25146.32331141 15738.43743924 11190.33714978 12666.511048
  6443.77417808  9893.21714388 30312.26136507 38774.44771196
 12063.1199766  37348.74819938  4280.83232304  9194.1511214
 34855.84194627 29249.62417709  8369.44588068  4945.57095651
 11829.89576319 30234.75411865 10099.95369361 11152.51466685
  8345.39483062  9216.66152856  8456.71908548  7389.90572249
 36031.82502924 32995.87707694  7647.03076484 14761.02404168
  4335.42273688  8790.6336137   6626.82252505 31798.31619795
 33017.1906077   2094.40570673  8884.5733591   6639.27260791
 14530.96799671 36943.676041   10209.36205958 10754.28354013
 10198.39675302 27099.34704068 39995.94299687  8600.67413204
   283.08058982  8834.31659717 14929.5620573   9589.03267786
 35399.75956117  7345.60983793 16567.9444266   9694.5508457
  8068.18149856  3097.01655573 33001.67961343 31570.2503123
 39236.13757102  5563.9838186   9605.43014551  3923.56950664
  7936.19344017  8758.93978756 31529.93069335 29783.93576815
 30140.52767905  9084.18593446 32774.6651671   3447.8282725
  3714.75872713 11106.90396946 13347.95952139 12853.99458907
  5528.91820808 15704.83891849 15079.88363053  2544.67843054
   185.77752153 10942.26089435  7512.81091318 32029.66886541
 12399.16046026  2715.99117956  6398.9448798   8153.13247564
  4485.58951977  2502.88912184 11354.3765072  12473.86448172
  7378.57534425 16486.02707379 11773.13898945 13764.75456224
  3381.59967736  7414.52171201 23083.99616223  7702.25146492
  5640.00381695  5423.20666932  6771.22658553  5369.21237435
  9978.65825664  5651.47058169  5617.05819013  6992.25772557
  3927.54466569  5677.34987188 38108.35355982  1687.47789286
 12570.90785396  8990.57884784 13663.12241126  5692.74305794
  5400.09622194 36497.28911925  4499.38119881  1950.64760943
 15075.82279197 12681.99346283 35147.22262059  5131.27114327
  5547.26999983 31572.7189971   6167.37488999  2062.03461108
  8544.26381135 10074.42722051  8266.17437786  5850.88787567
 13147.1222075  38635.78272386 13659.93211399 28800.64409693
  6812.19498243 35711.06603231  3973.45030397 12098.25000178
  9304.02766868  6456.8508697  11306.30379171 14517.23252599
  5259.7484308   4261.74861629  7739.96622866  1287.11803755
  8007.7029553   4603.7389562  13174.33476059  4491.67379326
  9853.36083563  7375.34455594  9072.2189463   2578.72399596
 12933.69851212 16674.51032722 15098.07149349 10382.93145759
  5750.15941467  2634.44325287  2301.36074417 13447.00625685
 14203.53207008  5171.47470846  4159.8794872   9287.91215283
 10048.86025637 28387.85591072  7761.85208288 10586.09180311
  6147.09690682 29867.2455107  10866.38256904  7609.85428543
 10248.41393685 12190.90620035  3216.69032739 10786.13583408
  1735.08998421  7194.492167   28788.15185516 38398.20353488
  6171.96169948  8372.97420985  2665.38796458   675.24311869
 10324.23779113  4464.24740958  5084.62925272  2765.12366764
  7255.30324083 33205.81109315 38215.02085724 14677.52426265
  8294.91587575 16028.83595951 33133.59667833  9623.53886742
 33401.64850545  3686.52411934 30843.71540422  8001.71986381
 14179.94621339  4211.35722232 32497.0827103   8443.10889356
 11460.8623175   9434.21047718  4321.92599873 12464.24068476
 11701.49681152  8483.560458   13344.98515219  2972.12577494
 10675.86128124  5389.8245388  11159.3820939  31723.46535925
 10047.84307228  1472.76142561   717.98703914 39821.97375226
  9812.26823742  7166.20953879 13905.32236228 13428.33354475
 27218.10087176  7033.74308314  6785.64013095 11933.98289128
  3038.43915783  4022.38383321 25307.2029606  26414.33042405
 13250.32827696  3471.9145674   5176.44334405  9222.66486622
 12506.28838182 23844.27532952 30900.61492849  9893.41699449
 24249.49669032  3004.11445538 11542.47299099  7624.09099954
  8366.614262     502.36290308  7920.24301719 35599.63593964
  6316.23859849  6413.28197074   427.51684841 10843.82978818
  6793.9564125   9939.5724268  38715.2046951  27842.86075012
 11591.34753748 35624.43529894 14993.0317229   6934.89010657
 10983.73053465  6810.5049236  36668.7011676 ]
MAE (Mean Absolute Error): Средняя абсолютная ошибка
MAE = (1/n) * Σ|y_i - ŷ_i|
Показывает среднее значение отклонения прогноза от фактического значения.
Плюсы: Простота расчета и интерпретации. Устойчива к выбросам.
Минусы: Не распознает большие ошибки так же сильно, как MSE. Не показывает направление ошибки.
MAE не дает представления о масштабе ошибки относительно самих значений. Ошибка в 1000 единиц может быть катастрофической для прогноза цен на хлеб и незначительной — для прогноза бюджета крупной корпорации.
ef mae_score(y_true, y_pred):
    n = len(y_true)
    return 1 / n * np.sum(np.abs(y_true - y_pred))
mae = mae_score(y_test, y_pred)
sk_mae = mean_absolute_error(y_test, y_pred)
print(f'mae: {mae}')
print(f'mae(scikit-learn): {sk_mae}')
mae: 3998.2715408869726
mae(scikit-learn): 3998.2715408869726
Полученная ошибка не может показать напрямую как сильно ошибается модель. В зависимости от контекста точно такое же значение MAE может быть как хорошим, так и плохим результатом. Представим, что нам необходимо спрогнозировать на какую сумму сеть магазинов продаст бананы. Для этого смоделируем новые данные на основе предыдущих, добавив значение 10000.
true_sales = y_test + 10_000
pred_sales = y_pred + 10_000
mae_for_sales = mean_absolute_error(true_sales, pred_sales)
print(f'mae(for sales): {mae_for_sales}')
mae(for sales): 3998.2715408869726
Несмотря на одинаковые MAE, в одном случае качество модели будет лучше, чем в другом. В такой ситуации целесообразно рассматривать не абсолютную, а относительную ошибку на объектах.
MAPE & SMAPE
Mean Absolute Percentage Error позволяет оценить в процентах насколько прогнозы модели отличаются относительно реальных значений:
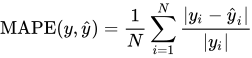
def mape_score(y_true, y_pred):
    n = len(y_true)
    numerator = np.abs(y_true - y_pred)
    denominator = np.abs(y_true)
    return  1 / n * np.sum(numerator / denominator)
mape = mape_score(y_test, y_pred)
sk_mape = mean_absolute_percentage_error(y_test, y_pred)
mape_for_sales = mean_absolute_percentage_error(true_sales, pred_sales)
print(f'mape: {mape}')
print(f'mape(scikit-learn): {sk_mape}')
print(f'mape(for sales): {mape_for_sales}')
mape: 0.4138713715103651
mape(scikit-learn): 0.4138713715103651
mape(for sales): 0.15963240527305983
Теперь видно, что модель в первом случае ошибается гораздо сильнее. Однако MAPE не подходит для случаев, когда хотя бы одно фактическое значение равно нулю, что видно из формулы. В таком случае можно использовать симметричную MAPE или Symmetric Mean Absolute Percentage Error:
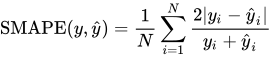
def smape_score(y_true, y_pred):
    n = len(y_true)
    numerator = 2 * np.abs(y_true - y_pred)
    denominator = (y_true + y_pred)
    return  1 / n * np.sum(numerator / denominator)
smape = smape_score(y_test, y_pred)
print(f'smape: {smape}')
smape: 0.3573799807309885
WAPE
MAPE также применима не во всех условиях. Она плохо справляется при анализе временных рядов с сезонными колебаниями. Для такого случая лучше подходит Weighted Average Percentage Error, которая нормализует общую ошибку к общей сумме фактических значений:
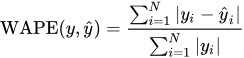
Так, продажи мороженого имеют ярко выраженную сезонность, при этом продажи в летние месяцы значительно выше, чем в зимние. В этом случае WAPE покажет более реальную оценку.
def wape_score(y_true, y_pred):
    numerator = np.sum(np.abs(y_true - y_pred))
    denominator = np.sum(np.abs(y_true))
    return numerator / denominator
wape = wape_score(y_test, y_pred)
print(f'wape: {wape}')
wape: 0.29762832405759587
MSE (Mean Squared Error) и RMSE: Учитываем большие ошибки
MSE = (1/n) * Σ(y_i - ŷ_i)^2
Метрика полезна тогда, когда нужно сделать акцент на больших ошибках и выбрать модель, которая допускает их меньше всего.
def mse_score(y_true, y_pred):
    n = len(y_true)
    return 1 / n * np.sum((y_true - y_pred) ** 2)
mse = mse_score(y_test, y_pred)
sk_mse = mean_squared_error(y_test, y_pred)
print(f'mse: {mse}')
print(f'mse(scikit-learn): {sk_mse}')
mse: 32073628.560109198
mse(scikit-learn): 32073628.560109198
Чтобы придать значению MSE размерность исходных данных, из него извлекается квадратный корень. Это Root Mean Squared Error , чье основное преимущество заключается в лучшей интерпретируемости по сравнению с MSE:
RMSE = √(MSE)
rmse = np.sqrt(mse)
print(f'rmse: {rmse}')
rmse: 5663.358417062193
MSE усредняет квадраты ошибок, а RMSE возвращает ошибку к исходным единицам измерения.
MSE сильно штрафует за большие ошибки, что часто полезно на практике.
Данная метрика чрезвычайно чувствительна к выбросам. Из-за квадрата труднее интерпретировать.
Например, если в данных есть аномалия (например, опечатка в данных о стоимости дома: 100 000 вместо 1 000 000), всего одно такое значение может катастрофически испортить MSE.
MSLE & RMSLE
Ещё один способ перехода к относительным ошибкам - их измерение в логарифмическом масштабе - Mean Squared Logarithmic Error:
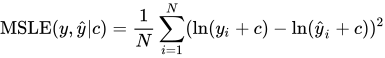
Данная метрика более устойчива к выбросам. С другой стороны, ее труднее интерпретировать.
def msle_score(y_true, y_pred, c=1):
    n = len(y_true)
    return 1 / n * np.sum((np.log(y_true + c) - np.log(y_pred + c)) ** 2)
msle = msle_score(y_test, y_pred)
sk_msle = mean_squared_log_error(y_test, y_pred)
print(f'msle: {msle}')
print(f'msle(scikit-learn): {sk_msle}')
msle: 0.2966547825040618
msle(scikit-learn): 0.2966547825040618
Соответственно, чтобы оценить значение MSLE относительно размерности исходных данных, используется Root Mean Squared Logarithmic Error:
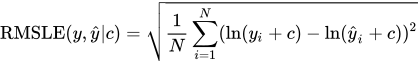
rmsle = np.sqrt(msle)
print(f'rmsle {rmsle}')
rmsle 0.5446602450189125
R2 & Adjusted R2
Иногда бывает трудно понять насколько хорошее или плохое значение рассчитанной ошибки. К счастью, существует нужная в этом случае метрика и это коэффициент детерминации , который показывает какая доля дисперсии целевых значений объясняется моделью:
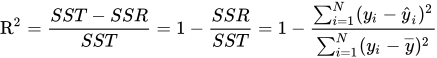
def manual_r2_score(y_true, y_pred):
    ssr = np.sum((y_true - y_pred) ** 2)
    sst = np.sum((y_true - y_true.mean()) ** 2)
    return 1 - ssr / sst
r2 = manual_r2_score(y_test, y_pred)
sk_r2 = r2_score(y_test, y_pred)
print(f'r2: {r2}')
print(f'r2(scikit-learn): {sk_r2}')
r2: 0.7962732059725786
r2(scikit-learn): 0.7962732059725786
Стоит отметить, что R2 также имеет свои ограничения. Данная метрика имеет тенденцию к увеличению при добавлении в обучающий набор новых признаков, даже если они не улучшают качество модели.
В таком случае сравнение моделей с разным количеством признаков становится некорректным, поэтому специально для этой цели используется скорректированный Adjusted R2
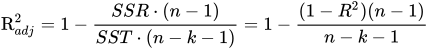
def adjusted_r2_score(y_true, y_pred, x_shape):
    n, k = x_shape
    ssr = np.sum((y_true - y_pred) ** 2)
    sst = np.sum((y_true - y_true.mean()) ** 2)
    r2 = 1 - ssr / sst
    return 1 - (1 - r2) * (n - 1) / (n - k - 1)
r2_adj = adjusted_r2_score(y_test, y_pred, X.shape)
print(f'r2 adjusted: {r2_adj}')
r2 adjusted: 0.7953548282384204
Bias-Variance Decomposition: Диагностика переобучения и недообучения
Ошибка любой модели машинного обучения может быть разложена на три компонента:
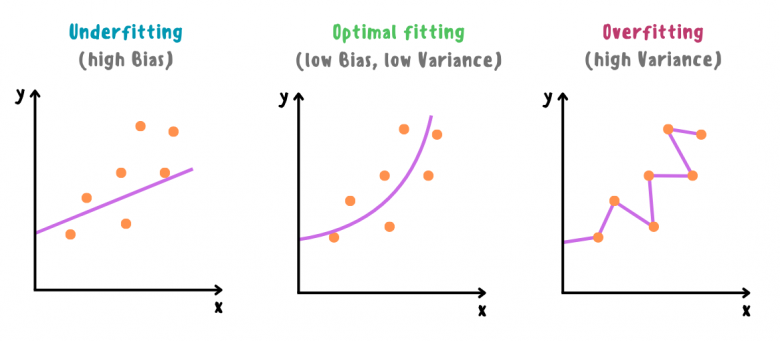
Смещение (Bias): систематическая ошибка, вызванная слишком простыми допущениями модели. Высокое смещение leads to недообучению (underfitting) — модель не может уловить сложные взаимосвязи в данных. Лечение: Усложнение модели (добавление признаков, уменьшение регуляризации).
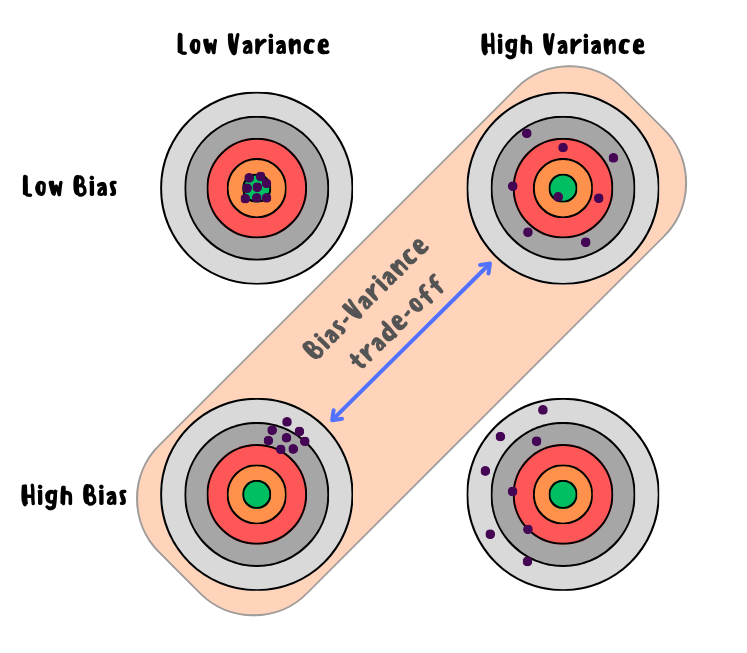
Разброс (Variance): Ошибка, вызванная чувствительностью модели к небольшим изменениям в обучающих данных. Высокий разброс leads to переобучению (overfitting) — модель "заучивает" тренировочные данные, включая шум, и плохо обобщается на новые. Лечение: Упрощение модели, сбор большего количества данных, усиление регуляризации, ансамбли.
Неустранимая ошибка (Irreducible Error): Шум в данных, который принципиально невозможно предсказать.
Компромисс (Bias-Variance Trade-off) — это фундаментальная проблема машинного обучения. Мы не можем одновременно минимизировать и смещение, и разброс. Задача — найти оптимальный уровень сложности модели, где суммарная ошибка минимальна.
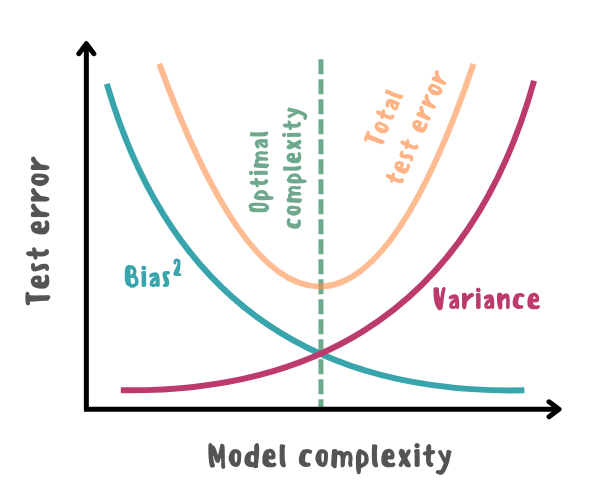
Этот график показывает, что существует оптимальная сложность модели, где ошибка минимальна и при этом также соблюдается баланс между переобучением и недообучением. Ниже - пример для линейной регрессии.
С появлением глубоких нейронных сетей и сложных ансамблей был обнаружен феномен "двойного спуска" (double descent), когда при дальнейшем увеличении сложности модели (после точки переобучения) ошибка снова начинает снижаться. Это показывает, что классический U-образный вид кривой ошибки не всегда справедлив для самых современных алгоритмов.
Метрики кластеризации: искусство оценки без учителя
Оценить качество кластеризации сложнее, так как у нас часто нет ground truth (истинных меток). Метрики делятся на внешние (если метки есть) и внутренние (если меток нет).
Внешние метрики (есть истинные метки):
- Adjusted Rand Index (ARI): Измеряет сходство между двумя кластеризациями (нашей и истинной), скорректированное на случайность. Значение от -1 до 1, где 1 — полное совпадение. Лучшая метрика для общего случая.
- Adjusted Mutual Information (AMI): Аналогична ARI, но основана на теории информации (взаимной информации между кластерами).
- Homogeneity (Все объекты внутри кластера принадлежат одному классу), Completeness (Все объекты данного класса попали в один кластер), V-measure (Гармоническое среднее Homogeneity и Completeness.)
- Fowlkes-Mallows Index (FMI): Геометрическое среднее между precision и recall для кластеров.
Внутренние метрики (нет истинных меток):
- Silhouette Score: Оценивает, насколько объект похож на свой собственный кластер (compactness) и не похож на другие кластеры (separation). Значения от -1 до 1. Чем выше, тем лучше. Отлично подходит для подбора оптимального числа кластеров.
- Calinski-Harabasz Index: Отношение межкластерной дисперсии к внутрикластерной. Чем выше, тем лучше кластеры разделены.
- Davies-Bouldin Index: Среднее measure сходства между кластерами. Чем ниже значение, тем лучше кластеры разделены.
Рассмотрим подробнее каждую из этих метрик на сгенерированных данных make blobs.
Импорт библиотек
import numpy as np
from sklearn.datasets import make_blobs
from sklearn.cluster import AffinityPropagation
from sklearn.metrics import (rand_score, adjusted_rand_score, mutual_info_score,
                             normalized_mutual_info_score, adjusted_mutual_info_score,
                             homogeneity_score, completeness_score, v_measure_score,
                             homogeneity_completeness_v_measure, fowlkes_mallows_score,
                             silhouette_score, calinski_harabasz_score, davies_bouldin_score)
Загрузка датасета
X, y = make_blobs(n_samples=75, n_features=2, centers=5, random_state=0)
print(y)
[0 3 4 3 2 4 0 2 0 4 2 4 2 2 0 0 0 3 2 0 2 2 2 3 4 1 1 2 3 0 4 4 3 3 3 2 2
 0 1 1 3 1 0 2 4 1 4 4 0 4 1 0 3 0 4 1 2 1 4 3 1 1 3 0 3 4 1 2 1 4 0 3 1 1
 3]
Обучение Affinity Propagation
ap = AffinityPropagation()
y_pred = ap.fit_predict(X)
print(y_pred)
[2 0 1 2 3 1 2 3 2 1 3 1 3 4 2 2 2 0 3 2 3 3 2 0 1 4 4 3 0 3 1 1 0 0 0 3 3
 2 4 4 0 4 2 3 1 4 1 1 4 1 4 2 0 2 1 4 3 4 1 0 4 4 0 2 0 1 4 3 3 1 2 0 4 4
 0]
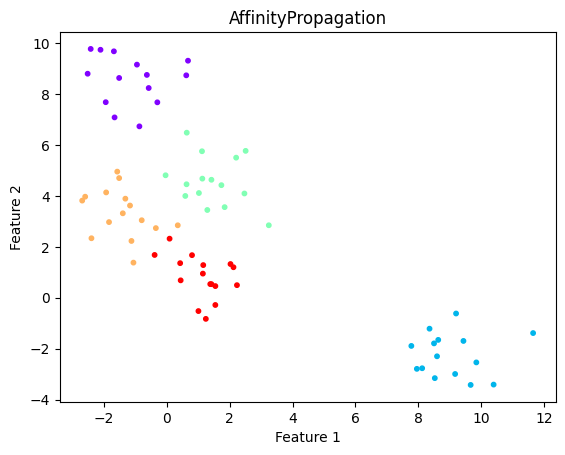
Визуализация полученной кластеризации
plt.scatter(X[:, 0], X[:, 1], c=y_pred, cmap='rainbow', s=10)
plt.title('AffinityPropagation')
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
Rand Index & Adjusted Rand Index (ARI)
Одни из самых простых метрик. Rand Index измеряет количество пар элементов, отнесённых к одинаковым и разным кластерам относительно общего количества возможных пар в данных, игнорируя перестановки:
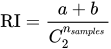
ri = rand_score(y, y_pred)
print(f'rand index: {ri}')
rand index: 0.9405405405405406
Нормировав данный индекс, можно снизить ожидаемый ERI и таким образом избавиться от негативного эффекта выше. Тогда получим скорректированную оценку, известную как Adjusted Rand Index (ARI):
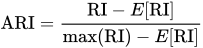
ari = adjusted_rand_score(y, y_pred)
print(f'adjusted rand index: {ari}')
adjusted rand index: 0.8063318846556483
Mutual Information & Adjusted Mutual Information (AMI)
Взаимная информация Mutual Information определяет меру различия между совместным распределением пары меток U, V и произведением их маргинальных распределений.
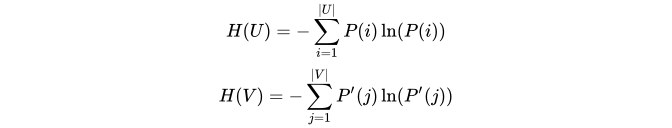
Взаимная информация между U и V определяется как:
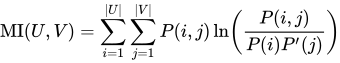
mi = mutual_info_score(y, y_pred)
print(f'mutual index: {mi}')
mutual index: 1.3165387166969102
Отсюда также можно получить нормализованную версию, то есть Normalized Mutual Information (NMI):
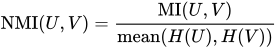
nmi = normalized_mutual_info_score(y, y_pred)
print(f'normalized mutual index: {nmi}')
normalized mutual index: 0.8182376204426293
Однако обе эти метрики не учитывают случайность разбиений. Для устранения этих недостатков используется Adjusted Mutual Information (AMI)
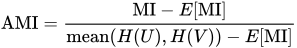
где ожидаемое значение взаимной информации рассчитывается как:
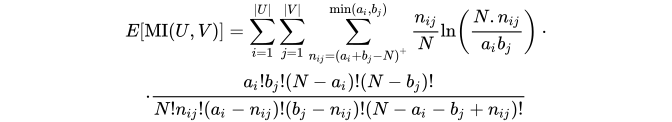
ami = adjusted_mutual_info_score(y, y_pred)
print(f'adjusted mutual index: {ami}')
adjusted mutual index: 0.8036319585502079
Homogeneity, Completeness & V-measure
гомогенность — мера того, насколько каждый кластер содержит объекты только одного класса:
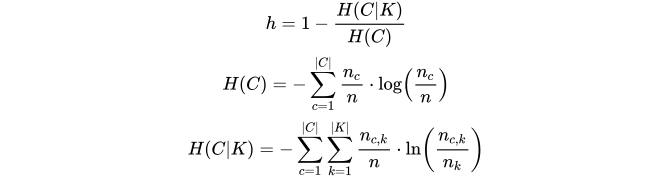
полнота — мера того, насколько все объекты одного класса принадлежат одному и тому же кластеру:
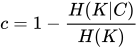
Если же необходимо учитывать гомогенность и полноту одновременно, то есть обеспечить между ними баланс, то используется V-мера:
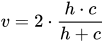
homogeneity = homogeneity_score(y, y_pred)
completeness = completeness_score(y, y_pred)
v_measure = v_measure_score(y, y_pred)
print(f'homogeneity: {homogeneity}')
print(f'completeness: {completeness}')
print(f'v measure: {v_measure}')
homogeneity: 0.8180114973840702
completeness: 0.8184638685502272
v measure: 0.8182376204426292
Следует добавить, что все 3 метрики хорошо интерпретируемые. Также помимо этого, в scikit-learn имеется возможность получить все три метрики сразу.
hcv = homogeneity_completeness_v_measure(y, y_pred)
print('homogeneity, completeness, v measure:', hcv, sep='\n')
homogeneity, completeness, v measure:
(0.8180114973840702, 0.8184638685502272, 0.8182376204426292)
Fowlkes-Mallows Index (FMI)
Confusion matrix также может быть использована в задачах кластеризации. В таком случае можно получить Fowlkes-Mallows Index (FMI), если взять геометрическое среднее между precision и recall:
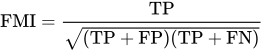
fmi = fowlkes_mallows_score(y, y_pred)
print(f'Fowlkes-Mallows index: {fmi}')
Fowlkes-Mallows index: 0.8430070419125244
Silhouette Coefficient
Данный коэффициент показывает насколько в среднем объекты схожи внутри одного кластера и различны с объектами других кластеров.
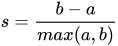
silhouette = silhouette_score(X, y_pred)
print(f'silhouette: {silhouette}')
silhouette: 0.5796452132316384
Calinski-Harabasz Index (CHI)
Также известный как критерий соотношения дисперсий (VRC), представляет собой отношение сумм межкластерной и внутрикластерной дисперсий:
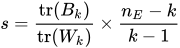
Чем выше значение Калински-Харабаша, тем более чётко модель определяет кластеры.
chi = calinski_harabasz_score(X, y_pred)
print(f'Calinski-Harabasz index: {chi}')
Calinski-Harabasz index: 305.667448634445
Davies-Bouldin Index (DBI)
Показывает среднее сходство между кластерами, которое определяется как мера, сравнивающая межкластерное расстояние с размером самих кластеров:
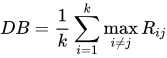
dbi = davies_bouldin_score(X, y_pred)
print(f'Davies-Bouldin index: {dbi}')
Davies-Bouldin index: 0.546114132526905
Какую метрику выбрать?
Не существует панацеи. Выбор метрики — это сложное решение, основанное на глубоком понимании бизнес-задачи.
Для классификации всегда начинайте с матрицы ошибок. При дисбалансе классов игнорируйте Accuracy.
Определите, что дороже: False Positive или False Negative? Выбирайте Precision или Recall соответственно.
Для баланса используйте F1-Score, для оценки качества ранжирования и сравнения моделей - ROC-AUC.
При сильном дисбалансе используйте PR-AUC или Average Precision.
Для регрессии начинайте с MAE и RMSE для понимания масштаба ошибки. Для отчета руководству используйте MAPE/WAPE. Чтобы показать, насколько ваша модель лучше простого среднего, используйте R², а для сравнения моделей — Adjusted R².
Что касается кластеризации. Если есть истинные метки, используйте Adjusted Rand Index (ARI).
Если меток нет, используйте Silhouette Score для подбора числа кластеров, но всегда визуализируйте результат.
Помните, правильная метрика — это не просто число, это мост между технической моделью и бизнес-результатом.
FAQ
Вопрос: Какая метрика ML-модели самая важная?
Ответ: Единственной универсальной метрики нет. Важность метрики зависит от задачи, бизнес-цели, цены ошибки, дисбаланса классов и того, как результат модели будет использоваться.
Вопрос: Почему accuracy может вводить в заблуждение?
Ответ: Accuracy показывает долю правильных ответов, но при дисбалансе классов может выглядеть высокой даже у плохой модели. Например, если редкий класс встречается в 1% случаев, модель может почти всегда предсказывать основной класс и получать высокую accuracy.
Вопрос: Чем precision отличается от recall?
Ответ: Precision показывает, какая доля положительных предсказаний оказалась правильной. Recall показывает, какую долю реальных положительных объектов модель смогла найти.
Вопрос: Когда использовать F1-score?
Ответ: F1-score полезен, когда нужно сбалансировать precision и recall, особенно при дисбалансе классов или когда важны и ложноположительные, и ложноотрицательные ошибки.
Вопрос: Какие метрики используют для регрессии?
Ответ: Для регрессии часто используют MAE, MSE, RMSE, MAPE и R². Они помогают оценить размер ошибки прогноза и объясняющую способность модели.
- Градиентный спуск в машинном обучении
- TF-IDF в машинном обучении
- LSTM в машинном обучении
- Кривая AUC и ROC с использованием Python
- Алгоритмы кластеризации в машинном обучении


