

Моделирование данных для CDP
Моделирование данных для CDP (Customer Data Platform) — это основа построения единого, доступного и управляемого профиля клиента, который может объединять данные из разных источников, поддерживать идентификацию пользователей и позволять активировать сегменты в маркетинговых и бизнес-процессах. В рамках курса «Использование BI и DWH при внедрении CDP» мы рассмотрим, как с точки зрения данных строится «360 градусов» клиента: какие сущности и связи понадобятся, какие парадигмы и методологии применяются, какие технологии позволяют реализовать эффективную модель, какие риски возникают и как их минимизировать. Данная глава адресована начинающим сотрудникам: вы познакомитесь с терминологией, практическими подходами, типовыми архитектурами и конкретными примерами реализации на открытом стеке и в российской экосистеме.
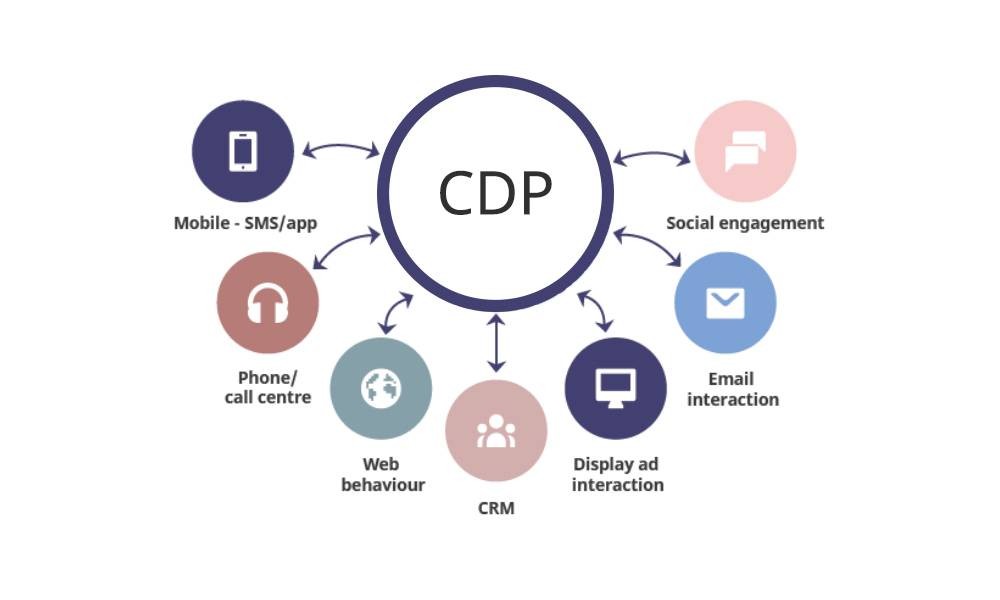
Что такое CDP и зачем нужна модель данных
CDP — это система, которая собирает, нормализует и объединяет данные о клиентах из различных источников, создаёт единый «профиль клиента» (customer 360), обеспечивает управление идентификацией, хранение атрибутов и событий, а также позволяет сегментировать аудиторию и активировать данные в внешних системах (магазины, CRM, рекламные платформы, сервисы аналитики). Основная идея — иметь единый источник правды по каждому клиенту и оперативно использовать этот источник для персонализации, аналитики и маркетинга.
Основные концепции моделирования данных для CDP
- Единый профиль клиента (Customer Profile, Customer 360). Это ядро модели: уникальный идентификатор клиента, набор атрибутов (личные данные, предпочтения, сегменты), связь с идентичностями из разных систем.
- Идентификация и граф идентичности (Identity Resolution, Identity Graph). Часть модели, которая сопоставляет записи об одном и том же человеке из разных источников (например, веб-сессия и CRM-обращение) через детерминированные и вероятностные связи.
- Источники и события (Sources and Events). Источники данных могут быть онлайн (веб и мобильное приложение), офлайн (розничные продажи, call-центр), сервисные данные (CRM, ERP) и т. д. События — это факты взаимодействий: просмотр страницы, добавление в корзину, покупка, подписка и т. п.
- Гранулированная модель владения атрибутами (Attributes), связанных через связи с профилем и событиями (Sessions, Campaigns, Segments, Preferences).
- Управление данными и качество (Data Governance, Data Quality). Включает правовую ответственность, приватность, согласие пользователей, устойчивость к ошибкам данных, полноту и согласованность.
- Модель владения данными и хранилищами (Storage and Processing). Этапы: ingestion (погрузка), нормализация, объединение данных, построение открытых атрибутов, создание индексов и агрегатов, а затем активирование сегментов.
Архитектурные паттерны моделирования
- Canonical Data Model (единая каноническая модель). Создаём набор базовых сущностей (Customer, Identity, Event, Product, Campaign, Attribute, Consent) и приводим данные источников к единому формату.
- Модель «Событие как первичный источник». Событие — это источник истины о взаимодействии клиента; профиль обновляется на основе событий и связан с идентичностями.
- Модель «Профиль-источник» (Profile-as-a-Record). Профиль клиента хранит ключевые атрибуты и ссылки на идентификаторы из разных систем. Источники могут позднее обновлять профиль через процессинг.
- Модель «Граф идентичности» (Identity Graph). Узлы — идентификаторы из разных источников, рёбра — связи между ними; граф позволяет гибко разрешать дубликаты и строить непрерывную идентичность.
- Модель «MDM/Градиентная» (Master Data Management). Управление «ключами» и «правилами согласования» для обеспечения единообразия и консистентности.
Типовые сущности и связи в модели CDP
- Customer (клиент): уникальный профиль, ключевые поля (customer_id, canonical_id), демография, контактные данные, согласия, предпочтения.
- Identity (идентичности): множество ключей из разных систем (email, phone, device_id, CRM_id, loyalty_id) и соответствия.
- Event (событие): event_id, type, timestamp, source, customer_id, attributes (категории: product, category, price, page_url, campaign_id).
- Session (сессия): session_id, customer_id, start_time, end_time, device, channel, geolocation.
- Product/Offer: product_id, SKU, category, price, attributes.
- Campaign/Activation: campaign_id, channel, medium, period, attribution model.
- Consent/Privacy: consent_id, type, status, timestamp, source, retention period.
- Attributes/Profiles: кастомные атрибуты клиента, источники данных, качество данных.
Методологии проектирования и качества данных
- Data governance и metadata management: ведение словаря данных, версионирование схем, хранение lineage (происхождения данных).
- Data quality: правила валидности, проверки полноты, согласованности, согласование форматов (например, даты, идентификаторы).
- Data lineage и traceability: возможность проследить, откуда взялся конкретный атрибут и как он изменялся во времени.
- Data privacy и compliance: управление согласием, ограничениями доступа, резидентность данных, применение методов минимизации данных (privacy-by-design).
- Эволюция схемы: управление версиями схем, миграции полей, backward/forward-compatibility, деградации и откаты.
Практические примеры
Архитектура на открытом стеке (Open-source)
- Источники: веб-сайт (события, клики), мобильное приложение (события), CRM (покупки, обращения), ERP (заказы), офлайн данные (розничные продажи).
- Ingestion: Apache Kafka как транспорт событий; Debezium для захвата изменений в базах данных CRM/ERP.
- Хранилище и обработка: Data Lake на базе Hadoop/S3-совместимого хранилища с Parquet; Apache Spark для ETL и нормализации; Apache Hudi или Delta Lake для upsert-логики и версионирования данных.
- Идентификация: реализация identity graph на основе Spark GraphFrames или Neo4j (open-source) для сопоставления идентификаторов клиентов; deterministic mapping по email/phone и probabilistic linkage для пользователей без явных совпадений.
- Хранилище профилей: ClickHouse как высокопроизводительная аналитическая СУБД для готовых профилей и сегментов; PostgreSQL/ClickHouse в роли слоя модели и быстрых агрегатов.
- Фича-стор (Feature store): хранение рассчитанных признаков клиента в отдельной таблице в ClickHouse или в PostgreSQL; возможна интеграция с ML-сервисами.
- В activation: экспорт сегментов в рекламные платформы (DSP/AdTech) через REST API, или выгрузка в CSV для загрузки вручную; BI-панели на базе Apache Superset или Metabase.
- Пример сценария: при заходе клиента на сайт событиеPageView отправляется в Kafka, Spark обогащает событие атрибутами продукта и user_id, обновляет профиль в ClickHouse и обновляет граф идентичности. Затем сегменты пользователя вычисляются на основе поведения и передаются в рекламную платформу.
Архитектура с российскими решениями
- Хранилище и аналитика: использование ClickHouse — российского происхождения движка колоночного хранения, подходящего для аналитических запросов и сегментации. Он хорошо масштабируется, поддерживает агрегации в реальном времени при больших нагрузках.
- Управление данными и СУБД: PostgreSQL и его российские форки (например, Postgres Pro) для транзакционных данных и справедливого обмена между системами. Для критических рабочих нагрузок можно рассмотреть совместное использование PostgreSQL и ClickHouse через ETL-потоки.
- Обработка и потоковая аналитика: Apache Kafka для потоковых данных, Apache Flink или Spark Structured Streaming для обработки в реальном времени и near-real-time обновлений профилей.
- Визуализация и BI: DataLens от Яндекса как инструмент визуализации и исследовательской аналитики; или open-source решения вроде Apache Superset.
- Облачная инфраструктура: Яндекс.Облако предоставляет сервисы для интеграции и хранения данных (управляемые базы данных, хранилище, сервисы обмена данными). Это позволяет держать данные в рамках российского дата-центра и снижает риски по локализации.
Пилотный пример реализации на открытом стеке
- Этап 1: сбор данных из источников через Kafka и Debezium; хранение «сырого» потока в Data Lake (Parquet) на S3-совместимом хранилище.
- Этап 2: нормализация и приведение к канонической модели с сущностями: Customer, Identity, Event, Session, Product, Campaign.
- Этап 3: построение identity graph через Spark GraphFrames; объединение идентификаторов на уровне профиля клиента.
- Этап 4: обновление профиля в ClickHouse и создание предикатов/атрибутов (features) для последующей аналитики и ML.
- Этап 5: создание сегментов на основе событий и атрибутов, экспорт в рекламные платформы и витрины BI.
- Этап 6: управление согласием и приватностью через раздел Consent и хранение информации в Privacy-aware моделях (например, псевдонимизация и ограничение доступа в соответствии с политикой.
Реализация конкретной задачи: построение профиля клиента и сегментов
- Шаг 1. Собрать общие атрибуты клиента (имя, email, телефон, пол, дата рождения) и идентификаторы (crm_id, device_id, email_id).
- Шаг 2. Интегрировать события: просмотр страниц, клики, покупки, возвраты; связать события с customer_id и session_id.
- Шаг 3. Разрешение идентичностей: применить deterministic соответствия по email/phone, а затем probabilistic связывание через модель на графе.
- Шаг 4. Обновление профиля в реальном времени: при каждом значимом событии обновлять лечение профиля и сегментов.
- Шаг 5. Сегментирование: создать правила сегментации (например, «частые покупатели за 30 дней» или «пользователи с высокой вовлеченностью»), сохранить как сегментированные представления и активировать через рекламные каналы.
- Шаг 6. Мониторинг качества: отслеживать полноту атрибутов, своевременность обновления, точность сопоставления идентификаторов.
Выбор стека
- Ингест: Apache Kafka (с брокером брокеры), Debezium для изменений в базах данных, коннекторы для источников.
- Обработка: Apache Spark (Structured Streaming) или Apache Flink для реального времени; GraphFrames или Neo4j для графа идентичности.
- Хранилище: ClickHouse для профилей и сегментов; Parquet в Data Lake (S3/облачное хранилище) для «сырого» и промежуточного слоя; PostgreSQL/Postgres Pro для транзакционной части.
- Управление данными и оркестрация: Apache Airflow; Git для версионирования схем; DVC или MLflow для управления ML-артами.
- BI и визуализация: Apache Superset, Metabase, DataLens (для российского рынка).
- Безопасность и приватность: шифрование в покое и в передаче; управление доступами через IAM; аудит изменений.
Архитектура данных и схема хранения
- Raw (сырые данные) -> Staging (нормализация) -> Core (каноническая модель: Customer, Identity, Event) -> Analytics (профили, сегменты) -> Activation (форматы экспорта в внешние системы).
- Версионирование схем: хранение версий схем (например, schema_version в метаданных), поддержка backward/forward-compatibility.
- Upsert-логика: для профилей и атрибутов применяем upsert-пайплайны через Delta Lake или Hudi, чтобы обновлять существующие записи без дублирования.
Управление идентичностями и граф идентичности
- deterministic matching: использование зафиксированных ключей (email, phone) с нормализацией (приведение к нижнему регистру, устранение пробелов).
- probabilistic matching: применение алгоритмов похожести (AND/OR, Jaccard, эвристики) и построение графа с учетом доверительных степеней.
- миграции и консолидации: периодический запуск процессов развязки идентификаторов и обновление графа.
Управление качеством данных
- Метрики полноты: доля записей с заполненными ключевыми полями.
- Согласованность: согласование форматов и единиц измерения между источниками.
- Тайминг: задержки во времени между событием и обновлением профиля.
- Контроль доступа: разграничение доступа к данным по ролям.
Безопасность и соответствие требованиям
- Регистрация согласий и политики согласия в профиле клиента.
- Локализация данных и хранение в рамках российского дата-центра при необходимости.
- Аудит доступа и журнал изменений.
Практические инструкции по внедрению
- Начать с минимального ядра: один источник, базовые события и единый профиль.
- Постепенно добавлять источники и расширять граф идентичности.
- Реализовать базовые правила сегментации и активации.
- Непрерывно мониторить качество данных и соответствие требованием privacy.
Риски и ограничения
Точность идентификации и слияние профилей
- Проблема: несовпадения в данных, слабая полнота идентификаторов.
- Риск: дублирование профилей, несогласованные сегменты, неэффективная активация.
- Митигирование: внедрять строгие правила сопоставления, использовать графовую обработку, периодически проводить аудиты соответствия.
Данные и приватность
- Проблема: обработка персональной информации, региональные требования, согласие пользователя.
- Риск: нарушение закона, штрафы, утрата доверия.
- Митигирование: политика минимизации данных, согласие и обновление статуса, псевдонимизация, контроль доступа, журнал аудита.
Качество данных и архитектура
- Проблема: разноформатные данные, пропуски, задержки обновления.
- Риск: неверные сегменты, задержки в активации.
- Митигирование: данные-купол, валидации на каждом этапе, мониторинг качества, повторные прогонки.
Масштабируемость и стоимость
- Проблема: рост объёмов событий, сложность графа идентичности.
- Риск: деградация производительности, рост затрат.
- Митигирование: выбор эффективных СУБД и движков, горизонтальное масштабирование, выбор прескриптивной архитектуры и кэширования.
Совместимость и интеграции
- Проблема: несовместимость между источниками и целевыми системами.
- Риск: простоют пайплайны и задержки.
- Митигирование: четко прописанные контракты форматов, версия контролируемых коннекторов, документирование изменений.
Правовые ограничения и локализация
- Проблема: требования к хранению данных в РФ, экспорт в-за пределы страны.
- Риск: нарушения регулятивных требований, санкции.
- Митигирование: соблюдение локальных правил, хранение данных в локальных дата-центрах, соответствие требованиям к удалению данных.
Безопасность эксплуатации
- Проблема: внешние атаки, уязвимости в компонентах стека.
- Риск: компрометация профилей и данных клиентов.
- Митигирование: обновления, мониторинг безопасности, режим минимальных прав доступа, аудит.
Моделирование данных для CDP — это не только создание схем и таблиц. Это проектирование единого, управляемого и масштабируемого профиля клиента, который может объединять данные из разных источников, обеспечивать точность идентификации и поддерживать активность сегментов в бизнес-процессах. Ключевые компоненты включают каноническую модель сущностей, граф идентичности, обработку событий и хранение профилей в высокопроизводительных хранилищах. Важно сочетать теорию с практикой: используйте открытые технологии для максимальной гибкости и возможности адаптации к бизнес-задачам, а также учитывайте российскую экосистему и требования к приватности и локализации данных. Риски можно минимизировать с помощью сильной управляемой архитектуры, политики качества данных, надлежащего управления согласием и строгого контроля доступа. В итоге вы получите надежную основу для персонализированного маркетинга, аналитики и операционного использования данных.
FAQ — Вопрос–Ответ
Что такое единый профиль клиента в CDP и зачем он нужен?
Единый профиль клиента — это совокупность идентификаторов, атрибутов и истории взаимодействий, объединенная под одним canonical_id. Он позволяет видеть клиента целиком независимо от источника: сайт, приложение, CRM, оффлайн-торговля. Это обеспечивает точность сегментов, персонализированные рекомендации и консистентную активацию в рекламных каналах, а также упрощает аналитику и ML-модели.
Какие основные сущности входят в каноническую модель данных для CDP?
Основные сущности — Customer (профиль клиента), Identity (идентичности из разных источников), Event (события взаимодействия), Session (сессии), Product/Offer (товары и акции), Campaign (кампании и атрибутика), Consent (согласия на обработку данных), а также Attributes (дополнительные атрибуты).
Что такое identity graph и как он работает на практике?
Identity graph — граф идентификаторов, где узлы представляют идентификаторы (email, phone, device_id, crm_id и т. д.), а связи показывают, что они относятся к одному человеку. На практике применяется deterministic сопоставление по ключам и probabilistic связывание по поведению и контексту. Это позволяет разрешать дубликаты и строить единый профиль даже если явное совпадение отсутствует.
Какие технологии чаще всего применяют для реализации CDP на открытом стеке?
Типичный открытый стек включает: Kafka для ingestion, Debezium для изменений баз данных, Spark или Flink для обработки потоков, GraphFrames или Neo4j для графов идентичности, ClickHouse для аналитических профилей и сегментов, Parquet/Delta Lake/Hudi для хранения данных, Apache Airflow для оркестрации, Superset или Metabase для BI и визуализации. Такой набор позволяет строить масштабируемую и гибкую архитектуру.
Какие российские решения можно использовать для CDP?
Ключевые элементы российской экосистемы: ClickHouse — движок колоночного хранения с сильной поддержкой аналитических нагрузок; PostgreSQL и его российские форки (Postgres Pro) для транзакционных задач; DataLens и другие инструменты визуализации; Яндекс.Облако предоставляет локальные сервисы облачных решений и интеграцию с российскими дата-центрами; эти инструменты позволяют держать данные в рамках РФ и обеспечивать локализацию.
Какие основные риски связаны с внедрением CDP и как их минимизировать?
Ключевые риски: несоответствие идентификаций, нарушение приватности, качество данных, масштабируемость и стоимость, совместимость систем. Митигирования включают: четкие правила сопоставления и аудит идентичности; согласия, приватность-by-design и контроль доступа; мониторинг качества данных; выбор подходящей архитектуры и масштабируемых технологий; документирование контрактов и версий схем.
Какую роль играет согласие и приватность в CDP?
Согласие и приватность — критичные элементы, так как CDP работает с персональными данными. Необходимо регистрировать типы согласий, хранить статус согласия, применять минимизацию данных и обеспечивать возможность удаления или анонимизации по запросу пользователя, а также обеспечивать аудит доступа и соответствие требованиям закона 152-ФЗ и другим регуляциям.
Каковы принципы эксплуатации и поддержки CDP в долгосрочной перспективе?
В долгосрочной перспективе важны: устойчивость архитектуры к росту данных, версионирование схем, мониторинг качества данных, управление линейкой источников и контрактами форматов, безопасность доступа и аудит, а также соответствие регулятивным требованиям. Регулярно проводите аудит профилей, обновляйте граф идентичности и поддерживайте SLA по задержкам обработки.
Какой минимально жизнеспособный стек для старта проекта CDP?
Минимальный стек может включать: Kafka для ingestion, Spark для обработки, Hive/Parquet или Delta Lake для хранения, ClickHouse для профилей и сегментов, и простой слой визуализации (Superset). Такой набор позволяет быстро запустить ядро: единый профиль, базовую идентификацию и сегменты, которые можно активировать и измерять.
Какие шаги помогут перейти к продвинутой модели CDP?
Делайте шаги: расширяйте источники и видимые каналы, внедряйте расширенную идентичность и обновление графа, внедряйте ML-вертикаль (персонализация, предиктивная аналитика), добавляйте более сложные политики согласий и приватности, усилите регламент управления данными и их lineage, оптимизируйте процесс активации сегментов в разные каналы и платформы, и постоянно оценивайте ROI внедрений.


