

Эксплуатация и поддержка сценарных моделей: governance и управление версиями
Сценарное планирование и what-if анализ становятся ключевыми элементами устойчивости бизнеса в условиях высокой волатильности рынка. Однако разработать высокоточную сценарную модель — это только половина задачи. Гораздо более сложной является задача ее эксплуатации (Productionalization): обеспечения надежности, воспроизводимости и аудируемости результатов на протяжении всего жизненного цикла планирования. Эта глава посвящена критически важным аспектам Governance (корпоративного управления) и управления версиями, которые трансформируют разовые аналитические эксперименты в масштабируемый, контролируемый и интегрированный корпоративный инструмент принятия решений.
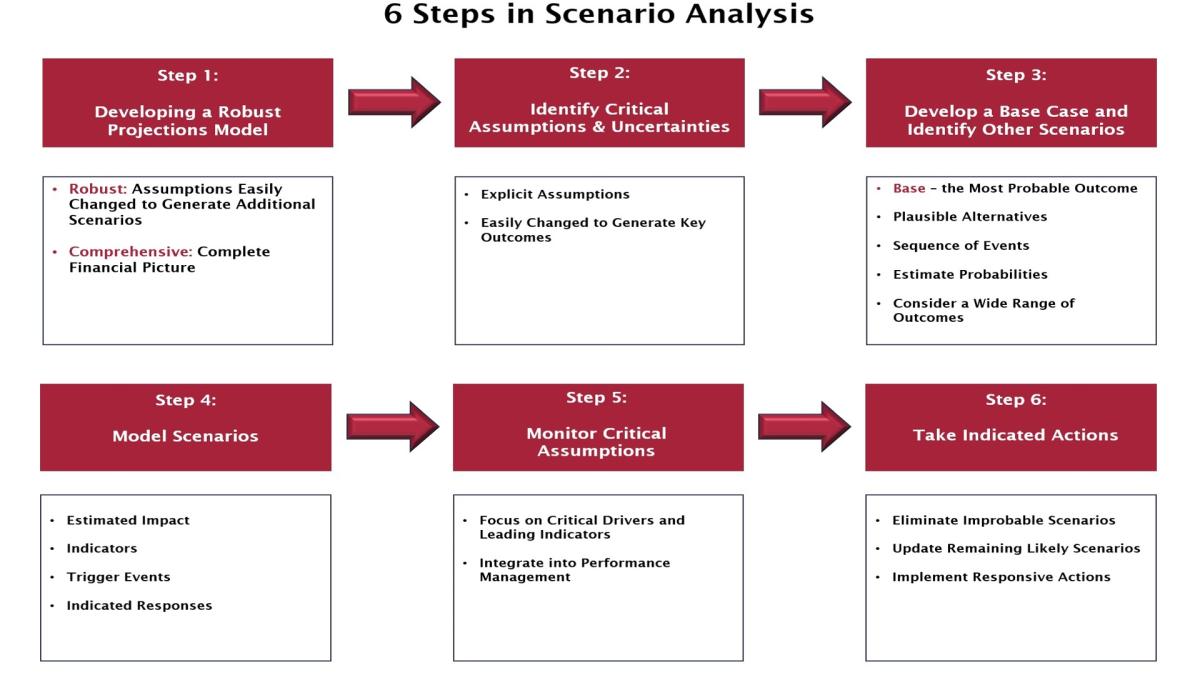
Введение
Управление сценарными моделями в Demand Planning отличается от традиционного MLOps (Machine Learning Operations) для предиктивных моделей. Если предиктивные модели, как правило, стремятся к максимальной точности прогноза, то сценарные модели фокусируются на консистентности логики, аудируемости допущений и воспроизводимости результатов при вариации входных параметров.
Неконтролируемое изменение версий модели, входных данных или, что наиболее критично, бизнес-допущений (Scenario Assumptions) приводит к "аналитическому хаосу" — невозможности сравнить результаты разных сценариев или обосновать принятые решения перед регуляторами или высшим руководством.
Эта глава заложит основу для создания прочной архитектуры поддержки сценарных моделей, где принципы Data Governance и Model Governance объединены в единую систему контроля.
Теоретические основы и терминология
Для эффективного управления эксплуатацией сценарных моделей необходимо четко определить ключевые концепции:
1. Трехкомпонентный артефакт сценария
Сценарий в контексте Demand Planning — это не просто набор выходных данных. Это комплексный артефакт, состоящий из трех неотделимых компонентов, каждый из которых требует управления версиями:
| Компонент | Описание | Необходимость версионирования |
|---|---|---|
| M (Model Logic) | Исполняемый код модели, алгоритмы оптимизации, имитационные модули. | Обеспечивает, что логика расчетов не изменилась. |
| D (Input Data) | Исходные данные (исторические продажи, маркетинговые бюджеты, мастер-данные), на основе которых строится сценарий. | Обеспечивает, что сценарий стартует с точного среза данных. |
| A (Assumptions/Metadata) | Бизнес-допущения, пользовательские корректировки, параметры what-if (например, "рост цены на 10%", "потеря ключевого поставщика"). | Ключевой элемент аудита: объясняет, почему сценарий дал именно такой результат. |
Воспроизводимость (Reproducibility) достигается только тогда, когда зафиксирована связка (M_v1, D_v1, A_v1) -> R_v1 (Result).
2. Governance сценарных моделей
Model Governance в данном контексте — это набор правил, процессов и организационных структур, обеспечивающих надежность, прозрачность и соответствие моделей корпоративным стандартам на протяжении всего их жизненного цикла.
Ключевые аспекты Governance:
- Контроль качества (QA): Верификация математической корректности модели и ее валидация (соответствие бизнес-логике).
- Управление рисками: Оценка влияния ошибок модели на бизнес-решения (например, риск перепроизводства или дефицита).
- Аудируемость (Auditability): Способность восстановить, кто, когда и почему использовал или изменил модель, данные или допущения, приведшие к конкретному плановому решению.
3. Отличие версионирования сценарных моделей от традиционного MLOps
В классическом MLOps акцент делается на версионировании тренированных весов модели (например, файле .pkl или .h5). В сценарном планировании, основанном часто на оптимизационных или имитационных алгоритмах, версионированию подлежит прежде всего исполняемая бизнес-логика (скрипты, решатели, библиотеки), а также набор параметров A, которые могут быть изменены конечным пользователем.
Методологии и подходы
Для успешной эксплуатации сценарных моделей необходимо адаптировать принципы DataOps и DevOps, создавая специализированный конвейер ScenarioOps.
1. Принцип непрерывной интеграции для моделей (CI/CD for Models)
Непрерывная интеграция и доставка (CI/CD) должны применяться не только к инфраструктуре, но и к самой логике планирования.
- Разработка и тестирование логики: Изменение бизнес-правил или алгоритмов (M) происходит в изолированных ветках Git. Автоматические тесты проверяют корректность расчетов на эталонных наборах данных.
- Реестр моделей: Успешно протестированная логика регистрируется в Реестре моделей (Model Registry) и получает семантическую версию (например, v1.2.0).
- Автоматизированное развертывание: Развертывание новой версии модели в тестовую, а затем в продуктивную среду происходит автоматически, минимизируя ручные ошибки.
2. Управление версиями данных (Data Version Control, DVC)
Поскольку сценарные модели критически зависят от исходных данных (D), необходимо внедрить системы версионирования данных.
- Хеш-контроль: Каждому срезу данных, используемому для запуска сценария, присваивается уникальный хеш-идентификатор. Это гарантирует, что даже если данные в источнике (например, Data Lake) изменятся, мы всегда сможем точно указать, на каком срезе был основан план.
- Иммутабельность: Срезы данных, используемые для официальных сценариев, должны быть иммутабельными (неизменяемыми) и храниться в специальном архиве данных (Data Archive).
3. Управление метаданными сценариев (Metadata Management)
Самый важный аспект в Demand Planning — фиксация бизнес-допущений (A).
Методология Scenario Tagging:
Каждый запуск сценарной модели должен сопровождаться обязательным набором метаданных:
- Идентификатор Модели (M_ID): Ссылка на версию логики в Реестре.
- Идентификатор Данных (D_Hash): Ссылка на хеш исходных данных.
- Цель Сценария: (Например: "Прогноз на H2 при сохранении текущих цен").
- Ключевые Допущения (A): Список всех параметров what-if и ручных корректировок.
- Владелец и Дата Запуска: Информация для аудита.
Этот набор метаданных хранится в Репозитории Сценариев (Scenario Repository), который является центральным элементом Governance.
Архитектура и технологическая реализация
Эффективная архитектура эксплуатации сценарных моделей требует интеграции нескольких специализированных компонентов, выходящих за рамки стандартного хранилища данных.
1. Архитектурная схема (Layered Scenario Platform)
| Уровень | Компоненты и задачи | Примеры технологий |
|---|---|---|
| I. Источники Данных | Системы-источники (ERP, CRM), Data Lake. | SAP, Oracle, MinIO, Apache HDFS/S3-совместимые хранилища. |
| II. Хранение Данных и Версионирование | Мастер-данные, агрегированные срезы, DVC-система. | PostgreSQL/Greenplum (для D), DVC, Delta Lake (версионируемое хранилище). |
| III. Сценарный Движок (Modeling Engine) | Исполняемая среда для логики M: решатели, симуляторы. | Python/R среды, Optimization Solvers (Gurobi, OR-Tools), промышленные платформы. |
| IV. Реестр и Управление | Model Registry (хранит M), Scenario Repository (хранит связку M+D+A), Artifact Tracking. | MLflow, Neptune.ai, кастомные решения на базе GitLFS. |
| V. Пользовательский Интерфейс | Фронтенд для ввода допущений (A), запуска, сравнения и визуализации сценариев. | BI-инструменты (Tableau, Power BI, Qlik), кастомные веб-приложения, Loginom (российский аналог). |
2. Реестр моделей (Model Registry)
Реестр моделей — это централизованное место для хранения и управления жизненным циклом логики планирования (M).
Ключевые функции:
- Статусы версий: Модели должны иметь четкие статусы: Development, Staging, Production, Archived. Только версии со статусом Production могут использоваться для официального корпоративного планирования.
- Привязка к коду: Каждая версия модели в реестре должна быть жестко привязана к конкретному коммиту в Git, обеспечивая прямую связь между исполняемой логикой и исходным кодом.
3. Технологии управления версиями (Open Source и Российские)
| Аспект | Open-Source Решения | Российские / Enterprise Решения |
|---|---|---|
| Версионирование Кода (M) | Git, GitLab, GitHub (стандарт индустрии). | Адаптированные системы контроля версий (например, на базе 1С для бизнес-логики). |
| Версионирование Данных (D) | DVC (Data Version Control), Git LFS, Delta Lake/Iceberg. | Yandex DataLens (частично), Платформы на базе Greenplum/PostgreSQL с функциями снимков (Snapshots). |
| Трекинг Артефактов (M+D+A) | MLflow Tracking, Kubeflow Metadata. | Loginom (ранее Deductor): мощный инструмент для конструирования моделей и управления сценариями. PolyAnalyst: для работы со сложными аналитическими workflow и их версионированием. |
Организационные и процессные аспекты
Технологии не работают без четко определенных ролей и процессов. Governance требует организационной структуры.
1. Роли и ответственности (RACI-матрица)
Четкое разделение ответственности критически важно для предотвращения "дикого" сценарирования.
| Роль | Ответственность за Governance |
|---|---|
| Владелец Модели (Model Owner) | Authority. Отвечает за математическую и алгоритмическую корректность (M), утверждает новые версии логики. Обычно Data Scientist/ML Engineer. |
| Сценарный Стьюард (Scenario Steward) | Consulted/Responsible. Отвечает за корректность бизнес-допущений (A) и утверждает запуск официальных сценариев. Обычно Старший Аналитик Demand Planning. |
| ИТ-Администратор | Informed/Responsible. Отвечает за эксплуатацию архитектуры (доступность D, развертывание M). |
| Руководитель Планирования | Authority. Утверждает перевод результатов сценария в официальный операционный план. |
2. Процесс управления изменениями (Change Management)
Любое изменение в триаде (M, D, A) должно проходить через управляемый процесс:
- Запрос на изменение (RFC): Аналитик или владелец бизнеса инициирует изменение (например, добавление нового фактора в модель M или изменение входного среза D).
- Песочница и Тестирование: Изменение реализуется в изолированной "песочнице" сценарного движка.
- Валидация бизнес-логики: Сценарный Стюард проверяет, что новая логика (M) или новые допущения (A) адекватно отражают реальность.
- Утверждение Governance Board: Комитет по управлению моделями (Model Governance Board) утверждает перевод новой версии (M_v_new) в Production.
- Документация и Аудит: Все изменения логики и допущений документируются в Репозитории Сценариев, включая подписи утверждающих лиц.
Практические примеры и кейсы
1. Кейс: Управление "Scenario Sprawl" через Реестр Сценариев
В крупной розничной компании, использующей десятки тысяч SKU, аналитики еженедельно создавали сотни неформализованных what-if сценариев ("S01_Вася", "S02_Петя_V_final_final"). Это привело к невозможности сравнения и принятия решений.
Решение: Внедрение централизованного Репозитория Сценариев (на базе доработанного Loginom или MLflow).
-
Стандартизация именования: Введена обязательная схема именования:
[Дата]_V[Версия Модели]_[Набор Данных]_Цель. - Инкапсуляция допущений: Вместо того чтобы позволять пользователям менять исходный код, все what-if параметры (A) были вынесены в отдельный конфигурационный файл, который автоматически версионируется вместе с запуском сценария.
- Результат: Сокращение числа рабочих сценариев на 40%, повышение доверия к результатам, так как каждый план теперь можно было "разобрать" до исходного кода, данных и допущений.
2. Применение российских платформ
Российские платформы бизнес-анализа часто обладают встроенными механизмами для управления аналитическими конвейерами, которые могут служить основой для ScenarioOps:
- Loginom (ранее Deductor): Позволяет создавать сложные визуальные схемы обработки данных и моделирования. Каждая схема может быть версионирована. Важно, что система позволяет управлять "данными эксперимента" — то есть фиксировать входные срезы и параметры сценариев.
- PolyAnalyst: Используется для управления сложными аналитическими проектами. Его возможности по трекингу шагов обработки и фиксации состояния рабочего процесса позволяют эффективно реализовать управление версиями M и A.
Технические детали реализации
1. Схемы версионирования моделей (M)
Для версионирования исполняемой логики (M) рекомендуется использовать Semantic Versioning (СемаВер): Major.Minor.Patch.
- MAJOR (X.0.0): Изменения, нарушающие совместимость или кардинально меняющие методологию (например, переход от линейной регрессии к байесовской симуляции). Требует переобучения и полной валидации.
- MINOR (1.X.0): Добавление новой функциональности или фактора (например, включение в модель данных о погоде). Сохраняет совместимость основной логики.
- PATCH (1.0.X): Исправление ошибок, оптимизация производительности, не влияющие на математический результат.
2. Версионирование параметров сценария (A)
Параметры (A) должны храниться в формате, который легко читается человеком и парсится машиной (JSON, YAML).
- Пример структуры метаданных A (YAML):
scenario_id: SCENARIO-20240915-001
model_version: v3.1.2 # Связь с Model Registry
data_hash: 8f9a2b5e... # Связь с DVC
business_assumptions:
  promotion_campaign: TRUE
  price_change_strategy:
    item_id_123: +0.05
    item_id_456: -0.02
  supply_risk:
    supplier_A_disruption_probability: 0.3
author: Ivanov_P
status: Final_Proposal
Этот YAML-файл, содержащий все допущения, сам по себе является ключевым артефактом и должен быть зафиксирован в Git или Scenario Repository.
3. Интеграция с GitOps/DataOps
Идеальная эксплуатационная среда использует подход DataOps для автоматизации:
- При фиксации новой версии логики (M) в Git, триггер запускает CI-конвейер.
- CI-конвейер тестирует M, присваивает ей версию и публикует в Model Registry.
- При запуске сценария через UI, система автоматически фиксирует текущий D (срез данных) и A (параметры), формируя конечный артефакт, который хранится в Scenario Repository вместе с хешем результата.
Риски, ограничения и типовые ошибки
1. Риск «Сценарного хаоса» (Scenario Sprawl)
Описание: Неконтролируемое создание множества почти идентичных, но не сопоставимых сценариев. Это приводит к размыванию ответственности и затруднению принятия решений. Решение: Жесткая политика архивирования. Сценарии, не получившие статуса "Официальный план" или "Архивный эталон", удаляются через 30 дней.
2. Риск концептуального дрейфа (Concept Drift)
Хотя это чаще проблема предиктивных моделей, она актуальна и для сценарного планирования. Если бизнес-процессы или рыночные механизмы фундаментально меняются (например, появление нового канала продаж), старая логика модели (M) может давать ошибочные результаты, даже если ее версия зафиксирована. Решение: Регулярная (например, ежеквартальная) валидация модели на предмет актуальности ее бизнес-логики Сценарным Стюардом.
3. Ошибка ручного ввода допущений (A)
Если пользователи могут вводить допущения A напрямую в UI без логической валидации, это может привести к абсурдным результатам (например, повышение цены на 500%). Решение: Внедрение системы параметрической валидации (Parameter Validation). Установка четких бизнес-границ для всех what-if переменных.
Перспективы развития направления
Сфера эксплуатации сценарных моделей будет развиваться в сторону еще большей автоматизации и интеграции с ИИ.
- AIOps для Сценариев: Использование ИИ для автоматического мониторинга работоспособности сценариев. Система будет автоматически сравнивать результаты утвержденного плана с фактическими показателями и сигнализировать не только об отклонении, но и о том, какой компонент (M, D, или A) мог стать причиной ошибки.
- Генеративный AI в планировании: Использование генеративных моделей для автоматического создания реалистичных, но экстремальных what-if допущений (A), которые человек может упустить. Система предлагает аналитику "стресс-тесты", обеспечивая более полное покрытие рисков.
- Единый Enterprise Planning Ledger: Создание единого, нестираемого журнала (подобие блокчейна или append-only лога) всех официальных сценариев и принятых на их основе решений, обеспечивающего максимальную аудируемость для регуляторов и акционеров.
Заключение
Эксплуатация и поддержка сценарных моделей — это не техническая, а управленческая задача. Внедрение строгих политик Governance и систем управления версиями (M, D, A) является обязательным условием для перевода what-if анализа из инструмента разового эксперимента в фундамент корпоративного принятия решений. Успех в Demand Planning в эпоху нестабильности зависит от способности организации быстро, надежно и, главное, аудируемо сравнивать и развертывать различные будущие сценарии.
Вопрос–Ответ (FAQ)
1. Чем управление версиями сценарных моделей отличается от обычного MLOps?
Ответ: Классический MLOps фокусируется на версионировании тренированных артефактов (например, весов нейронной сети) и их метрик. В сценарном планировании часто используются оптимизационные или имитационные модели, где важнее версионировать исполняемую бизнес-логику (M) и, критически, бизнес-допущения (A), введенные пользователем. Необходимо фиксировать связку (M, D, A) для обеспечения полной воспроизводимости результата, а не только сам тренированный файл.
2. Что такое "Scenario Sprawl" и как с ним бороться?
Ответ: Scenario Sprawl — это неконтролируемое накопление большого количества неформализованных, частично дублирующихся и неаудируемых сценариев, что затрудняет принятие решений и сравнение результатов. Бороться с ним нужно внедрением централизованного Репозитория Сценариев, который стандартизирует метаданные (A), требует обязательного статуса для каждого сценария ("Черновик", "Кандидат", "Официальный") и использует политики автоматической очистки или архивирования "диких" сценариев.
3. Какую роль играет DVC (Data Version Control) в Demand Planning?
Ответ: DVC критически важен, так как результаты сценарного планирования зависят от среза входных данных (D). DVC позволяет присвоить уникальный хеш-идентификатор точному набору данных, использованному для запуска сценария. Это гарантирует, что если в будущем нам потребуется проверить, почему был принят план, мы сможем восстановить не только логику (M) и допущения (A), но и точный входной набор данных (D), даже если исходный Data Lake был обновлен.
4. Должны ли бизнес-аналитики иметь возможность менять логику модели (M) напрямую?
Ответ: Категорически нет. В рамках Governance бизнес-аналитики должны иметь возможность изменять только параметры сценария (A) через стандартизированный пользовательский интерфейс. Изменение логики (M) — это прерогатива Владельца Модели (Data Scientist/IT) и должно проходить через строгий процесс CI/CD, тестирование и утверждение в Model Registry, чтобы избежать внесения неконтролируемых ошибок.
5. Что такое Сценарный Стюард (Scenario Steward) и почему эта роль важна?
Ответ: Сценарный Стюард — это ключевая роль в Model Governance, отвечающая за бизнес-валидацию и корректность допущений (A). В то время как Владелец Модели отвечает за математику, Стюард отвечает за реалистичность what-if параметров. Он утверждает, что сценарий "рост цены на 15% и падение спроса на 5%" имеет бизнес-смысл, и именно он санкционирует перевод результатов сценария в "Официальный план".
6. Как российские платформы, например Loginom, могут помочь в управлении версиями сценариев?
Ответ: Российские платформы, такие как Loginom или PolyAnalyst, изначально разрабатывались для управления сложными аналитическими workflow. Они позволяют версионировать не только код, но и состояние всего конвейера обработки данных и моделирования. Это позволяет зафиксировать "эксперимент" целиком, включая все входные параметры и промежуточные шаги, что является мощной основой для создания Репозитория Сценариев.
7. Какое минимальное требование к метаданным должно быть для каждого официального сценария?
Ответ: Минимальное требование — фиксация триады версий (M, D, A). То есть, необходимо зафиксировать: 1) ID версии исполняемой логики (M_vX), 2) Хеш-идентификатор входного набора данных (D_Hash), 3) Полный список ключевых бизнес-допущений, введенных пользователем (A), и 4) Статус и Владелец сценария для аудита. Без этих четырех элементов сценарий считается невоспроизводимым и не должен использоваться для официального планирования.


