

Тестирование данных в CI/CD: наборы тестов, критерии приемки, автоматизация
Краткое введение
Эта глава посвящена ключевой роли тестирования данных в рамках CI/CD для ML и MLOps. В современных системах принятия решений качество входных данных определяет качество моделей, риски бизнес-решений и репутационные последствия компании. Правильная автоматизация тестирования данных позволяет выявлять проблемы на ранних этапах разработки, снижает риск деструктивного влияния изменений на продукты и сервисы, обеспечивает воспроизводимость экспериментов и прозрачность инженерных решений. В контексте данной дисциплины особое внимание уделяется тем notion, как наборы тестов, критерии приемки, автоматизация и их тесной связке с архитектурой данных и процессами DevOps/ML Ops.
Введение
Тестирование данных в цепочке CI/CD выходит за рамки классических unit-тестов кериального кода. Здесь тесты применяются к данным и метаданным: от проверки форматов, схем и уникальности ключей до динамического мониторинга распределений и устойчивости к дрейфу. Основная идея - заранее зафиксировать ожидания относительно состояния данных и встроить проверки в конвейеры доставки изменений: от источников сырья до хранения признаков и моделей.
Ключевые концепции:
- данные как первый класс в процессе разработки: данные тестируются так же тщательно, как и код;
- контракты данных (data contracts): соглашения между источниками, пайплайнами и потребителями;
- наблюдаемость данных и автоматизация контролей как часть продукта (data quality as a service);
- управляемый риск и регуляторные требования через повторяемые и документируемые тесты.
Ниже представлены теоретические основы и практические подходы, которые позволяют реализовать надёжную, масштабируемую и управляемую систему тестирования данных в CI/CD.
Теоретические основы и терминология
- Data Quality (DT): совокупность характеристик данных, определяющих их пригодность к последующим процессам (преобразование, обучение моделей, принятие решений).
- Data Contract (контракт данных): формализованное соглашение между поставщиком данных и пользователем, описывающее структуру, допустимые значения, частоту обновления и качество данных.
- Data Validation (валидация данных): процесс проверки соответствия данных заданным ожиданиям (форматы, диапазоны значений, уникальные ключи, отсутствующие значения и т. п.).
- Data Drift (дрейф данных): изменение распределения данных во времени, что может ухудшать качество моделей.
- Schema Drift (дрейф схемы): изменение структуры данных, например новые поля, изменённые типы данных.
- Test Sets (наборы тестов): предварительно сформированные наборы тестовых случаев и критериев приемки, которые используются повторно в CI/CD.
- Acceptance Criteria (критерии приемки): пороговые значения или условия, которые должны быть выполнены для подтверждения готовности изменений к продвижению в продакшн.
- Data Observability (наблюдаемость данных): сбор, агрегация и анализ метрик качества данных и их тенденций во времени.
- Test Orchestration (оркестрация тестов): координация выполнения тестов внутри пайплайна, с учётом зависимости между источниками данных, признаками и целями.
- Synthetic Data (синтетические данные): данные, созданные искусственно для тестирования, обеспечения приватности и воспроизводимости.
Термины можно рассматривать как контракт между инженерами по данным, инженерами ML и бизнес-заказчиками. В CI/CD это означает, что тесты данных должны быть описаны и версионированы аналогично коду, храниться в системах контроля версий и автоматически запускаться на каждом PR или коммите.
Методологии и подходы
- Контракты данных как основа тестирования:
- формальные спецификации схемы (имена полей, типы, допустимые диапазоны);
- требования к полноте, уникальности и валидности значений;
- сроки обновления и частота инкрементальных изменений.
- Тестирование на разных уровнях:
- unit-тесты для конкретных шагов пайплайна (например, функции нормализации значений);
- интеграционные тесты на данные между источниками и хранилищами;
- end-to-end тесты для реальных бизнес-кейсов (например, обновление набора признаков и их влияние на скоринг).
- Наборы тестов (наборы тестов, критерии приемки, автоматизация):
- модульные проверки данных (форматы, валидность);
- проверки целостности (первичные ключи, внешние ключи);
- статистические тесты на дрейф распределений (KS-тест, PSI);
- тесты согласованности признаков и целевых переменных;
- регрессионные тесты, чтобы новые изменения не ломали существующие поведении пайплайна.
- Стратегии отбора тестов:
- тестирование критически важных датасетов (пратические бизнес-ключи, резервы риска);
- приоритизация тестов по вероятности возникновения дефектов и влиянию на модель;
- мониторинг и адаптация тестов по мере возникновения новых источников данных.
- Интеграция с практиками MLOps:
- версия данных и контрактов;
- автоматическое создание тест-кейсов на основе изменений в датасете;
- связь тестов с экспериментами и моделями (traceability).
Важно помнить: наборы тестов должны быть эволюционны и управляемы. Изменения в источниках данных должны автоматически приводить к обновлению тестовых кейсов через процессы управления данными и контракты.
Архитектура и технологическая реализация
Архитектурная visão
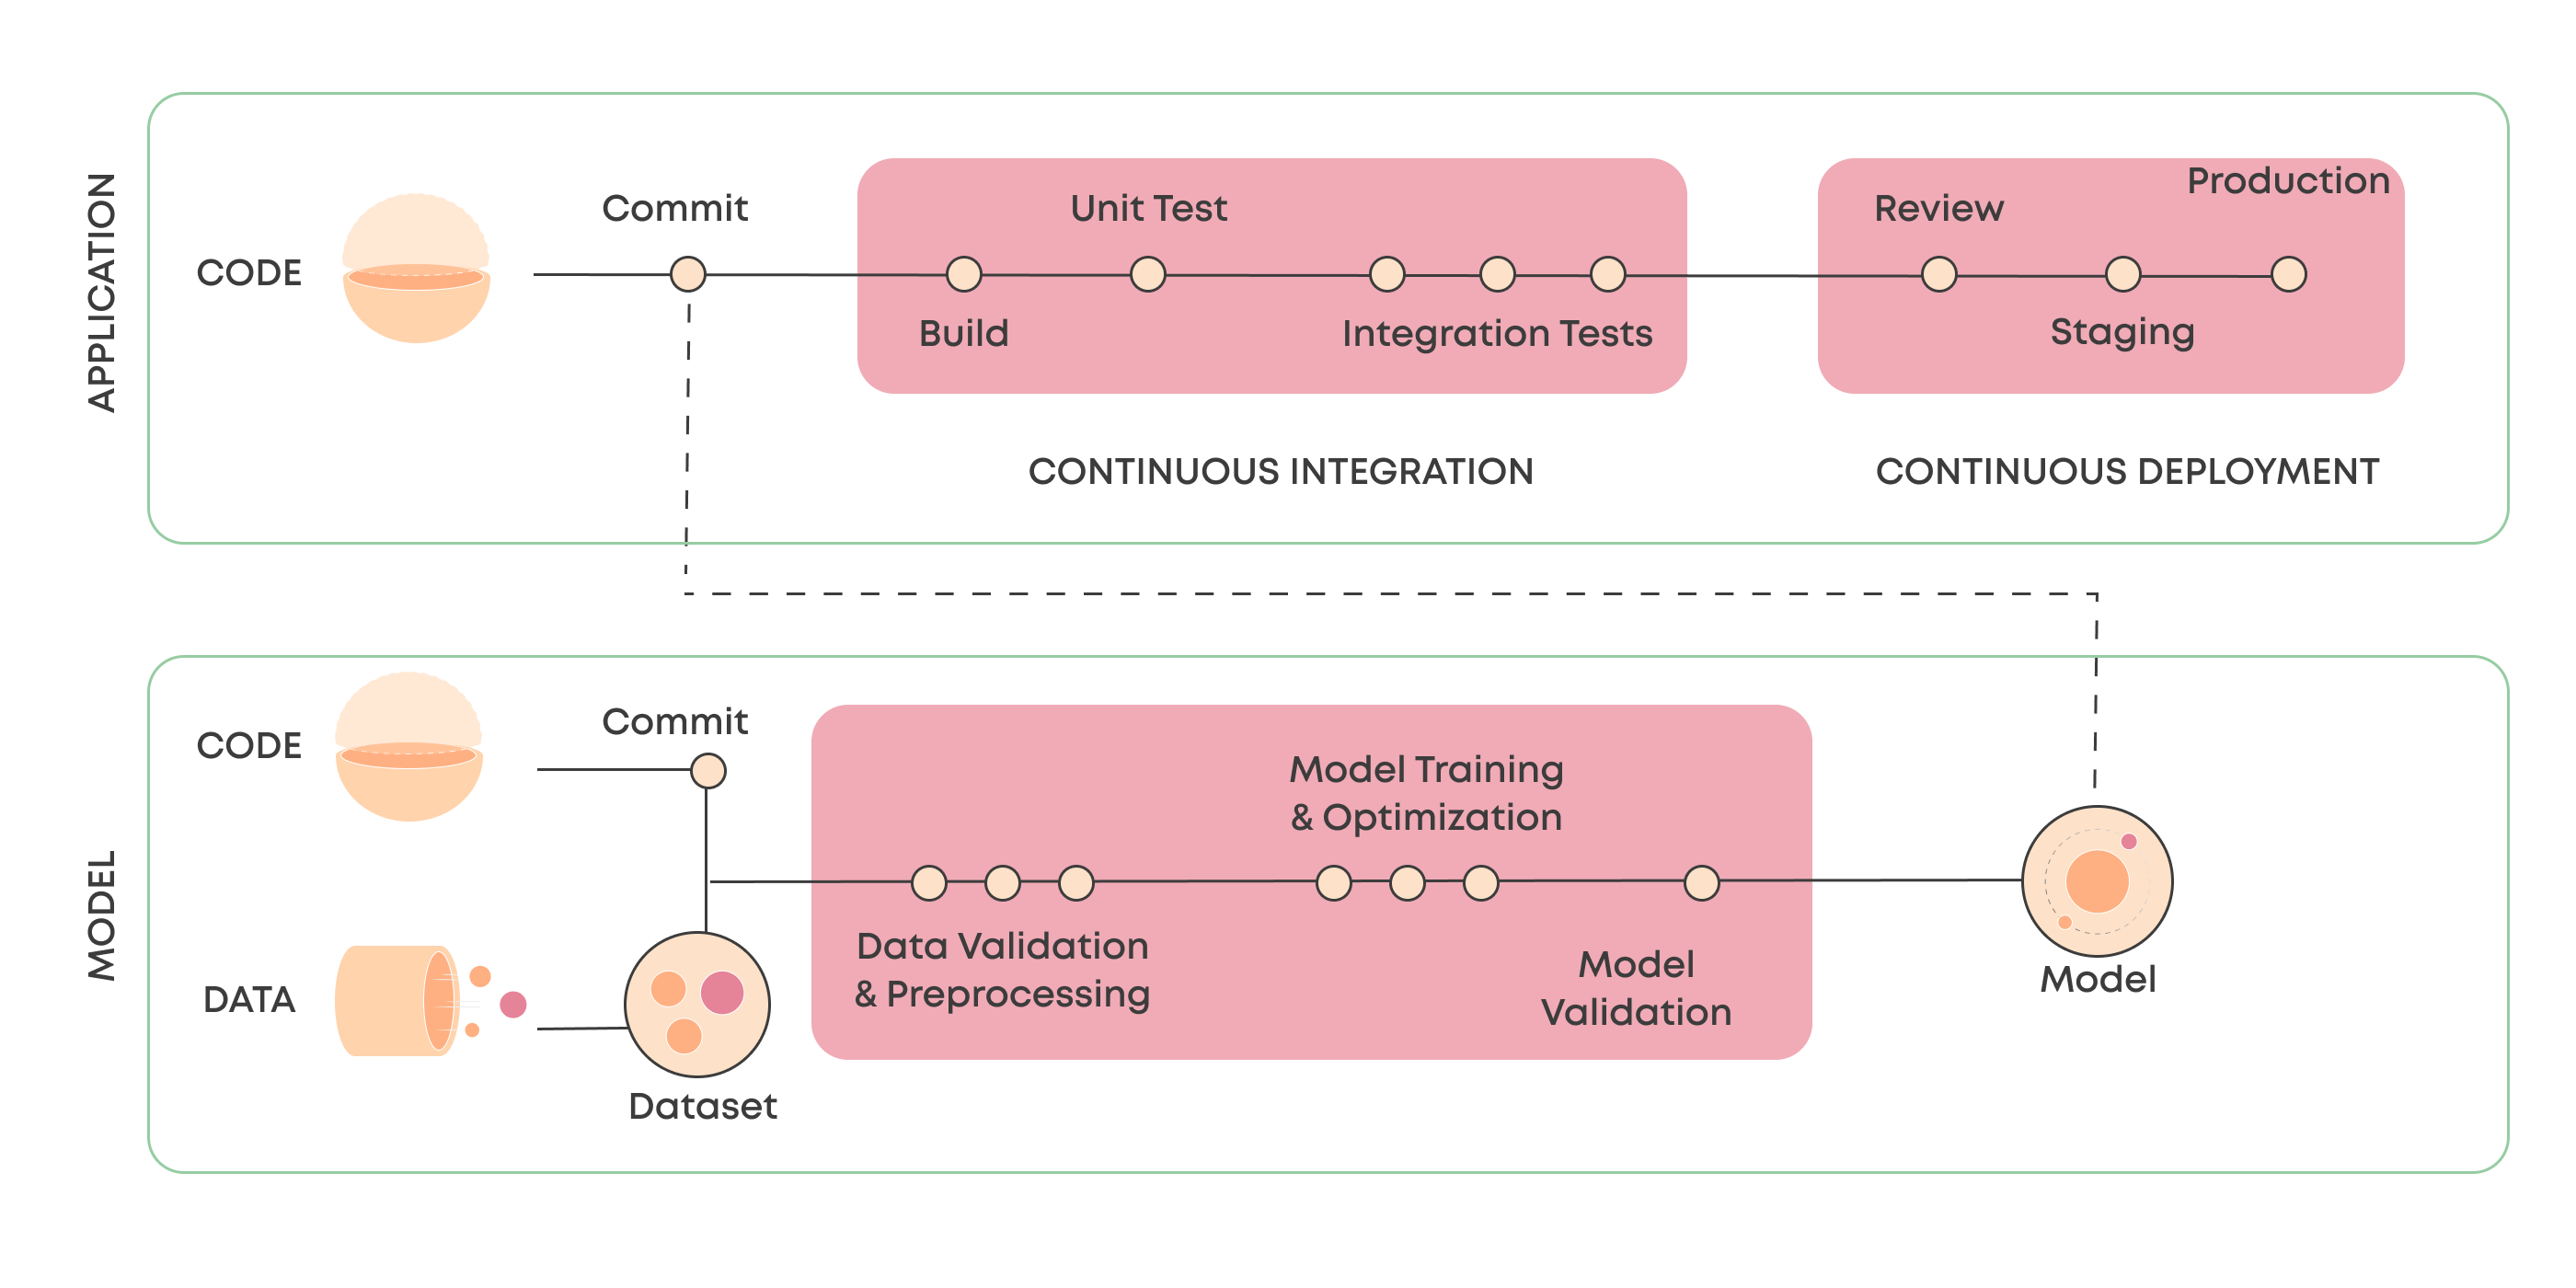
Источник данных/ETL -> Data Ingestion & Cleaning -> Data Validation Service -> Feature Store / Raw Data Lake -> ML Model Training & Scoring -> Monitoring & Observability
- **Data Ingestion & Cleaning**: кадры, которые загружают данные из источников, выполняют базовые проверки на качество и очищают данные до стадии валидации.
- **Data Validation Service**: микросервис или компонент конвейера, который запускает тесты данных, сравнивает результаты с контрактами и публикует отчёты.
- **Feature Store / Raw Data Lake**: хранилища, где данные и признаки проходят хранение и доступ для обучения и предиктов.
- **ML Model Training & Scoring**: этап обучения и себестоимость предсказаний, где тесты данных влияют на качество обучаемых моделей.
- **Monitoring & Observability**: слежение за дрейфами, задержками в интервалах обновления и качеством тестов.
Инструменты и стеки
- Open-source решения:
- Great Expectations: фреймворк для валидации данных и построения контрактов. Поддерживает генерацию схем, адаптивные тесты, интеграцию с пайплайнами.
- Deequ (Apache Spark/Scala): библиотека для дефинирования и выполнения тестов качества данных, особенно полезна в больших датасетах и Spark-пайплайнах.
- dbt (data build tool): тесты на SQL-выражениях как часть конвейера обработки данных; эффективен для Data Warehouse/Datamart сред.
- Dagster / Apache Airflow: оркестрация тестов и пайплайнов, управление зависимостями и выводами тестов.
- Great Expectations + Dagster/Airflow: комбинируются для тестирования в контексте пайплайна.
- Облачные и коммерческие решения:
- Яндекс DataSphere (российское решение): поддерживает данные, пайплайны и тестирование данных в рамках ML-процессов.
- Яндекс.Облако и инструменты мониторинга качества данных на платформах облачных сервисов.
- Сбер МЛ-операции/платформа (платформа Сбер): ориентирована на производство, тестирование данных, мониторинг и управление контрактами.
- Архитектурные паттерны:
- Data Contract Registry: централизованное хранилище контрактов и их версий.
- Data Validation Microservice: выделенный сервис, который принимает данные, выполняет тесты и публикует результаты.
- Observability & Telemetry: сбор метрик по качеству данных, времени выполнения тестов и частоте событий.
Пример реализации тестов данных
- Пример 1: Great Expectations (Python)
- Определение expectation suite для таблицы transactions.
- Валидация на этапе загрузки данных в ingestion layer.
from great_expectations.data_context import DataContext
ctx = DataContext()
suite = ctx.create_expectation_suite(
expectation_suite_name="transactions_table_suite"
)
Пример набора тестов
suite.add_expectation(
expectation_type="expect_table_row_count_to_be_between",
kwargs={"min_value": 1000, "max_value": 1000000}
)
suite.add_expectation(
expectation_type="expect_column_values_to_not_be_null",
kwargs={"column": "transaction_id"}
)
suite.add_expectation(
expectation_type="expect_column_values_to_be_in_type_list",
kwargs={"column": "amount", "types": ["DOUBLE", "FLOAT", "INT"]},
)
ctx.save_expectation_suite(suite)
- Пример 2: Deequ (Scala/Java) - базовые проверки на DataFrame
import com.amazonaws.deequ.VerificationResult
import com.amazonaws.deequ.VerificationSuite
import com.amazonaws.deequ.checks.Check
val df = spark.read.format("parquet").load("s3://data/transactions/part-00001.parquet")
val result: VerificationResult = VerificationSuite() .onData(df) .addCheck( Check(Check.Level.Error, "Basic data quality checks") .isComplete("transactionid") .hasSize( > 1000) .isUnique("transaction_id") .isNonNegative("amount") ) .run()
assert(result.status == CheckStatus.Success)
- Пример 3: DBT тесты (SQL-тесты)
-- tests/transactions_not_null.sql SELECT COUNT(*) FROM {{ ref('transactions') }} WHERE transaction_id IS NULL; - Пример 4: GitHub Actions для CI/CD тестирования данных
name: Data Tests
on: pull_request: push: branches:
- main
jobs: data-tests: runs-on: ubuntu-latest steps:
- name: Checkout uses: actions/checkout@v3
- name: Setup Python uses: actions/setup-python@v5 with: python-version: '3.11'
- name: Install dependencies run: | python -m pip install --upgrade pip pip install great_expectations[snowflake] numpy pandas
- name: Run data tests run: | python run_tests.py
- Пример 5: Архитектурная интеграция
- Контракты данных хранятся в контрактном реестре (например, в виде YAML/JSON-файлов с версиями).
- Пайплайн валидирует данные по контрактам и публикует результаты в мониторинг.
Организационные и процессные аспекты
- Роли и ответственность:
- Data Engineer: обеспечение источников данных, корректность и доступность данных, создание контрактов.
- Data Quality Engineer: проектирование тестов, управление контрактами, мониторинг качества.
- ML Engineer: использование качества данных в обучении и оценке моделей, реагирование на дрейф.
- IT/DevOps: интеграция тестирования данных в CI/CD, обеспечение среды выполнения тестов и безопасности.
- Data Owner / бизнес-аналитик: формулирование требований к качеству данных и критериев приемки.
- Управление контракта и версий:
- контрактные версии должны привязываться к версиям пайплайнов и датасетов.
- изменения в контракте должны приводить к обновлению тестов и регрессии по новому контракту.
- Управление данными и приватностью:
- синтетические данные и обезличивание для тестирования в средах разработки.
- соблюдение регуляторных требований и политик доступа к данным.
- Процессы выпуска и регрессии:
- любые изменения источников данных или форматов должны запускать тестовую палитру и требовать прохождения тестов.
- тесты должны быть детализированы и воспроизводимы, с хранением артефактов в системе артефактов.
- Спецификации данных и качество как часть продукта:
- данные - это часть продукта; качество данных должно соблюдаться так же, как качество кода.
- сервисы тестирования данных должны предоставлять отчетность и видимость для бизнес-заказчика.
Практические примеры и кейсы (open-source и российские решения)
- Open-source кейсы:
- Кейсы с использованием Great Expectations в слиянии изначальной обработки данных, где контракты описываются в YAML и прямо внедряются в пайплайны Dagster/Airflow.
- Пример внедрения тестов дрейфа и проверки качества в Spark-пайплайне через Deequ.
- Интеграции DBT тестов в единый пайплайн для проверки моделей и выходных данных в дата-дашбордах.
- Российские решения и примеры внедрения:
- Яндекс DataSphere и экосистема Яндекс.Облако позволяют включать тестирование данных в CICD-процессы ML-проектов, управлять контрактами и обеспечивать observability данных внутри облака.
- Практики внедрения data contracts и тестирования в рамках российских проектов на основе DAG-архитекторοв и локальной инфраструктуры (Kubernetes) с интеграцией мониторинга метрик качества.
- Региональные кейсы по использованию решений для обеспечения прозрачности тестов и контроля версий контрактов в больших дата-хаках и финтех-проектах.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Алгоритмы тестирования качества:
- Статистические тесты на дрейф: KS-тест, PSI, Wasserstein distance для распределения признаков и целевой переменной.
- Проверки на согласованность: сравнение сумм и средних по версиям датасетов.
- Проверки схемы: валидация типов, названий столбцов, обязательных полей, отсутствия неожиданных значений.
- Архитектурные схемы:
- Контрактный реестр и тестовый сервис: контракты описываются, версии привязываются к пайплайну; сервис выполняет тесты и публикует отчеты.
- Observability pipeline: сбор метрик по качеству данных, частоте дрейфа, временем выполнения тестов, задержками в обновлениях и регрессиями.
- Протоколы интеграции:
- REST/gRPC интерфейсы между Data Validation Service и пайплайном.
- Интеграции с GitOps: изменение контракта вызывает автоматический пересмотр тестов и обновление артефактной среды.
- Инструменты и окружение:
- Виртуальные окружения и контейнеризация (Docker/Kubernetes) для выполнения тестов в изолированной среде.
- Метрики качества данных: набор индикаторов (количество null-значений, пропусков, уникальные ключи, дубликаты).
- Метрики дрейфа: изменение распределения признаков по времени, с пороговой реакцией на дрейф.
- Пример реализации CI/CD для тестирования данных:
name: Data Validation & Model Training
on: push: branches: [ main ] pull_request:
jobs: validate-data: runs-on: ubuntu-latest steps:
- name: Checkout uses: actions/checkout@v3
- name: Setup Python uses: actions/setup-python@v5 with: python-version: '3.11'
- name: Install dependencies run: | python -m pip install great_expectations pip install pydantic numpy pandas
- name: Run data validation run: | python tests/run_data_validation.py
- name: Publish results if: always() run: | python -m pip install junit-xml python tests/generate_report.py
- Примеры контрактов данных в формате YAML:
contract: dataset: "transactions" version: "v1.3.0" schema: - name: transaction_id type: string required: true
- name: amount type: float required: true min: 0.0
- name: currency type: string required: true allowed_values: ["USD", "EUR", "RUB"] quality: not_null_checks:
- transaction_id
- amount unique_keys:
- transaction_id
- Пример диаграммы архитектуры в текстовом виде:
[Источник данных] -> [ETL/Ingestion] -> [Data Validation Service] -> [Feature Store] -> [Model Training] -> [Monitoring]
| ^ |
| --- |
               Контракты данных, тесты, отчеты, уведомления
Риски, ограничения и типовые ошибки
- Дрейф данных и контракты:
- Риск: отсутствие своевременного обновления контрактов при изменении источников.
- Применение: регламентировать процесс versioning контрактов, автоматическую генерацию тестов из контрактов.
- Флаки тесты:
- Риск: нерегулярно воспроизводимые тесты могут приводить к ложным отказам.
- Применение: стабильная среда тестирования, детальное логирование, репродуцируемые наборы данных.
- Неполнота тестового покрытия:
- Риск: пропуск критических сценариев, например, редких форматов или редких ошибок.
- Применение: использование синтетических данных, тестирование на разных объемах данных, регрессионные тесты по версиям датасетов.
- Шум в данных и приватность:
- Риск: тестовые данные могут содержать чувствительную информацию.
- Применение: синтетика, обобщение сведений, маскирование персональных данных.
- Интеграционные проблемы:
- Риск: несовместимость версий инструментов и обновлений платформ.
- Применение: контроль версий окружения, тестирование обновлений в staging, миграционные планы.
Перспективы развития направления
- Data contracts как единый механизм домовляэн, расширение их в область цифровой идентификации датасетов и их поведенческих контрактов.
- Наблюдаемость данных как сервис: расширение набора метрик и автоматическое предупреждение: дрейф, недостача признаков, проблемы источников.
- Управление качеством данных на уровне продакшн через метрики и автоматические регрессионные тесты, которые активируются вручную или по расписанию.
- Интеграция с облачными MLOps-платформами и локальными решениями, специализированными под отрасли (финансы, здравоохранение, телеком).
- Повышение уровня безопасности данных и приватности через управление синтетикой и контрактами, обеспечение комплаенса в тестах.
Заключение
Тестирование данных в CI/CD становится критически важной частью инженерной практики в ML и MLOps. Наборы тестов, критерии приемки и автоматизация тестирования данных образуют фундамент устойчивых, воспроизводимых и безопасных процессов. Внедрение контрактов данных, мощной наблюдаемости и интеграции тестирования в пайплайны - путь к снижению бизнес-рисков, ускорению выпуска и более качественным моделям. Реальные кейсы демонстрируют, что сочетание открытых инструментов (Great Expectations, Deequ, dbt, Dagster, Airflow) и российских решений (Яндекс DataSphere, облачные сервисы) позволяет создавать гибкие и надёжные решения в разных технологических стэках и бизнес-модельях.
Вопрос-Ответ (FAQ)
Что такое контракт данных и зачем он нужен в CI/CD ML-проектов?
Контракт данных - формализованное соглашение между источником данных и потребителем, описывающее схему, качество и правила обработки. Он служит дорожной картой для тестирования данных на каждом этапе пайплайна, обеспечивает воспроизводимость и упрощает аудит изменений.
Какие типы тестов данных наиболее полезны в ML-проектах?
Валидность форматов и схем, полнота и уникальность ключей, статистический дрейф распределений, тесты на корреляции между признаками и целевой переменной, регрессионные тесты для предиктивного пайплайна.
Какой подход к внедрению тестирования данных в CI/CD наиболее эффективен?
Начать с контрактов данных и базовых тестов на этапе Ingestion, затем расширять до интеграционных тестов на пайплайнах и, наконец, добавлять end-to-end тесты, связывающие данные, признаки и модели. Интегрировать тесты с выбором инструментов: Great Expectations/Deequ для валидации, DBT для тестирования SQL, Dagster/Airflow для оркестрации.
Какие метрики использовать для мониторинга качества данных?
Доля пропусков и нулевых значений, число дубликатов, соответствие схемы, доля корректных значений типов, показатели дрейфа (KS, PSI), время выполнения тестов и частота срабатываний ошибок.
Как избежать флаки-провалов тестов в CI?
Обеспечить детальные логи и трассировку, использовать репродуцируемые наборы данных (seeded датасеты, синтетика), разделить среду тестирования на staging и production-подборки, избегать зависимостей от внешних систем без контрактов.
Какие примеры инструментов можно использовать в российской инфраструктуре?
Яндекс DataSphere и сопутствующие сервисы в Яндекс.Облаке; использование локальных решений с Kubernetes и Open-source стеками (Dagster/Airflow, Great Expectations, DBT, Deequ) с локальными источниками данных и безопасной сетью.
Как связать тестирование данных с процессами ML-разработки?
Тестирование данных должно быть неотъемлемой частью цикла экспериментов: тесты валидности наборов признаков и данных позволяют быстро понять, почему модель ведет себя иначе на новых данных; контракты и тесты должны быть связаны с экспериментами и версиями датасетов и признаков.
Как внедрить данные контракты в существующую архитектуру?
Внедрить контрактный реестр и автоматическую генерацию тестов из контрактов; интегрировать Validation Service в пайплайны CI/CD; обеспечить версионирование контрактов и соответствие тестовых артефактов версиям датасетов.
Какие риски присутствуют при отсутствии тестирования данных в CI/CD?
Рост бизнес-рисков из-за дрейфа данных, деградация моделей, задержки в выявлении ошибок, сложности аудита и регуляторных требований, низкая воспроизводимость экспериментов.
Какие направления развития вы считаете ключевыми на ближайшие годы?
Расширение контрактной модели и автоматизация создания тестов по изменениям датасетов; углубленная observability данных; расширение поддержки данных в реальном времени; усиление интеграций с облачными и региональными платформами, в том числе российскими решениями, для обеспечения приватности и контроля доступа.
Если ваша компания планирует масштабировать проекты машинного обучения, ключевым фактором становится создание устойчивой ML-платформы с практиками MLOps и автоматизированными CI/CD-процессами.
Узнайте, как внедрить искусственный интеллект для бизнеса - от стратегии до внедрения: от оценки готовности компании и архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в ключевые бизнес-процессы.


