

Учебный курс Современная архитектура хранилища данных

- Объяснение современных архитектур данных
- Различные виды стека данных
- Эволюция стека данных: история о том, как мы обрабатываем постоянно растущие объемы данных
- Data Engineering: концепции, процессы и инструменты
- Проблемы современного стека данных
- Руководство для архитектора данных по современному стеку данных
- Введение в современный стек данных
- Прошлое, настоящее и будущее архитектуры данных
- Современный стек данных слишком сложен … и 70% лидеров и практиков в области данных с этим полностью согласны!
- Архитектура данных как основа бизнес-операций: концепции, паттерны и дорожная карта перехода к Lakehouse, Data Mesh и Data Fabric
- Интеграция данных: архитектура, конвейеры и современные технологические решения
- Хранение данных в эпоху петабайтных озёр: архитектуры, принципы и операционные практики DataOps, FinOps и мультиоблачной экосистемы
- HTAP: концепции, архитектуры и практика гибридной транзакционно-аналитической обработки
- Проектирование схем баз данных: принципы моделирования, производительности, целостности и управления миграциями
- Целостная архитектура развёртывания и эксплуатации аналитических хранилищ данных: моделирование, загрузка данных, запросы и мониторинг
Модуль 1 - Роль Аналитики и Инженера данных в организации
Познакомимся с предметом изучения, узнаем кто такой Data Engineer и что он делает, и как его еще называют. Главное, поймем, как он помогает бизнесу быть эффективней и зарабатывать деньги. Рассмотрим типовые архитектуры аналитических решений.
- Введение в инженерию данных
- Сложности в области инженерии данных
- Введение в паттерны проектирования в инженерии данных (DEDP)
- Введение в Data Engineering. ETL, схема «звезды» и Airflow
- Data Engineer и Data Scientist: какая вообще разница?
- Почему data scientist — это не data engineer?
- Data Analyst vs. Data Scientist - в чем различие?
- Мои первые три недели на должности менеджера инженерии данных
- Что такое DataOps?
- Эра DataOps
- Как пройти собеседование по проектированию систем в области инженерии данных
- Осваиваем дата-инжиниринг: 7 реальных проектов

Модуль 2 - Базы Данных и SQL
Рассмотрим пример решения для локальной аналитики. Познакомимся с базами данных и поймем их преимущество для работы с данными по сравнению с Excel/Google Sheets. Потренируемся на SQL, установим базу данных и загрузим в нее данные, потом будем использовать Excel/Google Sheets для визуализации данных.
Доступные решения для России:
- Greenplum - бесплатно, но если промышленная - нужна коммерческая поддержка, например Arenadata, учебный курс по GreenPlum
- Clickhouse (быстрая колоночная СУБД для витрин данных) - учебный курс по Clickhouse
- Postgres - бесплатно, но если промышленная инсталляция - нужна коммерческая поддержка, например Postgres Professional, учебный курс по PostgreSQL
- Greenplum с нуля: MPP аналитическая база данных
- Greenplum для Data Engineer
- Администрирование Greenplum
СУБД
- Эволюция архитектуры баз данных: интеграция Big Data, облачных технологий и ИИ
- Кому подойдет СУБД Greenplum? Чем Greenplum отличается от Clickhouse
- Сравнение 4 баз данных: Greenplum, Teradata, Presto и Clickhouse
- Обзор Open Source OLAP систем, работающих в режиме реального времени, 2025 год
- Сравнение аналитических in-memory баз данных
- VERTICA как развитая MPP СУБД
- Исследование всех СУБД можно скачать на https://russianbi.ru/
Хранилища для больших данных
- Хранилища данных. Обзор технологий и подходов к проектированию
- От реляционных БД до Data Lakehouse: краткая история развития систем управления данными
- Методология построения DWH
- Пошаговый план по внедрению DWH
- Учебный курс по DWH Basics / DWH Intermediate
- Эволюция архитектур данных: от DWH к Data Mesh
- Практическое руководство от экспертов: три роковые ошибки в архитектуре Data Lake, DWH и BI, которые ежедневно стоят вашим компаниям тысяч долларов
- Руководство по миграции крупного хранилища данных: от хаоса к управляемому процессу. Практический опыт и дорожная карта
- Миграция хранилища данных: от вынужденной меры до стратегического апгрейда вашего Data-стека
- DWH: почему бизнес боится данных и как мы можем решить эти страхи раз и навсегда
- Reladiff: «дифф» огромных таблиц внутри СУБД для инженеров данных и DevOps
- Опасные JOIN запросы которые незаметно замедляют вашу базу данных и как с этим бороться
- Picodata: перезагрузка in-memory баз данных для архитектуры будущего
- Как радикально ускорить базу данных: исчерпывающее руководство по партиционированию и шардированию от экспертов по производительности
- Оптимизация производительности баз данных: Стратегии масштабирования и репликации
Apache Doris
- Введение в Apache Doris: хранилище данных нового поколения
- Новая эра объединенного Лейкхауса: Кто будет править? Глубокое погружение в Apache Doris против ClickHouse
- Apache Doris с нуля: real-time аналитика и OLAP архитектура
- Apache Doris для Data Engineer
- Администрирование Apache Doris
Starrocks
- Учебный курс: StarRocks — полный практический гид по внедрению и эксплуатации
- Что лучше для бизнеса - Trino или StarRocks?
- StarRocks в Kubernetes: развертывание, масштабирование и автоматизация эксплуатации
- StarRocks как движок Open Data Lakehouse: архитектура, интеграция, best practices
- Построение AI-агентов поверх StarRocks: архитектура, инструменты, сценарии
- StarRocks для аналитического машинного обучения - от витрин к ML-фичам
- Производительная аналитика в StarRocks: оптимизация запросов и хранения
- Эксплуатация StarRocks в enterprise-среде: мониторинг, отказоустойчивость, безопасность
- Учебный курс по StarRocks
- StarRocks для аналитики больших данных в реальном времени
- StarRocks и Trino в контексте быстрой аналитики больших данных: архитектура, сравнение и рекомендации по выбору
- Переосмысление материализованных представлений для единого lakehouse: архитектура и практика StarRocks
- Hello: миграция с ClickHouse на StarRocks для real-time аналитики в многооблачной архитектуре
- Реалтайм-аналитика в контексте Lakehouse: сравнительный анализ StarRocks и ClickHouse, архитектура, тестирование и применение в различных секторах экономики
- StarRocks 4.0: целостная архитектура распределённой аналитики, управление данными и транзакциями, интеграция и кейсы применения
- StarRocks и Apache Iceberg в lakehouse
Моделирование данных в DWH
- Размерное моделирование и витрины данных по Кимбаллу
- 3 метода моделирования данных: Кимбалл, Инман и Data Vault
- Ликбез по методологиям проектирования хранилищ данных
- Паттерны работы с базами данных
- Лучшие практики DWH
- Хотите работать с запросами SQL как профи? - часть 1
- Хотите работать с запросами SQL как профи? - часть 2
- Современная архитектура данных: различные подходы к построению DWH
- Моделирование данных: почему игнорирование архитектуры стоит времени и денег
DBeaver

Модуль 3 - Визуализация данных, дашборды и отчетность - Business Intelligence.
Познакомимся с BI инструментами, научимся использовать Qlik, Tableau и Power BI. Разберемся с клиентской и серверной частью. А также познакомимся с методологией по созданию метрик - Pirate Metrics.
- Развитие BI-систем: тренды и движение в сторону ABI. Взгляд со стороны визуализации
- Self-service - аналитика как иерархия потребностей
- Четыре примера использования Azure Synapse
- Самообслуживаемая аналитика: архитектура, управление данными и применение в экономических секторах
- Самообслуживаемая аналитика в современных бизнес-данных
Модуль 4 - Интеграция данных и создание потоков данных (data pipelines)
- Основные функции ETL-систем
- Популярные ETL-системы: обзор, но коротко
- ETL / инструменты для хранения данных
- Cравнение нескольких ETL
- ETL: что такое, зачем и для кого
- ETL и ELT: 5 основных отличий
- ETL и ELT: разница в том, как…
- Как разработать и поддерживать функционирование высокопроизводительного конвейера данных
- Составление проектной документации для конвейеров данных
- Обзор ETL - процесса (разработка, трудности и автоматизация)
- DBT в двух словах (ссылка на курс по DBT)
- Парсинг данных: определение, преимущества и связанные процессы
- Bash-скрипт vs. хранимые процедуры vs. Традиционные инструменты ETL vs. Python-скрипт
- Важнейшие критерии при выборе Extract – Load решения для интеграции данных в DWH
- Обзор подходов к загрузке данных: Импорт, Direct Query, и ODAG
- Airbyte Open-Source ELT data pipelines. Docker Compose Install
- Текущий стек данных слишком сложен: 70% руководителей и практиков, занимающихся обработкой данных, согласны с этим
- Подробное руководство по ETL-процессам: слои, маппинги ключевых полей и управление обновлением данных
- Подробное руководство по управлению Data Pipeline: от проектирования до эксплуатации
- Загрузка данных - часть 1: Архитектурные паттерны
- Загрузка данных - часть 2: Cтратегия выбора инструмента
- Airbyte с нуля: интеграция данных и построение ETL/ELT процессов
- Airbyte для Data Engineer: разработка коннекторов данных, построение пайплайнов загрузки и интеграция с DWH Lakehouse и аналитическими системами
- Администрирование Airbyte
 Конвейеры данных. Карманный справочник 2024 (книга .pdf)
Книга посвящена передовым методам построения конвейеров данных, сбору данных из множества разнообразных источников и преобразованию их для аналитики. Дано введение в конвейеры данных, раскрыта их работа в современном стеке данных. Описаны стандартные шаблоны конвейеров данных. Показан процесс сбора данных от их извлечения до загрузки в хранилище. Затронуты вопросы преобразования и проверки данных, оркестровки конвейеров, методов их обслуживания и мониторинга производительности. Примеры программ написаны на Python и SQL и задействуют множество библиотек с открытым исходным кодом
Продукты:
- Коммерческий ETL - Microsoft Integration Services и Informatica Power Center
- Open Source ETL - Pentaho / Airflow/Nifi : учебный курс по Apache Nifi, Apache Airflow / DBT Tool: Учебный курс по dbt (Data Build Tool)
- Облачный ETL - Matillion, Fivetran, AWS Glue, Azure Data Factory


Модуль 4.5 - Оркестрация скриптов и задач
- обзор Airflow
- Топ-10 лучших практик Apache Airflow для инженеров по обработке данных
- DAG в Airflow
- AI SDK в Apache AirFlow: архитектура, интеграция LLM в оркестрацию DAG и конвейеры обработки данных
- Мультиязычный Airflow 3.0: архитектура, исполнение задач через Go SDK и перспективы развития
- Продакшн-архитектура Apache Airflow: CeleryExecutor и Redis - архитектура, развертывание, мониторинг, безопасность и практические кейсы
- Apache Airflow: архитектура, безопасность секретов и реализация ETL-конвейеров на основе PostgreSQL и S3/MinIO
- Data Lake на S3-совместимых хранилищах: архитектура, конфигурации Airflow и реализация ETL-процессов с MinIO и Yandex Object Storage
- Масштабирование Python-задач или как Airflow управляет Dask-кластером
- Декораторы в Apache Airflow и мотивация использования
- Мультитенантное развертывание Apache Airflow: архитектура, безопасность и управление ресурсами в условиях IaC, Kubernetes, CI/CD и интеграций с dbt - конкурентный анализ
- Apache Airflow: теоретические основы, архитектура и эксплуатация оркестрации пакетных процессов
- Celery в Apache Airflow и мотивация использования очередей
- Переменные в Apache Airflow: концепции, архитектура и практические сценарии применения
- Разработка плагинов для Apache AirFlow
- Сериализация в Apache Airflow: принципы, архитектура и реализация, форматы данных и влияние на производительность и миграцию
- Управление кодом и развёртыванием в Apache Airflow: архитектура оркестрации, структуры проектов и практические кейсы

Модуль 5 - Облачные вычисления (Cloud Computing)
Модуль 6 - Облачное Хранилище данных
Центр вселенной в аналитике обычно это хранилище данных или платформа данных. Как правило это аналитическое решение с MPP архитектурой и часто используется облачные решения. Мы познакомимся с одним из самых популярных решений Amazon Redshift и узнаем о других аналогах. Также рассмотрим кейсы миграции традиционных решений в облака.
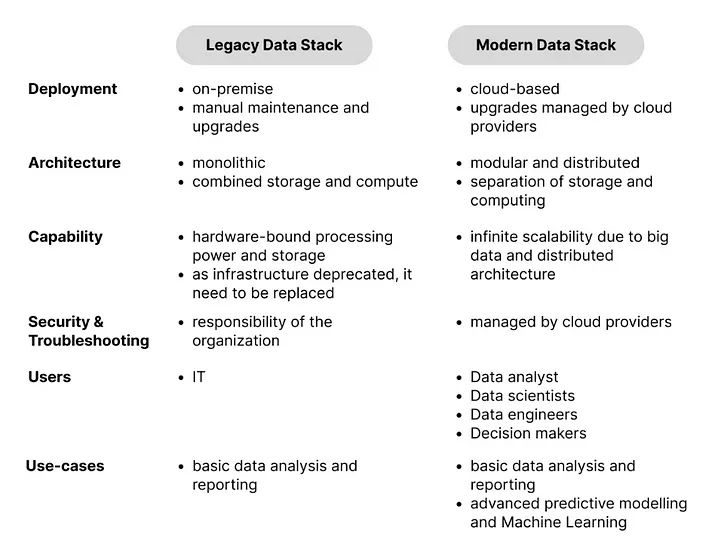
- Современная архитектура хранилища данных
- Использование облачного хранилища данных и важность управление данными
- Функциональная data engineering - современная парадигма пакетной обработки данных
- 4 ключевых шаблона для загрузки данных в хранилище данных
- Cloud agnostic или как правильно построить облачную платформу данных
- Строительные блоки современной платформы данных
- Конец эпохи корпоративных хранилищ данных
- Я потратил 5 часов на то, чтобы понять как компания ClickHouse создала свое внутреннее хранилище данных
- Как я создал целую платформу данных всего за одну неделю
- Сравнение инструментов пакетной обработки данных: анализ производительности
- Обработка данных. Архитектурные шаблоны
- Моя платформа управления данными
- Типовые риски, которые можно не учесть при построении современных хранилищ данных
Amazon S3

- Объектное хранилище S3: ключ к масштабируемому и надежному хранению данных
- Что такое Amazon S3?
- Глубокое погружение в новые таблицы Amazon S3
- Объектное хранилище в облаке с открытым исходным кодом, совместимое с S3
- Как проверить файл AWS S3 на наличие каких-либо угроз в Nodejs
- Как пустой бакет S3 может разорить Вас
- Python — управление бакетами S3 с помощью Python
- Python — Работа с AWS S3 с помощью Boto3 от Python
- Межрегиональная репликация AWS S3
- Amazon Redshift и традиционные хранилища данных
- Разделение вычислений и хранения в Greenplum: опыт использования S3 и проекта Yezzey
- Миграция с монолитного Greenplum на Lakehouse-архитектуру с Iceberg и S3: опыт страховой компании
- S3 как фундамент современного хранилища данных - архитектура и эксплуатация
- Полное руководство по использованию S3 для хранилищ данных
- Развёртывание MinIO on-premise и в Kubernetes: production-конфигурации
- Интеграция MinIO с Spark, Trino, ClickHouse и BI-системами
- Безопасность и управление доступами в MinIO: политики, шифрование и аудит
- MinIO как корпоративное S3-хранилище: архитектура, отказоустойчивость и масштабирование
- MinIO в аналитической платформе: хранение lakehouse, Iceberg, Delta, Parquet
Google BigQuery

- Интеграция данных с Google BigQuery
- Учебное пособие по BigQuery: подробное руководство
- Учебное пособие по BigQuery – как повысить гибкость вашего бизнеса
- Учебный курс по BigQuery
Azure

- Создание безопасной конфигурации для служб Azure SQL
- Управление ресурсами Azure с помощью задач автоматизации
- Интеграция данных с Microsoft Azure
- Современная промышленная аналитика Интернета вещей в Azure
- Инженерия данных с Databricks: что, почему и как?
- Обзор Databricks. Что облачный продукт может дать начинающим специалистам
- Руководство по Azure Databricks для начинающих
- Azure Databricks для начинающих
- Как начать работу с Databricks
- Учебный курс по Databricks
- Платформы данных 3 поколения: Первый взгляд на Microsoft Fabric
Snowflake
- создавать хранилище данных
- работать с данными в браузере (SnowSight) используя SQL или Python (SnowPark)
- возможность создавать веб-приложения на базе Streamlit (open source решение, которое Snowflake купил)
- создавать Stored Procedures прям как в PL/SQL в Oracle или T-SQL в SQL Server (можно на SQL, можно и на другом языке). Работает отлично - бесплатная замена dbt для трансформации данных
- ставить на расписание ваши запросы (jobs) с использованием Tasks
- интеграция с Apache Iceberg, свой Iceberg каталог Polaris
- поддержка стриминга через Pipes, Dynamic таблиц
- своя кривая LLM Arctic
- возможность хостить контейнеры (сам еще не проверял)
- создавать Data Apps на любой цвет и вкус (для монетизации своих данных)
- Data Sharing, большой маркетплейс различных приложений, вендоров, данных
Databrics

Модуль 7 - Знакомство с Apache Spark
Apache Spark является одним из самых популярных инструментов для Инженера Данных. Данный модуль мы посвятим знакомству с Apache Spark и рассмотрим его функциональность. Потренируемся создавать RDD и Data Frame, рассмотрим основные операции и кейсы использования.
- Что такое Spark и с чем его едят?
- Знакомство с Apache Spark
- Apache Spark: гайд для новичков
- Быстрый старт в Apache Spark ML
- Apache Spark Tutorial. PySpark и DataFrame. Как установить?
- Apache Spark для аналитических хранилищ: обработка больших данных и оптимизация
- Apache Spark: архитектура, API и обработка больших данных - теория и практика, стриминг, ML и графовые вычисления, интеграции, экономика владения и направления развития
- Интеграция Apache Spark с облачными хранилищами
 Spark в действии (книга .pdf)
Анализ корпоративных данных начинается с чтения, фильтрации и объединения файлов и потоков из многих источников. Механизм обработки данных Spark способен обрабатывать эти разнообразные объемы информации как признанный лидер в этой области, обеспечивая в 100 раз большую скорость, чем например Hadoop. Благодаря поддержке SQL, интуитивно понятному интерфейсу и простому и ясному многоязыковому API вы можете использовать Spark без глубокого изучения новой сложной экосистемы. Эта книга научит вас создавать полноценные и завершенные аналитические приложения. В качестве примера используется полный конвейер обработки данных, поступающих со спутников NASA. Для чтения этой книги не требуется какой-либо предварительный опыт работы со Spark, Scala или Hadoop.

Модуль 8 - Создание решения для Big Data с использованием Hadoop и Spark
Hadoop является флагманом решений Big Data. В данном модуле, мы попробуем решить задачу, которая не под силу традиционными инструментам ETL/DW, это поможет вам понять разницу между DW и BigData и вы точно будете знать, почему мы используем Hadoop. В качестве инструмента управления мы воспользуемся Spark который уже будет предустановлен на Amazon Elastic Map Reduce. В качестве упражнения, мы будем использовать PySpark, чтобы читать неструктурированные логи и извлекать из них ценную информацию.
- Платформа Big Data: от стартапа до крупной технологической компании
- Выполнение распределенного перетасовывания без системы MapReduce
- Как построить современное аналитическое хранилище данных на базе Cloudera Hadoop
- Как создать и удалить таблицы в Apache Hadoop c использованием PySpark
- Изучаем Hadoop на практике: настройка и масштабирование Hadoop
- Data Lake – от теории к практике. Сказ про то, как мы строим ETL на Hadoop
 Алгоритмы и структуры для массивных наборов данных [2023] Меджедович Дж., Тахирович Э
Стандартные алгоритмы и структуры при применении к крупным распределенным наборам данных могут становиться медленными — или вообще не работать. Правильный подбор алгоритмов, предназначенных для работы с большими данными, экономит время, повышает точность и снижает стоимость обработки. Книга знакомит с методами обработки и анализа больших распределенных данных. Насыщенное отраслевыми историями и занимательными иллюстрациями, это удобное руководство позволяет легко понять даже сложные концепции. Вы научитесь применять на реальных примерах такие мощные алгоритмы, как фильтры Блума, набросок count-min, HyperLogLog и LSM-деревья, в своих собственных проектах.
Модуль 9 - Data Lake
Знакомство с понятием Озера Данных и его создание с помощью инструментов AWS. Существует много версий про назназначение Озера Данных и про его роль в Аналитической экосистеме. В данном модуле мы познакомимся с понятием Озера данных, его ролью в экосистеме, рассмотрим типовые архитектуры построения решений с использованием Озера Данных и/или Хранилища данных. В качестве решений будем использовать продукты AWS.
- Что такое Data Lake
- Что такое «озера данных» и почему они должны быть чистыми?
- Нужно ли нам озеро данных? А что делать с хранилищем данных?
- Data Lakehouse vs Data Warehouse vs Data Lake – Сравнение платформ данных
- Про решения (Arenadata)
- Озеро данных, хранилище данных и база данных... В чем разница?
- Архитектура озера данных: как создать хорошее озеро данных
- Успешное внедрение озера данных с помощью организованности
- Озеро данных нового поколения: увеличение производительности в 10 раз!
- Озеро данных vs хранилище данных
- Какое решение по хранение и анализу данных лучше всего выбрать
- Data Lake с помощью Debezium, Kafka Connect и Apache Iceberg sink
- Руководство по качеству корпоративных данных «Кто за что отвечает»
- Ландшафт разработки данных с открытым исходным кодом к 2025 году
- Введение в современную инфраструктуру обработки данных
- DWH и Data Lake - понятия взаимоисключающие или взаимодополняющие?
- Как не ошибиться при создании Data Lake / DWH / BI
- Эволюция стратегий репликации данных: от ручных методов к автоматизированным платформам на базе Debezium и Apache Kafka
- DuckLake (DuckDB): «SQL как Lakehouse-формат». Подробный разбор для команды DWH/BI
- Apache Iceberg и Parquet: архитектура Data Lake 2.0 для высокопроизводительной аналитики
- Современная архитектура данных: концепции Data Warehouse, Data Lake, Data Lakehouse и Data Mesh - компоненты, интеграция и принципы выбора
- Data Lakehouse vs DWH - выбор архитектуры под бизнес-сценарии
- Self-Service Analytics в Lakehouse: семантические слои и доступ бизнес-пользователей
- Проектирование Open Data Lakehouse - стек, компоненты, типовые архитектуры
- DuckDB с нуля: встроенная аналитическая база данных
- DuckDB для Data Engineer
- DuckDB для аналитических платформ
Архитектура медальона описывает ряд слоев данных, которые соответствуют качеству данных, хранящихся в гибридном решении "хранилище и озеро данных". Ведущие вендоры рекомендуют использовать многоуровневый подход к созданию единого источника истины для корпоративных продуктов данных. Эта архитектура гарантирует атомарность, согласованность, изоляцию и устойчивость, так как данные проходят через несколько уровней проверок и преобразований, прежде чем они будут сохранены в схеме, оптимизированной для эффективной аналитики. Термины бронзовый (необработанные), серебряный (проверенные) и золотой (обогащенные) описывают качество данных в каждом из этих уровней.
Если вы строите озеро данных (data lake) или его улучшенную версию lake house (используете формат таблиц Delta, Iceberg), то вы разделяете хранение по уровням хранения данных:
- Архитектура медальона: лучшие практики по управлению бронзовым, серебряным и золотым слоями
- Необычное золото: освоение архитектуры медальона
- Качество данных не должно быть сложным
Apache Parquet, Hudi, Iceberg и Delta Lake
- Распределенная модель Iceberg легко масштабируется, а журнал транзакций Delta Lake может создавать узкие места за пределами Spark.
- Эволюция схемы? Iceberg позволяет изменять столбцы без перезаписи данных, а Delta требует явных действий по слиянию.
- Разделение? Айсберг автоматически адаптируется; Delta нуждается в предварительно определенных разделах, что часто требует дорогостоящей перезаписи.
- Преимущество в производительности? Iceberg представляет файлы Puffin для расширенной оптимизации запросов, чего не хватает Delta Lake.
- Hudi, Iceberg и Delta Lake: сравнение табличных форматов для озера данных
- Информационные продукты: Аргументы против архитектуры Medallion
- Комплексная система обработки данных на основе реальных данных с использованием Kafka, Spark, Airflow, Postgres и Docker
- Внедрение архитектуры Lakehouse в компании из сегмента retail DIY: практический кейс
- Выбор оптимальных форматов данных
Apache Iceberg

- Почему стоит выбрать функции Apache Iceberg
- Что такое Apache Iceberg? Ключевые характеристики и основные преимущества
- Что такое Apache Iceberg
- Введение в Apache Iceberg
- Покойтесь с миром, каталоги Iceberg … или нет?
- Понимание модели согласованности Apache Iceberg, часть 1
- Понимание модели согласованности Apache Iceberg, часть 2
- Apache Iceberg: Формат открытых таблиц для Data Lakehouse и потоковой передачи данных
- Каталоги Iceberg: инструкция для дата-инженеров
- Apache Iceberg: Hadoop современного стека данных?
- За Apache Iceberg – будущее. Чего ждать от 2025 года?
- Каталоги Iceberg: Руководство для инженеров по обработке данных
- Apache Iceberg как фундамент современной Data-инфраструктуры. Подробное руководство по внедрению, лучшим практикам и управлению рисками
- Lakekeeper Catalog for Apache Iceberg — практическое руководство по внедрению и эксплуатации
- Полное руководство по использованию Iceberg для хранилищ данных
- Apache Iceberg как открытый табличный формат для гигантских аналитических наборов данных
- Apache Iceberg: архитектура, управление метаданными и транзакционность в Data Lakehouse
- Apache Iceberg: архитектура, метаданные, каталоги и транзакции в контексте Trino - концептуальный обзор
- Проблемы потоковой передачи в озеро данных и как Apache Iceberg их решает
- Iceberg и Lakehouse: архитектура нового поколения управления данными, транзакции и версионирование, интеграции, кейсы и сравнительный анализ с Delta Lake и Apache Hudi
- Нулевое копирование между Apache Kafka и Apache Iceberg: архитектура, управление данными и эволюция lakehouse
Apache Parquet

- Выборочное удаление столбцов для повышения эффективности хранения в озерах данных (Apache Parquet)
- Apache Parquet
- Что такое Parquet? Обзор основных преимуществ и случаев использования
- Глубокое погружение в Apache Parquet: Эффективное хранение данных для аналитики
- Как Apache Iceberg победил в войне за открытые таблицы
- Мифы вокруг Parquet: что есть правда, а что – ложь?
- Визуализация файлов Parquet с помощью Apache Superset, Trino или PrestoSQL
- Petastorm: Простой подход к моделям глубокого обучения в формате Apache Parquet
- Производительность Python и Parquet
- Использование плагинов для загрузки файлов Parquet из S3 в Pinot
- Как генерировать файлы Parquet на Java
- Конвертирование файлов Ethereum ETL в формат Parquet
- Apache Parquet: Как стать героем, используя формат колоночно-ориентированных данных с открытым исходным кодом
- Файлы Parquet повсюду
Apache Hudi

- Что такое Apache Hudi?
- Интеграция Apache Hudi и Apache Flink для новых Data Lake
- Data Lakehouse: построение Data Lake нового поколения с помощью Apache Hudi
- Освоение формата открытых таблиц: подробное руководство по Apache Iceberg, Hudi и Delta Lake
- Apache Hudi в AWS Glue
- Битва форматов файлов: Parquet, Delta Lake, Iceberg и Hudi
- Как определить собственную логику слияния с помощью Apache Hudi
- Hudi: Создайте свои JAR с помощью патчей - Rocky Linux в Docker
- Использование таблиц Apache Hudi и Iceberg в Databricks с помощью Apache XTable
- Hudi: Понимание файлов JAR Apache Hudi в AWS EMR и AWS Glue
Модуль 10 - Решение задачи по стримингу данных.
Apache Flink

- Рецепт платформы потоковой обработки данных на Apache Flink (конференция Smartdata 2024)
- Lookup Join в Flink 2.0: архитектура, кэширование и применение для обогащения потоковых данных
- ETL-конвейер на базе Flink CDC с YAML-конфигурацией: архитектура, управление схемами и операционная эксплуатация
- Гибридные источники данных в Apache Flink: архитектура, реализация и влияние на задержку, согласованность и устойчивость системы
- Побочные выходные потоки в DataStream: принципы, архитектура, реализация и применение
- Сериализация в Apache Flink и её влияние на производительность
- Расширенные функции Apache Flink
- От Lakehouse к Streamhouse: архитектура реального времени, LSR‑треугольник и стек Flink-Fluss-Paimon-StarRocks
Debezium

- Что такое Debezium: подробная инструкция по применению
- Потоковая передача данных Postgres с помощью Apache Kafka и Debezium | ETL в режиме реального времени
- Планирование миллионов сообщений с помощью Kafka и Debezium
- Анализ изменения данных с помощью Debezium и Apache Pinot
- Использование плагина PostgreSQL pgoutput для сбора данных об изменениях с помощью Debezium в Azure
- Дашборд Grafana: мониторинг работы коннектора Debezium - MySQL
- Потоковая передача данных из PostgreSQL в Kafka с помощью Debezium
- Раскройте возможности CDC с помощью Debezium
- Репликация данных в режиме реального времени с помощью Debezium и Python
- Debezium с нуля: Change Data Capture и потоковая репликация данных
- Debezium для Data Engineer
- Эксплуатация Debezium
kafka

- Apache Kafka: обзор
- Apache Kafka: основные операции
- Apache Kafka – архитектура кластера
- Коннекторы Kafka
- Apache Kafka: потоковая интеграция данных для аналитических платформ
- Diskless Topics и KIP-1150: эволюция Kafka к облачному многослойному хранению - архитектура, совместимость, производительность и экономический эффект
- Гарантии доставки сообщений в распределённых системах: от At-Most-Once до Exactly-Once - архитектура, паттерны и практики
- Kafka 4.0: комплексный обзор архитектуры, управления метаданными, безопасности и экосистемы - миграции, совместимость API и прикладные сценарии
- Потоковое обогащение контекста для многоагентных LLM через MCP-серверы и Kafka: архитектуры, протоколы и безопасность
- Управление топиками в Apache Kafka: жизненный цикл, очистка и безопасность - теория и практика
- Ручная фиксация смещений в Apache Kafka: теоретические основы, механизмы фиксации (commitSync/commitAsync) и транзакционная согласованность; влияние KIP-1094 на API потребителя, паттерны, мониторинг и миграционные аспекты
- CAP-теорема и устойчивость к разобщению в кластерах Apache Kafka: архитектура, лидерство, репликация и миграция к KRaft
- FastStream для Apache Kafka: архитектура, интеграции и сценарии применения в потоковой обработке данных
- Purgatory-механизм Apache Kafka: архитектура, реализация и применение в асинхронной обработке сообщений
- Мультиарендная архитектура Apache Kafka на Kubernetes с Strimzi: принципы, управление, безопасность и внедрение
- Обратное давление в потоковой обработке на базе Apache Kafka: принципы, архитектура и практики устойчивого конвейера
- Apache Kafka: архитектура публикации данных, эксплуатационные механизмы и отраслевые применения
- Изоляция транзакций в Apache Kafka при потреблении сообщений
Другое:
- Apache Sqoop
- Ландшафт потоковой передачи данных
- CDC от источника до хранилища: как в банке Синара построили CDC с применением продуктов Arenadata (конференция Smartdata 2024)
- Понимание процесса CDC
- Change Data Capture (CDC) — захват изменений данных: как работает, где применяется, какие есть подходы, ошибки и риски
Модуль 11 - Задачи Машинного Обучения глазами инженера данных.
- Учебный курс по MLOps и Data Science (ML, AI)
- Единая платформа данных и MLOps: от управления до развертывания моделей в продакшн
Модуль 12 - Лучшие практики инженера данных
- Построение аналитических архитектур для приложений, работающих в режиме реального времени
- Типы архитектуры платформ данных
- Руководство по созданию платформы данных
- Чему я научился, создавая платформу данных с нуля в течение года
- Роли и обязанности членов команды по работе с продуктами данных
- Зачем платформе данных нужен пользовательский интерфейс?
- Четыре столпа культуры данных
Модуль 13 - Data Vault
- Введение в Data Vault
- Основы Data Vault
- Все о Data Vault (часть 1 - Знакомство с Data Vault)
- Все о Data Vault (часть 2 - Компоненты Data Vault)
- Все о Data Vault (часть 3 - Даты окончания действия и основы соединений)
- Все о Data Vault (часть 4 - Таблицы Связей)
- Все о Data Vault (часть 5 - Методика загрузки)
- Data Vault 2.0. В каких случаях внедрять, разбор основных проблем применения методологии при построении DWH на Greenplum (конференция Smartdata 2024)
- Data Vault 2.0: секреты эффективного хранения данных
- Построение высокопроизводительного хранилища данных на Greenplum с применением методологии Data Vault 2.0: от архитектурных принципов до промышленной эксплуатации
- Внедрение методологии Data Vault на Greenplum с использованием DBT
- Data Vault 2.0: Передовая методология построения гибких и масштабируемых хранилищ данных. Полное руководство по внедрению от экспертов
- Data Vault с нуля: моделирование корпоративного хранилища данных
- Data Vault для Data Engineer
- Архитектура Data Vault
 Building a Scalable Data Warehouse with Data Vault 2.0 (книга .pdf)
Data Vault был изобретен Дэном Линстедтом в Министерстве обороны США, и этот стандарт успешно применялся к проектам по хранению данных в организациях разных размеров, от малых до крупных корпораций. Благодаря своей упрощенной конструкции, стандарт Data Vault 2.0 помогает предотвратить типичные сбои в хранении данных. Книга «Building a Scalable Data Warehouse with Data Vault 2.0» охватывает все, что нужно знать для создания масштабируемого хранилища данных от начала до конца, включая презентацию метода моделирования Data Vault, который обеспечивает основу для создания технического уровня хранилища данных. В книге обсуждается, как построить хранилище данных постепенно, используя гибкую методологию Data Vault 2.0. Кроме того, читатели узнают, как создать входной уровень (stage layer) и уровень представления (presentation layer - data mart) архитектуры Data Vault 2.0, включая лучшие практики внедрения. Опираясь на многолетний практический опыт и используя многочисленные примеры и простую для понимания структуру, Дэн Линстедт и Майкл
Модуль 14 - Дополнительные структуры
Trino и Presto
 Trino - The Definitive Guide 2023 Second Edition (книга .pdf)
- Что такое Trino и почему он незаменим при обработке Big Data
- Понимание архитектуры Trino: раскрываем весь потенциал распределенных SQL-запросов
- 7 уроков, которые я вынес в процессе переноса кода dbt из Snowflake в Trino
- Аналитика: обработка данных с помощью Trino
- Группы ресурсов в шлюзе Trino Chango
- Trino vs Apache Spark
- Создание облегченной конфигурации Trino
- Случаи использования Trino
- Концепты Trino
- Развертывание Trino
- Trino в контейнере Docker
- Trino на Kubernetes с помощью Helm
- Веб-интерфейс Trino
- Использование Trino совместно с Dataproc
- Кластеры высокой доступности Trino в Goldman Sachs
- Освоить Presto за 8 минут
- Процесс миграции DWH из состояния AS IS (Greenplum) в целевое состояние TO BE (Trino, Iceberg REST Catalog, Object Storage) (конференция Smartdata 2024)
- Отказоустойчивость исполнения запросов в Trino: архитектура, политики повторов и управление ресурсами в распределённых SQL-системах
- Trino в архитектуре MPP для анализа больших данных: принципы, коннекторы, хранилища и применение в современных аналитических экосистемах
- Trino и dbt: сравнительный обзор архитектур, интеграций и практических сценариев ELT/ETL в распределённых системах аналитики
- Безопасность кластера Trino: архитектура, политика доступа и управление конфигурациями и секретами в распределённых системах
- Trino: архитектура, коннекторы и каталоги как основа масштабируемой интеграции данных в распределённых системах
- Использование удалённых объектных хранилищ и архитектура LakeHouse в Trino
- Spill-механизм в Trino: архитектура, управление памятью, параметры настройки и практические рекомендации
- Trino: архитектура параллельной аналитики, коннекторы и протоколы доступа к данным, интеграции и сценарии применения
- Декомпозиция технических компонентов кластера Trino и их взаимодействие
- Trino в архитектуре данных: концепции, компоненты, границы применения и практические рекомендации по интеграции и проектированию конвейеров в разных секторах экономики
- Управление памятью в кластере Trino: архитектура, механизмы, мониторинг и стратегии оптимизации для снижения OOM и повышения производительности
- Проблемы бесконечного масштабирования кластера и их решение через Trino Gateway
- Trino в Data Lakehouse: федеративные запросы и работа с Iceberg
- Trino с нуля: установка, подключение источников и первые аналитические запросы
- Оптимизация производительности Trino: память, кэширование, cost-based optimizer
- Эксплуатация Trino в промышленной среде - безопасность, мониторинг, отказоустойчивость
- Плагинная архитектура Trino: принципы, реализация и перспективы экосистемы
- Разработка плагина Trino для пользовательского типа данных: архитектура, реализация, тестирование и внедрение
- Trino: архитектура, планирование и оптимизация выполнения запросов - концептуальный обзор механизмов pushdown, динамических фильтров, стратегий соединений и интеграции коннекторов
Дата инженерия не для дата инженеров
- Проект «Инженерия данных» для начинающих — Пакетная обработка данных
- Инжиниринг данных — упражнения
- Полное руководство по происхождению данных в 2022 году
- Как и зачем «Ашан» построил платформу для работы с Big Data в публичном облаке
- Продаем «Дом озера данных»
- Что такое область подготовки данных?
- Zero-ETL, ChatGPT и будущее Data Engineering
- Управление сбоями системы: инструкция для команд по работе с данными
CI/CD для пайплайнов данных
- Что такое методология разработки CI/CD
- Среда разработки данных с CI/CD
- CI/CD и инциденты в аналитике
- Что такое конвейер CI/CD?
Data-driven компания:
- Развитие грамотности в сфере данных, ориентированных на людей
- Становясь Data-Driven организацией: скрытые возможности и проблемы
- Как мы посчитали уровень Data Driven’ности в компании и вклад в него каждого аналитика?
- DataMart
- Тестирование
- Ruff: этот линтер работает невероятно быстро по сравнению с традиционными линтерами Python. Почему? Он написан на Rust. Речь идёт об ускорении в 10-100 раз.
- UV: ещё один инструмент, написанный на Rust - быстрый и надёжный установщик пакетов Python. UV как более быстрая альтернатива Poetry способная значительно ускорить установку зависимостей.
- Polars: эта библиотека DataFrame конкурирует с Pandas по производительности. И угадайте что? Под капотом - Rust.
- Maturin: делает создание Python-расширений на Rust предельно простым.
- RUST и инжиниринг данных - часть 1
- RUST и инжиниринг данных - часть 2
- RUST и инжиниринг данных - часть 3
- RUST и инжиниринг данных - часть 4
Модуль 15 - Data Mesh
Любая компания собирает и обрабатывает огромное количество данных, стараясь извлечь из них максимальную ценность, используя, в частности «озера данных». Вместе с тем, в классическом подходе к работе с Data Lake имеются принципиальные ограничения при централизованном развитии хранилища – чем больше интегрированных систем и данных, тем больше требуется ресурсов на их поддержку и развитие, а значит, возникает больше кросс-зависимостей, что означает лавинообразный рост ответственности для определенных групп сотрудников компании. В итоге, например команда работы с Data Lake, становится бутылочным горлышком процесса доставки данных от источников к потребителям. Решение – распределенная структура управления данными (Data Mesh), позволяющая разделить ответственность: владение данными (генерация, описание, контроль качества, публикация) сосредоточено в бизнес-функциях, а CDO выступает в роли провайдера инструментария хранения, обработки данных, а также методологии управления ими. Особое внимание уделено процессам Data Governance, обеспечивающим взаимодействие между узлами распределенной структуры: внедрение каталога данных, определение ландшафта данных, роли владельца данных, общие политики для всех узлов.
Что такое Data Mesh?
- Ценность виртуализации данных в Data Mesh
- Data Mesh: что это такое и для чего он нужен инженерам
- Введение в Data Mesh
- Data Mesh: Топологии и гранулярность доменов
- Data Mesh с нуля: децентрализованная архитектура данных
- Data Mesh для архитекторов данных
- Внедрение Data Mesh в компании

Модуль 16 - Change Data Capture (CDC)
Эти системы позволяют наполнять централизованные хранилища/озера извлекая данные из источников по мере их изменения там. Вот хороший базовый обзор этой концепции и систем:
- Введение в систему CDC — эффективный способ репликации транзакционных данных в озеро данных
- Архитектура системы CDC
- Как выбрать для своего конвейера данных максимально эффективную архитектуру
- Исторический обзор: как CDC-инструменты и подходы развивались на практике
- Обработка данных в режиме реального времени с помощью CDC и использование Change Data Capture архитектуры, управляемой событиями
Модуль 17 - Каталог данных (Data Catalog)
- Каталог данных — почему без него непросто и как всё организовать с максимальной пользой
- Каталог данных на примере DataHub. Часть I
- Архитектура Data Hub: новый тренд в области интеграции данных?
- DataHub: платформа метаданных, разработанная в LinkedIn
- Обзор DataHub Project — Open-Source каталог данных. Установка Docker и настройка
- Метаданные в BI и OpenMetadata
- Не потеряться в данных: как DataHub спасает аналитику в эру Big Data
- Моделирование данных как языка бизнеса
- Защита данных как непрерывный процесс и контекст современного бизнеса
- Управление неструктурированными данными в корпоративной среде: архитектура ECM/DAM, AI-конвейеры и аналитика как основа принятия решений
- Управление метаданными и Data Catalog в корпоративной архитектуре данных: принципы, инструменты и практические сценарии
- Управление качеством данных в современных организациях: архитектуры, интеграция и путь к Data Mesh
- DataHub как открытая платформа метаданных современного data stack
Модуль 18 - Мониторинг данных
- Prometheus + Grafana. Настраиваем 4 golden signals
- Что такое Grafana?
- Введение в Grafana: гайд по мониторингу и визуализации данных специально для новичков
- Начало работы с Grafana
- Введение в мониторинг с помощью Prometheus и Grafana
- Создайте свой первый дашборд в Grafana: пошаговая инструкция
- Начало работы с Grafana: советы для начинающих - создание дашбордов, подключение источников данных и многое-многое другое
- Впечатляющие возможности Grafana: подробная инструкция по проведению мониторинга и визуализации данных
- Kubernetes: отслеживание запросов с помощью AWS X-Ray и источника данных Grafana
- Установка Grafana
- Основы Grafana
- Prometheus и Grafana: принципиально новый способ мониторинга работы приложения Spring Boot
- Инициализируйте Grafana внутри контейнера Docker вместе с предварительно созданным дашбордом
- Подробное руководство по мониторингу в DevOps: Grafana, Prometheus и др.
- Spring Boot c Prometheus и Grafana. Локальная установка и настройка
- Метрики Docker с помощью Prometheus и Grafana
- Мониторинг метрик Kafka с помощью Prometheus и Grafana
- Prometheus vs Grafana в AWS Cloud
- Prometheus с нуля: архитектура, модель данных и первые системы мониторинга
- Prometheus для инженеров данных и DevOps: PromQL и анализ временных рядов
- Prometheus в observability-архитектуре: микросервисы, Kubernetes и data-платформы
- Production-архитектура Prometheus: масштабирование и long-term storage
- Grafana для observability и мониторинга
- Grafana для инженеров данных и аналитиков
- Grafana: архитектура, источники данных и визуализация
- Production-эксплуатация Grafana
Дополнительно
- Учебный курс по dbt (Data Build Tool)
- Глоссарий по управлению данными (Data Governance), хранилищам данных (DWH) и бизнес-аналитике (BI)
- Паттерны архитектуры ПО в инженерии данных
- Мой первый Data Lake (презентация, .pdf)
- Как устроена платформа управления данными в Яндекс.Маркет (презентация, .pdf)
- Kappa и Lambda. Обзор баззвордов архитектур (презентация, .pdf)
- Новые виды архитектур для организации современной инфраструктуры данных
- Прошлое, настоящее и будущее Архитектуры данных
- Десять красных флажков, указывающих на то, что Ваша аналитическая программа обречена на провал
- CAP теорема
- Оптимальный способ обработки чрезвычайно больших массивов данных (> 100 ТБ)
- 25 вопросов и ответов по терминам REST API на собеседовании по вакансии системного аналитика
- Полезные команды Git, которые стоит взять на вооружение
- Сводные таблицы Greenplum
- Федеративное обучение и конфиденциальный анализ данных: теория, практика и вызовы внедрения
- Введение в наиболее важные аспекты современной наблюдаемости данных
- Обзор новых книг от O’Reilly: что почитать дата-инженерам, аналитикам и архитекторам
- Комплексная безопасность среды Business Intelligence: стратегии, риски и практические решения для современных предприятий
- DAR - методология, которая превращает данные в ценные сведения и эффективные бизнес-решения
- Autobase for PostgreSQL: как кардинально упростить управление БД, снизить риски и сократить расходы до 70% без потерь в надежности
- Write–Audit–Publish (WAP): как спроектировать «чистые» пайплайны данных
- Jupyter Notebook в средах WSL и Docker: архитектура, развёртывание и управление инфраструктурой
- Целостность данных в реляционных СУБД: ключи, ограничения и инструменты - от теории к промышленной практике
- OLAP — не предел_ как мы «пошли своим путем»
- Облачная архитектура Magnit F&R: высоконагруженная платформа прогнозирования и пополнения для цепочек поставок в реальном времени
- Динамическое отсечение разделов (Dynamic Partition Pruning) в Spark SQL: архитектура, алгоритмы и лучшие практики оптимизации пакетных запросов
- DWH и BI для маркетплейсов: архитектура омниканальной аналитики и 80% снижение ошибок отгрузок
- Согласованность без двойной записи в распределённых микросервисах: транзакционные паттерны и гарантии доставки на базе Kafka
- Нормализация vs Денормализация_ Mongo, Postgres и реальная жизнь
- Агентная аналитика в lakehouse-инфраструктуре: архитектура, протоколы взаимодействия и стратегии внедрения
- Apache Gravitino: концептуальная архитектура единой модели метаданных, геораспределённая видимость и дорожная карта развития
- Наблюдаемость данных как двигатель цифровой трансформации: архитектура, управление качеством и демократизация самообслуживаемой аналитики
- Контроль качества данных в современных конвейерах и архитектуре lakehouse: паттерны, принципы и практика внедрения
- Управление метаданными и Data Catalog как основа ценности данных
- Гражданская разработка в цифровой трансформации: архитектура технологических стеков, управление и жизненный цикл решений
- Автоматизация закупок в крупной розничной сети
- Автозаказ: концепция, архитектура и управление запасами в цифровой экосистеме бизнеса через прогнозирование спроса и интеграцию систем
- Архитектура данных, управляемая метаданными: концепции, модели, внедрение и перспективы развития
Elasticsearch
- Исправление ошибок cluster_block_exception в Elasticsearch: пошаговая инструкция
- Как устранить ошибку cluster_block_exception в Elasticsearch
- Что делать с ошибками Cluster Block Exception, возникающими в Elasticsearch
- Эффективное управление журналами Kubernetes с помощью Fluentd и Elasticsearch
- Бесплатный инструмент для создания и тестирования анализаторов Elasticsearch
- Советы и рекомендации по индексации Elasticsearch
- Шпаргалка по проектированию системы: ElasticSearch
- Потенциал Elasticsearch: глубокое погружение в эффективность поиска
- Apache Doris – эквивалентная замена Apache Hive, Elasticsearch и PostgreSQL
- Индексирование данных в Elasticsearch с помощью Python
- Подключение к Elasticsearch с помощью Python: ключевые факторы успеха
- Создание уведомлений в Elasticsearch: Оповещение об отсутствии записей в журналах
- Spring и Elasticsearch — Встраивание функции поиска в приложение
- Elasticsearch
- Как создать приложение для поиска с автозаполнением с помощью Elasticsearch и NestJS
- Как интегрировать Elasticsearch с DRF

Компоненты аналтитического решения сгруппированы по типам и назначению.


Статья Learnings after 4 years working with +50 companies on data engineering projects в переводе от Дмитрия Аношина (канал Инжиниринг данных)